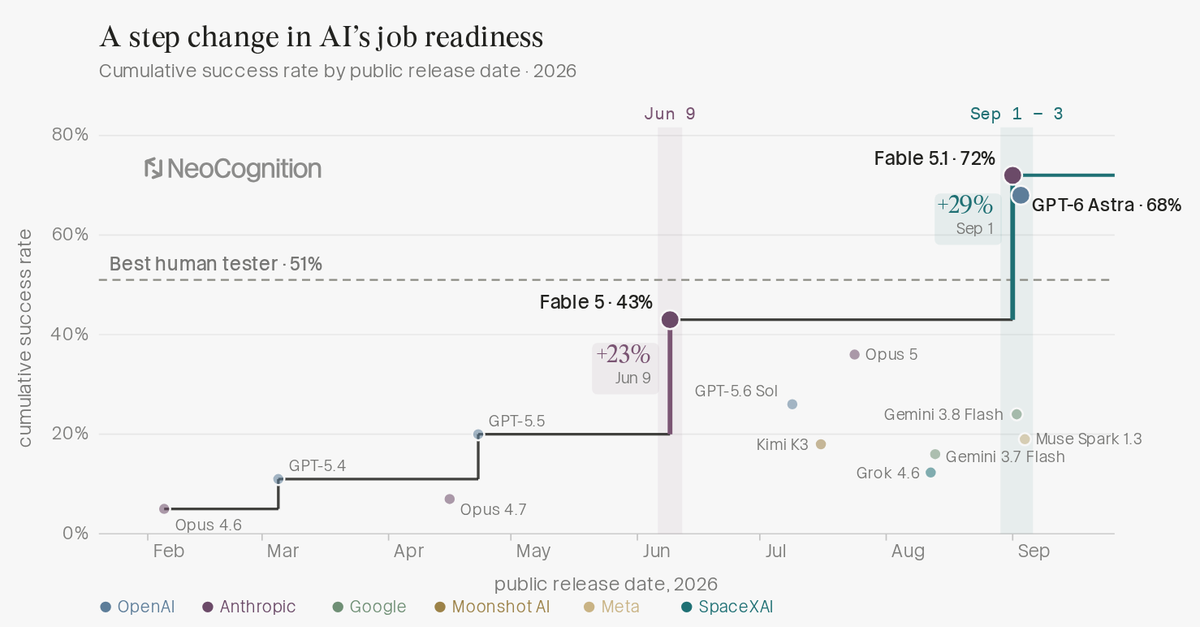
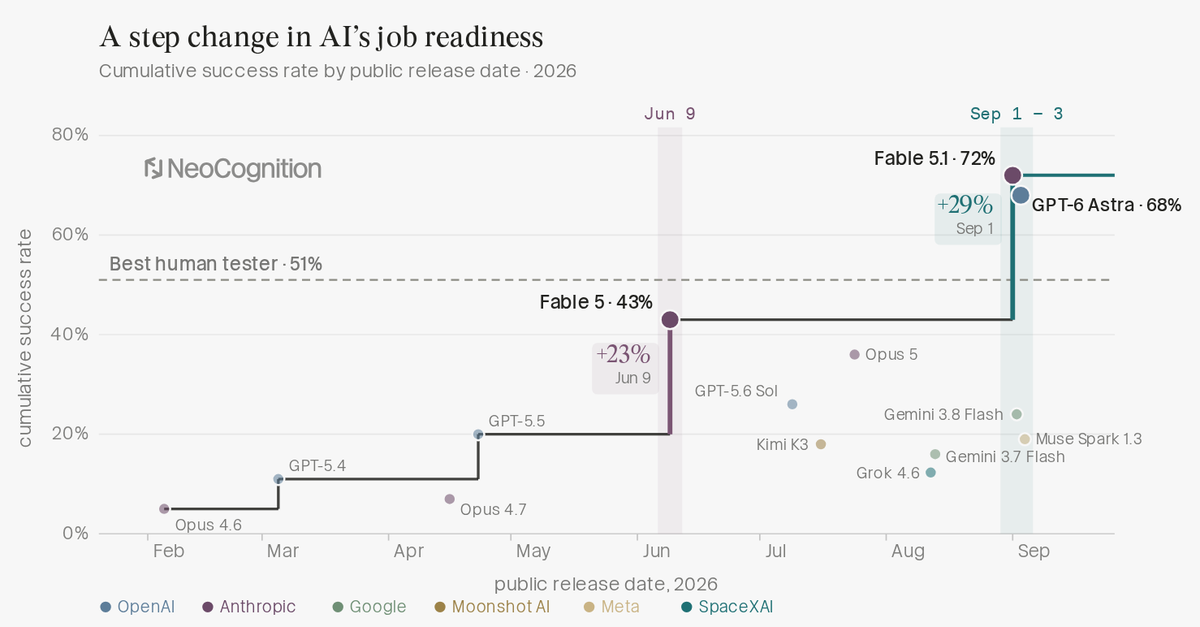
Лаборатория NeoCognition из Пало-Альто, известная по бенчмаркам MMMU, Mind2Web, SWE-Bench Pro и OSWorld 2, выпустила ApprenticeBench — первый сквозной тест, который устраивает ИИ на настоящую работу: агент последовательно выполняет 100 задач клерка кредиторской задолженности в ERP Odoo виртуальной строительной компании Acme Home Builders, получив полугодовой архив счетов и справочник компании. Claude Fable 5.1 решила 72% задач, GPT-6 Astra — 68%, тогда как лучший из двух тестировщиков-людей справился с 51%, а остальные модели, включая Gemini, Grok, Kimi и Muse Spark, остались ниже 25%. Лидерборд с ценами уже открыт на apprenticebench.com.
Что произошло
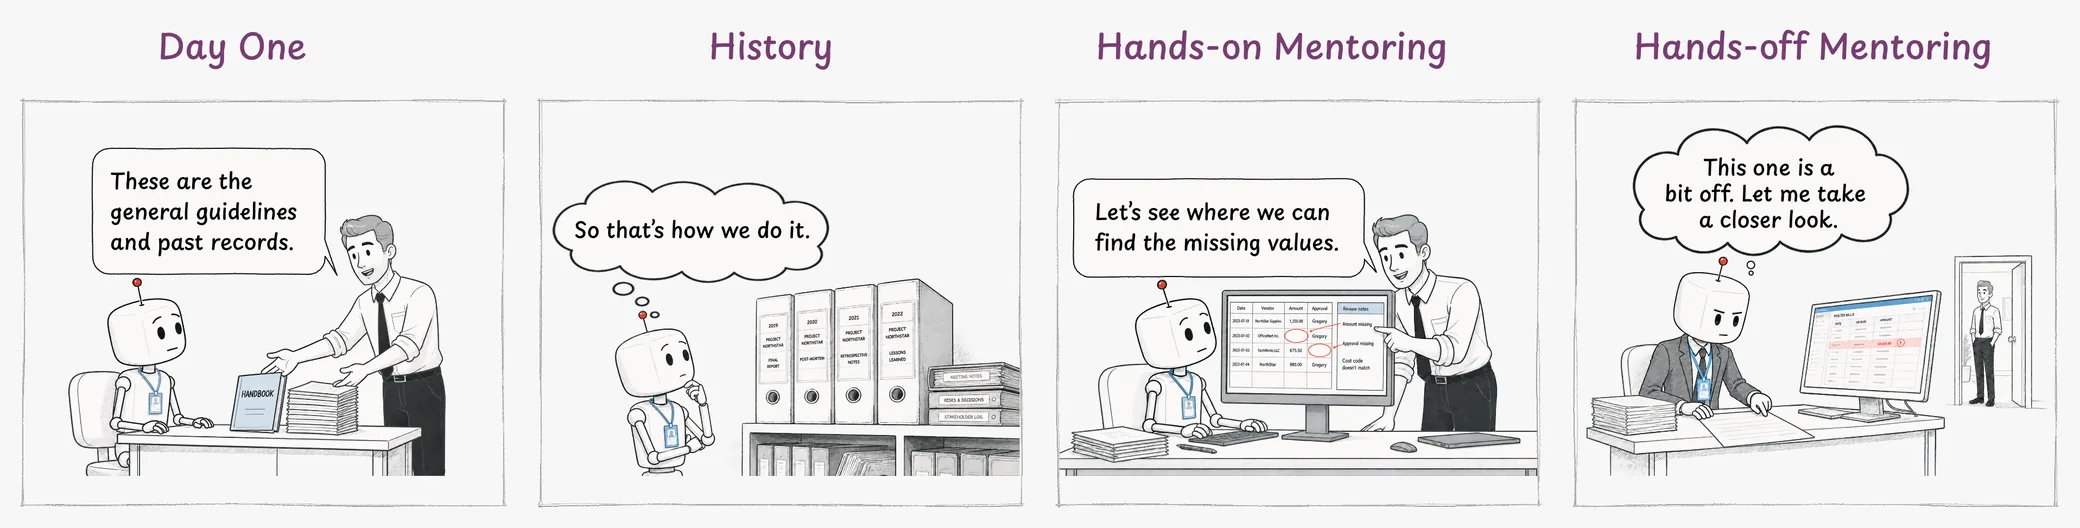
Команда NeoCognition — авторы бенчмарков MMMU, Mind2Web, SWE-Bench Pro, OSWorld 2 и агентных систем SeeAct, UGround, LLM-Planner и HippoRAG — опубликовала ApprenticeBench, первый тест, соединяющий computer use, непрерывное обучение и длинные агентные прогоны на реальной должности. Агент работает клерком кредиторской задолженности в строительной компании Acme Home Builders внутри ERP Odoo: он получает архив счетов за полгода, с ноября 2025 по апрель 2026, справочник компании и руководство, а обратная связь построена как при онбординге живого сотрудника — в первый месяц каждая обработанная счёт-фактура разбирается подробно, дальше остаются лишь редкие комментарии в конце месяца. Реалистичность сценариев и решаемость каждой задачи из ста независимо подтвердили два профессиональных бухгалтера строительной отрасли AP-профиля с суммарным стажем более 30 лет. Итоги прогона: Claude Fable 5.1 от Anthropic решила 72% задач, GPT-6 Astra от OpenAI — 68%, лучший из двух тестировщиков-людей — 51%, Gemini 3.8 Flash и Qwen3.8 Max — по 24%, Muse Spark 1.3 — 19%, Kimi K3 — 18%.
Контекст
Типовые агентные бенчмарки измеряют отдельные навыки: попасть по кнопке интерфейса, написать код, ответить на вопрос. ApprenticeBench впервые проверяет полный цикл «трудоустройства» — обучение на шумных данных конкретной компании, работу в GUI без бэкенд-API и адаптацию к меняющимся политикам на дистанции ста последовательных задач. Методологически самая ценная часть — абляция «smart novice»: Fable 5 без архива и обратной связи решает лишь 11 задач из 100, с архивом — 31, с обратной связью — 35, с обоими каналами сразу — 43; так измерение отделяет прирост от накопленного контекста от базовых способностей модели. Авторы связывают рекордный разрыв между закрытыми и открытыми моделями именно с обучением на длинном прогоне, а не с умением пользоваться интерфейсом: Kimi K3 почти не обращалась к архиву и собственным заметкам и деградировала. Важен и задний план: раньше переход агентных продуктов с API на GUI ощутимо снижал качество — это прозвали «налогом на использование компьютера», и именно его исчезновение у свежих флагманов стало одним из главных сигналов теста.
Почему это важно для индустрии
Для отрасли это первый пригодный для инженерных решений ориентир по GUI-агентам на длинной дистанции, и он фиксирует жёсткую стратификацию рынка: порог «нового сотрудника» преодолели только два закрытых флагмана, вышедших 1 и 3 сентября, а открытые модели провалили этап онбординга на данных компании. У вендоров агентных платформ появилась измеримая метрика, которая, вероятно, перекочует в маркетинг и требования корпоративных закупок, а у покупателей — ценовая база: GUI-режим Fable 5.1 стоит $18,23 за задачу против $6,95 через API и $7,21 у человека. Воспроизводимых инженерных шага три: встроить в агентный продукт онбординг по рецепту абляции (архив компании плюс канал обратной связи), оценивать GUI-агентов на реальных офисных задачах в Odoo-подобных системах по паре Fable 5.1 и GPT-6 Astra и сверять юнит-экономику с открытым лидербордом. Провал Kimi K3 дополнительно указывает, где сосредоточить разработки: управление памятью агента вместо разрастающихся заметок и целевые обновления моделей под длинные прогоны.
Почему это важно для пользователей
Лидерборд с ценами и ссылками открыт на apprenticebench.com, а независимые снимки уже публикует BenchLM — свежий датирован 15.09.2026, так что можно лично посмотреть, как топ-модели проходят те же сто счетов, где ломаются люди (усталость, поиск в архиве) и где деградирует Kimi K3. Практический сдвиг для читателя: «налог на компьютер» исчез у двух последних флагманов, и агентов уже можно оценивать на реальные офисные задачи в GUI вроде Odoo, а не только на синтетические клики. По деньгам, впрочем, API-режим пока вдвое-втрое дешевле GUI-режима, а открытые модели (Kimi K3 — 18%, Qwen3.8 Max — 24%) к такой работе не готовы: их главный провал именно в обучении на архиве компании. Тем, кто хочет проверить агентов на своих процессах, разумно запускать пилот на Fable 5.1 или GPT-6 Astra в Odoo-подобной системе, сохраняя выборочный контроль человека.
Что пока неизвестно / ограничения
База сравнения с людьми слабая: 51% — результат лучшего всего из двух тестировщиков, такая выборка не даёт популяционной оценки, и разрыв с 72% может частично объясняться индивидуальными различиями, усталостью и поиском по архиву, а не только превосходством модели. Цифры стоимости — данные вендора, независимой проверки пока нет. Сам бенчмарк опубликован недавно: независимых репликаций и методологической дискуссии ещё не было, а перенос формата на другие должности не проверен. Наконец, даже 72% лучшей модели означают 28% ошибок — в кредиторской задолженности без выборочной проверки человеком агентов запускать нельзя.
Источники
- ApprenticeBench — NeoCognition Blog (первоисточник)
- ApprenticeBench — официальный сайт бенчмарка с лидербордом
- ApprenticeBench Leaderboard & Scores — BenchLM.ai (независимое зеркало, снимок 15.09.2026)
Автор
Look at AI, редакция