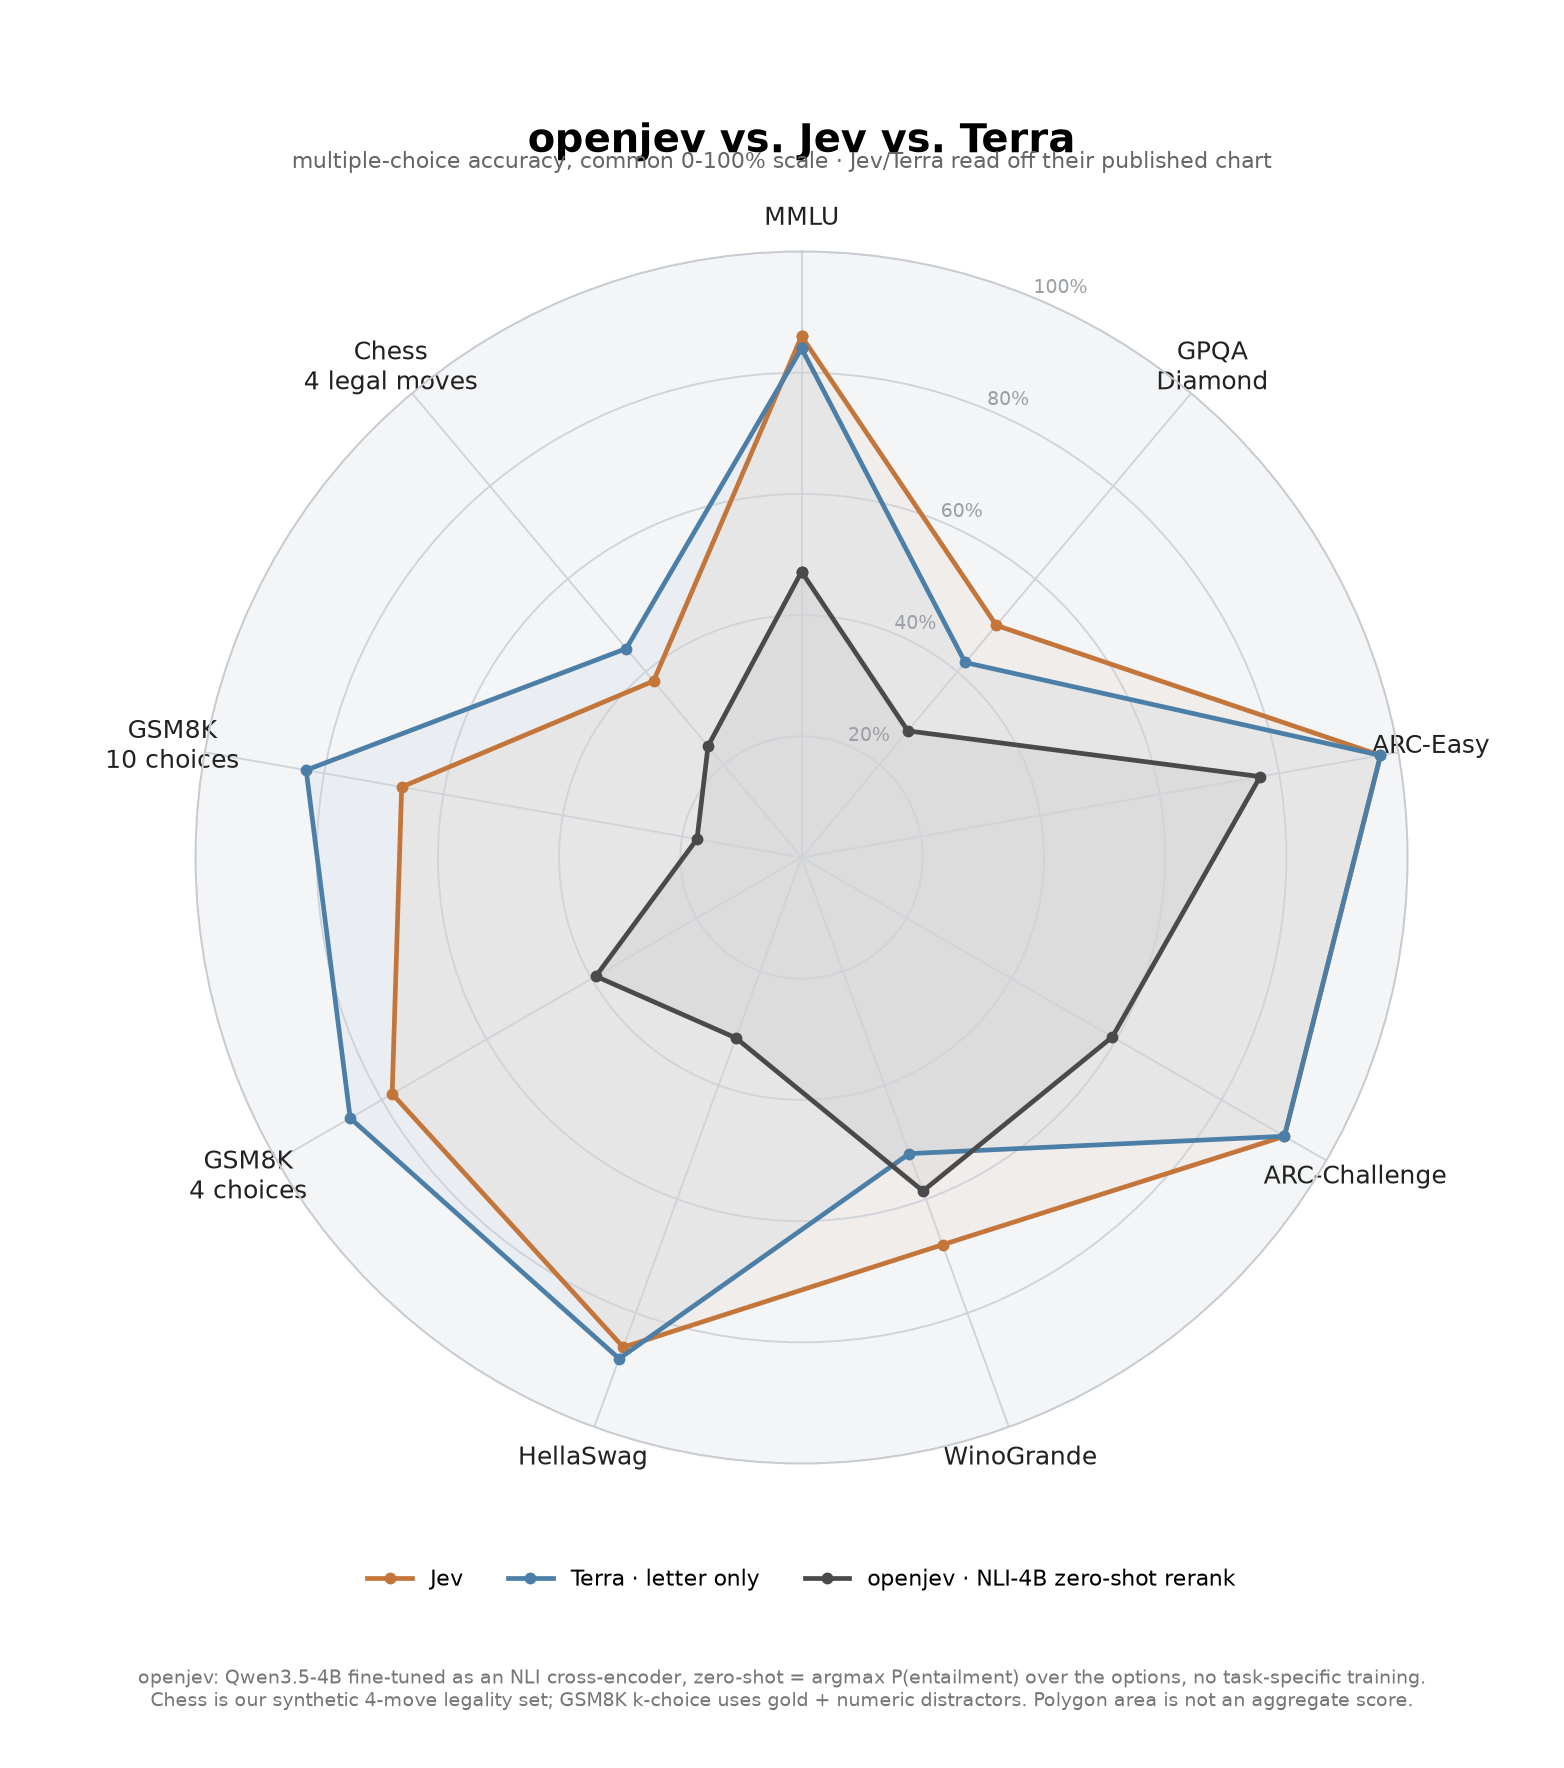
Автор AlexWortega (Александр Вортега) выложил на Hugging Face модель openjev: готовый декодер Qwen3.5-4B, полностью дообученный как NLI-кросс-энкодер. Модель не генерирует ответы, а проверяет утверждения: она читает пару «посылка — гипотеза» и выдаёт вероятности того, что гипотеза следует из посылки, противоречит ей или нейтральна. Без эталона такой энкодер rerank-ит варианты ответов, с эталоном — сверяет их с правильным ответом, а без какого-либо дополнительного обучения работает политикой игрового агента в Flappy Bird и Doom. Веса открыты под MIT вместе с кодом обучения и сырыми результатами, однако все цифры пока авторские и ждут независимой проверки.

Что произошло
На Hugging Face опубликован релиз openjev от автора AlexWortega (Александр Вортега): декодер Qwen3.5-4B дообучен целиком под задачу NLI-верификации в классе Qwen3_5ForSequenceClassification и для пары «посылка — гипотеза» возвращает вероятности трёх классов: entailment (следует), contradiction (противоречит) и neutral. В режиме rerank без эталона модель набирает 0.472 на MMLU и 0.769 на ARC-Easy, в режиме grading с эталоном — 0.974 на MMLU, 0.996 на GSM8K и 0.997 на шахматной задаче выбора легального хода из четырёх вариантов. Тот же энкодер без какого-либо task-specific обучения используется как политика агента: Flappy Bird проходится идеально, 28 труб из 28 против 24.5 у эвристики-оракула, примерно за 55–65 мс на решение с flash-linear-attention кернелами; в ViZDoom на сценарии Defend the Center модель набирает 11.0 фрагов из 18.8 оракульных при игре из текстового состояния и 5.2 при игре прямо с пикселей через vision-башню Qwen3.5. Вместе с весами опубликованы modeling_openjev.py с хелперами predict, rerank и grade, код обучения train.py и сырые JSON всех таблиц.
Контекст
Сам приём не нов: NLI-кросс-энкодеры давно применяют как дешёвые верификаторы и reranker'ы, и точкой сравнения в карточке openjev служит типичный представитель этого семейства — dleemiller/ModernCE-large-nli, компактный ModernBERT объёмом 395M параметров. Разница в том, что классификационную голову тренировали поверх уже готового большого декодера, а не учат маленький энкодер с нуля, и один вес обслуживает сразу несколько сценариев. Читать метрики нужно с поправкой на тип задачи: grading — это дискриминация пары «ответ — эталон», заведомо более лёгкая работа, чем генерация, поэтому значения 0.97–0.99 ожидаемы и не означают, что 4B-модель «знает» правильные ответы; содержательнее зазор между rerank без эталона (0.472 на MMLU) и grading с эталоном (0.974). Качество самого артефакта выше среднего для вирусного релиза: карточка разделяет zero-shot результаты и не-zero-shot MLP-пробы, вынесенные в аппендикс, что делает замер проверяемым, а не маркетинговым.
Почему это важно для индустрии
Для индустрии смысл в экономике вызовов: один forward на пару занимает порядка 57 мс, тогда как rerank и модерация через LLM-вызовы стоят дороже и работают медленнее, поэтому 4B-кросс-энкодер — это ценовой арбитраж в cost-sensitive местах пайплайнов. Один и тот же вес закрывает rerank вариантов ответа, grading против эталона в эвалах и игровую политику агента через argmax P(entailment), что показывает выход примитива за рамки чисто текстовых задач. Оговорка существенна: сценарий guardrails и контент-фильтра в доступных материалах не подтверждён ни одним замером и остаётся гипотезой, а не результатом. Если независимые воспроизведения подтвердят zero-shot цифры, NLI-голова поверх готового декодера может стать стандартным дешёвым компонентом прод-пайплайнов и вызвать волну повторений на других базах и размерах, особенно на 0.5B–1.5B, где экономика против LLM-вызовов ещё выигрышнее; в длинной перспективе релиз аргументирует архитектуру «генератор — верификатор», где большой генератор предлагает варианты, а средний кросс-энкодер дёшево их отбирает и валидирует против эталона или правил.
Почему это важно для пользователей
Практикам релиз даёт рабочий инструмент, а не только новость: веса qwen3.5-4b-nli открыты под MIT, и за один вечер можно склонировать repo, прогнать хелперы predict, rerank и grade из modeling_openjev.py на собственных парах через transformers или sentence-transformers и сравнить результаты с dleemiller/ModernCE-large-nli, не потратив ничего на обучение. Тем, кто строит агентов, полезен побочный инсайт из игровых демо: просьба «назвать действие» не работает, а верификация утверждения о состоянии среды с привязкой утверждения к действию даёт идеальную игру в Flappy Bird, и этот рецепт «спрашивай проверку, а не выбор» переносится за пределы игр. Наглядные демонстрации — видео игры в Doom из текстового состояния и прямо с пикселей — доступны в карточке модели, а сырые JSON таблиц позволяют перепроверить каждое число без доверия на слово.
Что пока неизвестно / ограничения
Все цифры self-reported одним автором: независимых замеров пока нет, и никто не проверял качество чужими руками. Поведение модели на out-of-distribution и adversarial-входах не охарактеризовано, сценарий guardrails не подтверждён измерениями, а заявленная латентность 55–65 мс на решение получена на конкретных демо и требует перемера на своих данных и своём железе. Игровые результаты следует воспринимать как демонстрацию подхода, а не как продакшен-бенчмарк. Кроме того, лицензия MIT на веса наследует условия Qwen3.5, что нужно учитывать при коммерческом встраивании.
Источники
- openjev — Qwen3.5 trained as jev model (официальная карточка модели)
- openjev full_report.md — полный отчёт с таблицами zero-shot результатов
- dleemiller — NLI cross encoders: ways to use them (методология и референс ModernCE-large-nli)
Автор
Look at AI, редакция