15 сентября 2026 года NVIDIA разместила на Hugging Face открытые веса двух моделей 3D-перцепции линейки Vision AI: FoundationStereo для оценки глубины по стереокадрам и FoundationPose для определения 6-DoF-позы объектов. Обе распространяются под NVIDIA Open Model License с разрешением на коммерческое использование, работают в zero-shot без дообучения и рассчитаны на железо от Jetson до A100 и H100.


Что произошло
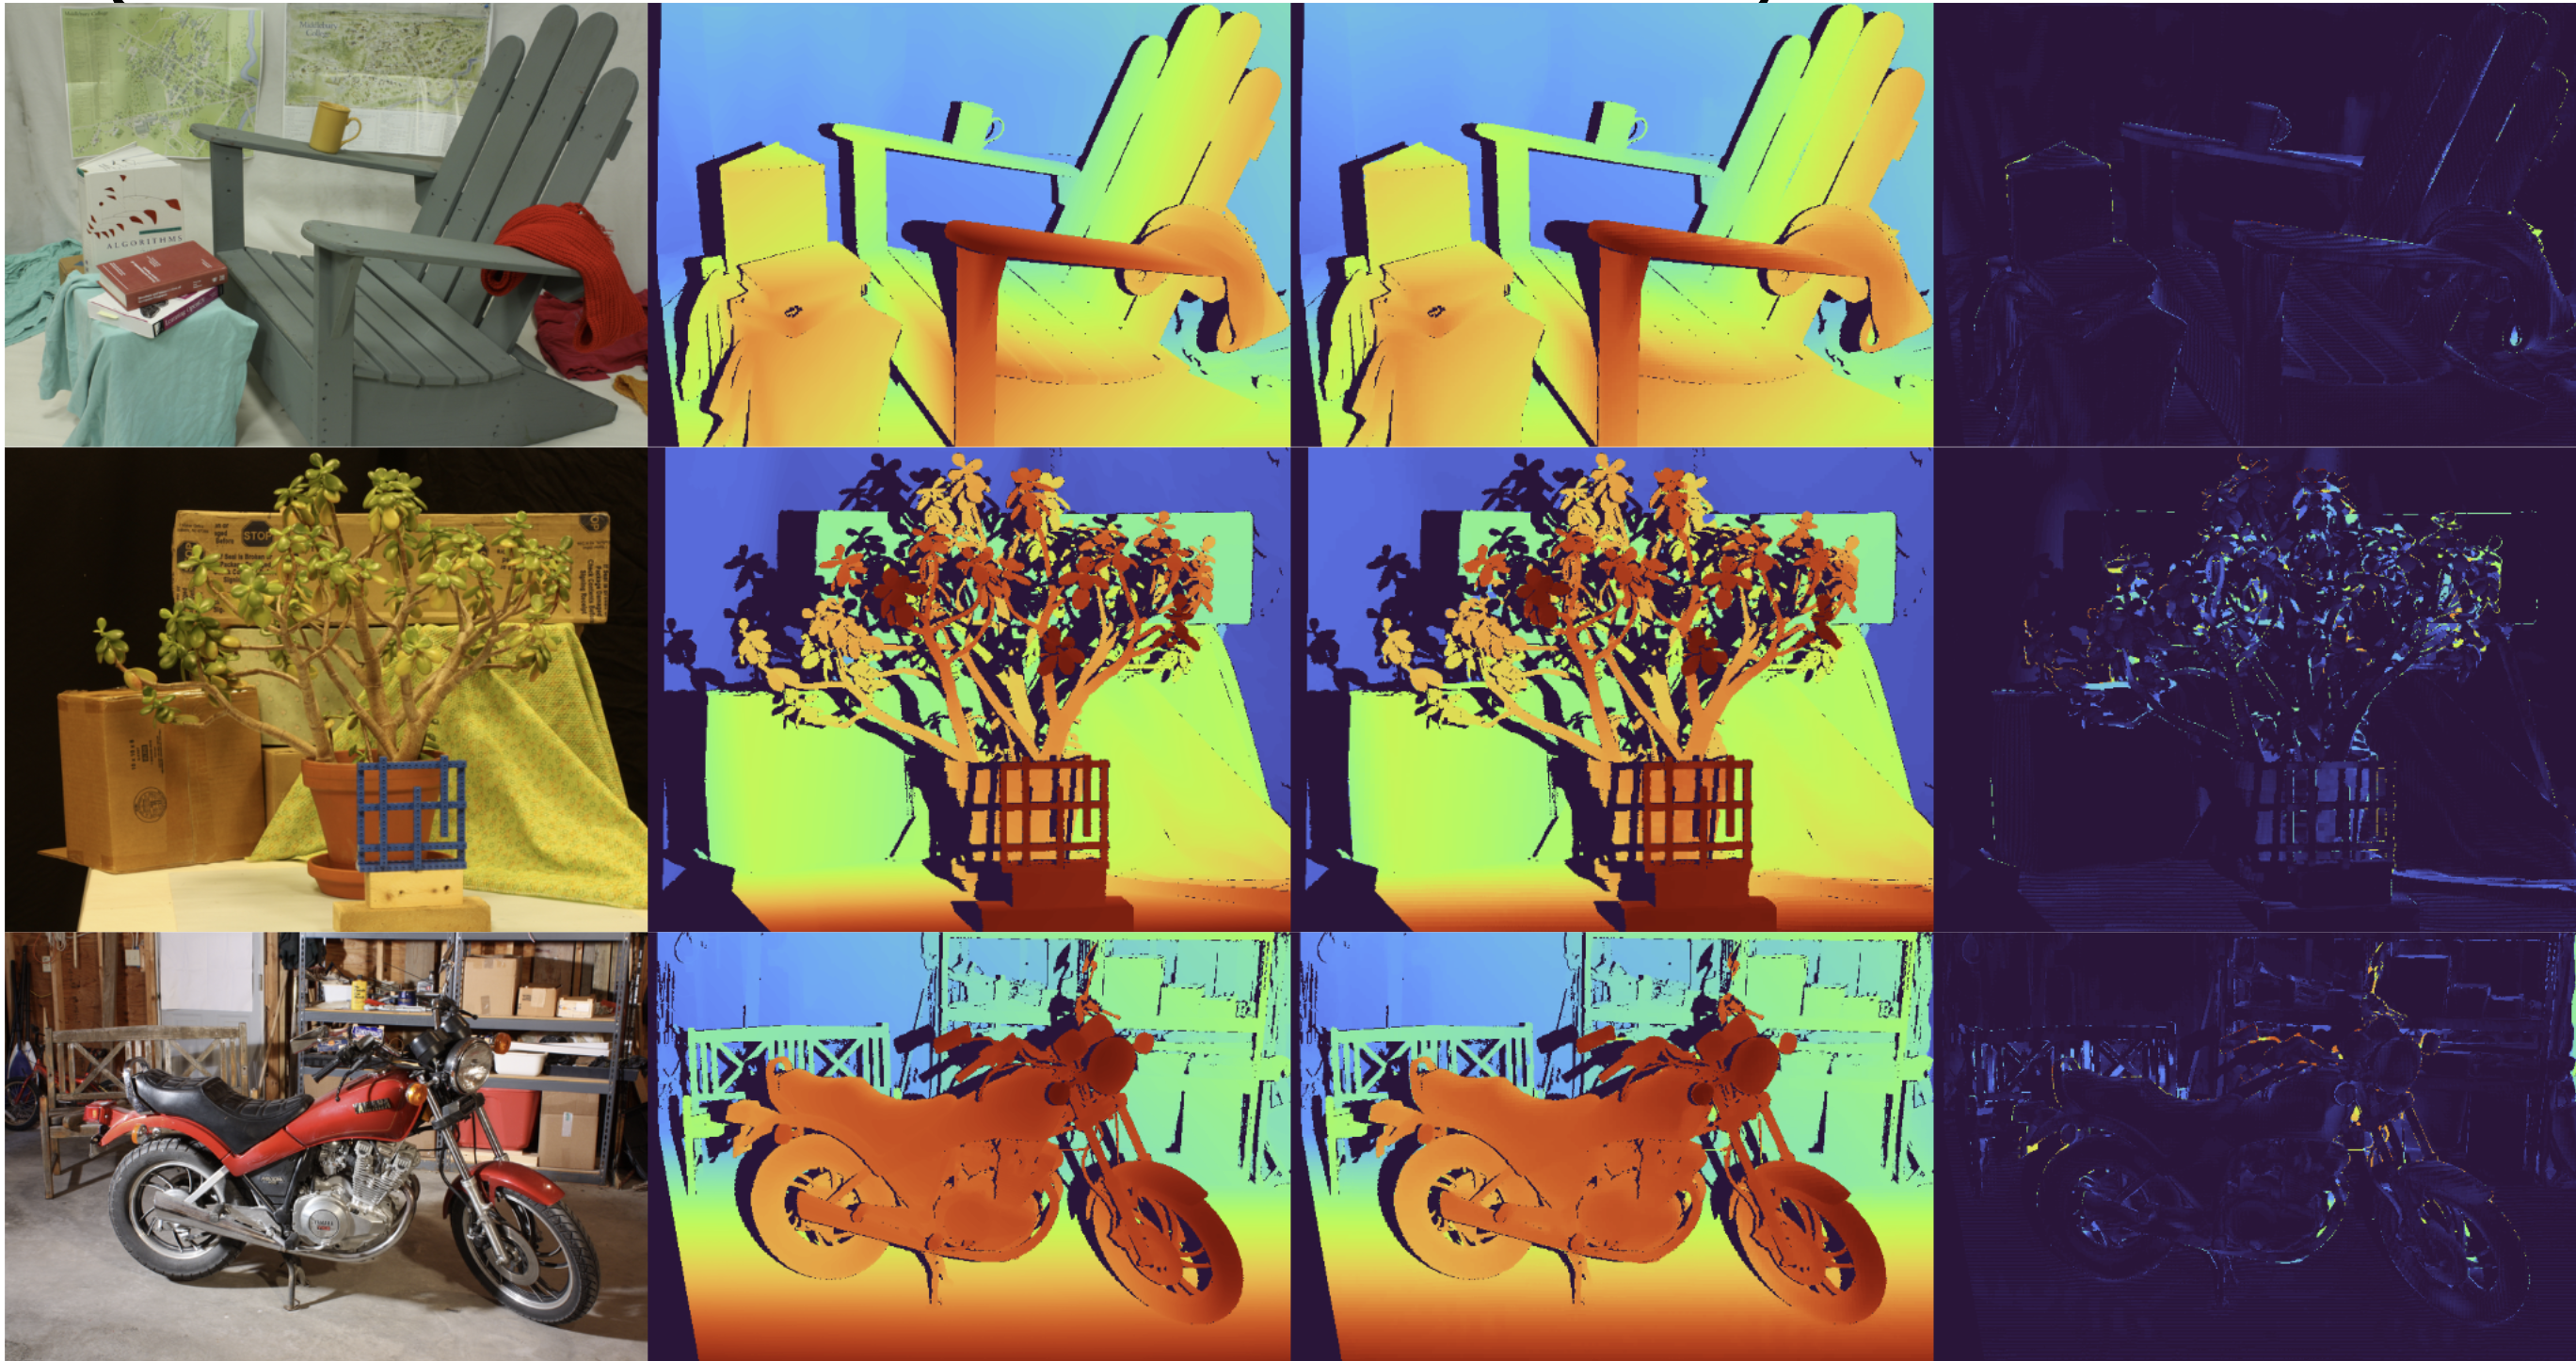
15 сентября 2026 года NVIDIA выложила на Hugging Face две открытые модели 3D-перцепции линейки Vision AI. Первая — FoundationStereo, репозиторий nvidia/c-foundationstereo-s, 63 млн параметров: по паре RGB-кадров со стереокамеры она выдаёт карту диспаритета в zero-shot, без дообучения. Вторая — FoundationPose, репозиторий nvidia/foundationpose: по текстурированной CAD-модели объекта в формате OBJ и RGBD-кадру она оценивает положение и ориентацию объекта в шести степенях свободы. Обе модели помечены как готовые к коммерческому использованию и поставляются в форматах ONNX и TensorRT. FoundationStereo протестирована на железе от Jetson AGX Orin и Thor до A100 и H100; на A100 в режиме FP16 при разрешении 320x736 инференс занимает 199 мс на кадр.
Контекст
Обе модели — не новые разработки 2026 года: их научная основа прошла рецензирование на профильных конференциях. Архитектура FoundationStereo опубликована на CVPR 2025 как Oral-доклад с номинацией на Best Paper, FoundationPose была отмечена как Highlight на CVPR 2024. Поскольку веса открыты, заявленные в работах метрики воспроизводимы сообществом — редкий случай, когда выводы из статьи можно проверить напрямую на своём железе. FoundationStereo совмещает трансформер и CNN и опирается на монокулярный приор DepthAnythingV2; обучена она на 1,6 млн синтетических стереопар FSD, сгенерированных в Omniverse, плюс датасеты CREStereo и Tartanair. FoundationPose обучена только на синтетике: Objaverse с 40 тыс. объектов и Google Scanned Objects, отрендеренные в Omniverse и Isaac Sim. На BOP-бенчмарках она показывает средний скор 83.3, в том числе 83.0 на TLESS и 88.0 на YCB-Video. Ставка на синтетические данные вместо сбора реальных датасетов — ключевой элемент подхода: обе модели должны переноситься на новые сцены и объекты без дообучения.
Почему это важно для индустрии
Для робототехнических команд и стартапов исчезает главный барьер продуктовой перцепции — сбор датасетов и дообучение пайплайнов стерео-глубины и захвата позы: zero-shot-инференс на новых сценах и объектах работает на краевых устройствах от Jetson Orin Nano до H100, а лицензия прямо разрешает коммерческое применение. Путь от прототипа до промышленного пилота распознавания и манипуляции становится заметно короче и дешевле. Обратная сторона: размывается защитный барьер команд, чьим продуктом были дообученные модели глубины и позы, — закрытые вендоры, распространяющие такие модели по платной лицензии, столкнутся с ценовым давлением. Меняется и состав входных данных продукта: ценность смещается от обучения моделей к качеству CAD-ассетов, калибровке сенсоров и оркестрации вокруг перцепции. Если шаблон «синтетика вместо реальных датасетов» приживётся, стоит ожидать волны интеграций в робототехнические стеки, fine-tune-версий поверх открытых весов и независимых замеров на реальных производственных сценах.
Почему это важно для пользователей
Веса можно бесплатно скачать с Hugging Face и в тот же день проверить на своём железе. Для FoundationStereo достаточно стереокамеры и её калибровки — модель построит карту глубины из пары RGB-кадров; для FoundationPose нужна текстурированная CAD-модель в OBJ и RGBD-кадр вместо собранного обучающего набора. Реалистичный план на первые одну-две недели — развернуть TensorRT-инференс и собрать небольшой внутренний eval-сет на своих сценах; за один спринт реально собрать демо измерения объёмов или 6-DoF-трекинга объектов. Карты глубины и трекинг позы пригодны для проектов робототехники и умных пространств, поэтому проверку разумно вести на типовых для вас сценах и материалах.
Что пока неизвестно / ограничения
Zero-shot в 3D-перцепции не тождествен сдвигу, который открыли LLM: результат критически зависит от качества сенсора, калибровки стереопары и точности RGBD-глубины, а не только от самих весов. Проблемные зоны обеих моделей — прозрачные и блестящие предметы, пересвет и плохое освещение. Публикуемые метрики — средний скор на BOP-бенчмарках и латентность на A100 — получены на бенчмарках и не гарантируют те же результаты на конкретном железе и конкретных сценах; независимых сравнительных замеров на реальных производственных сценах пока не хватает. Ожидания волны интеграций, нишевых продуктов и смены дефолтного робототехнического стека — интерпретация тренда, а не подтверждённый факт.
Источники
- nvidia/c-foundationstereo-s — Hugging Face (модельная карта Vision AI / TAO)
- nvidia/foundationpose — Hugging Face (модельная карта Vision AI / TAO)
Автор
Look at AI, редакция