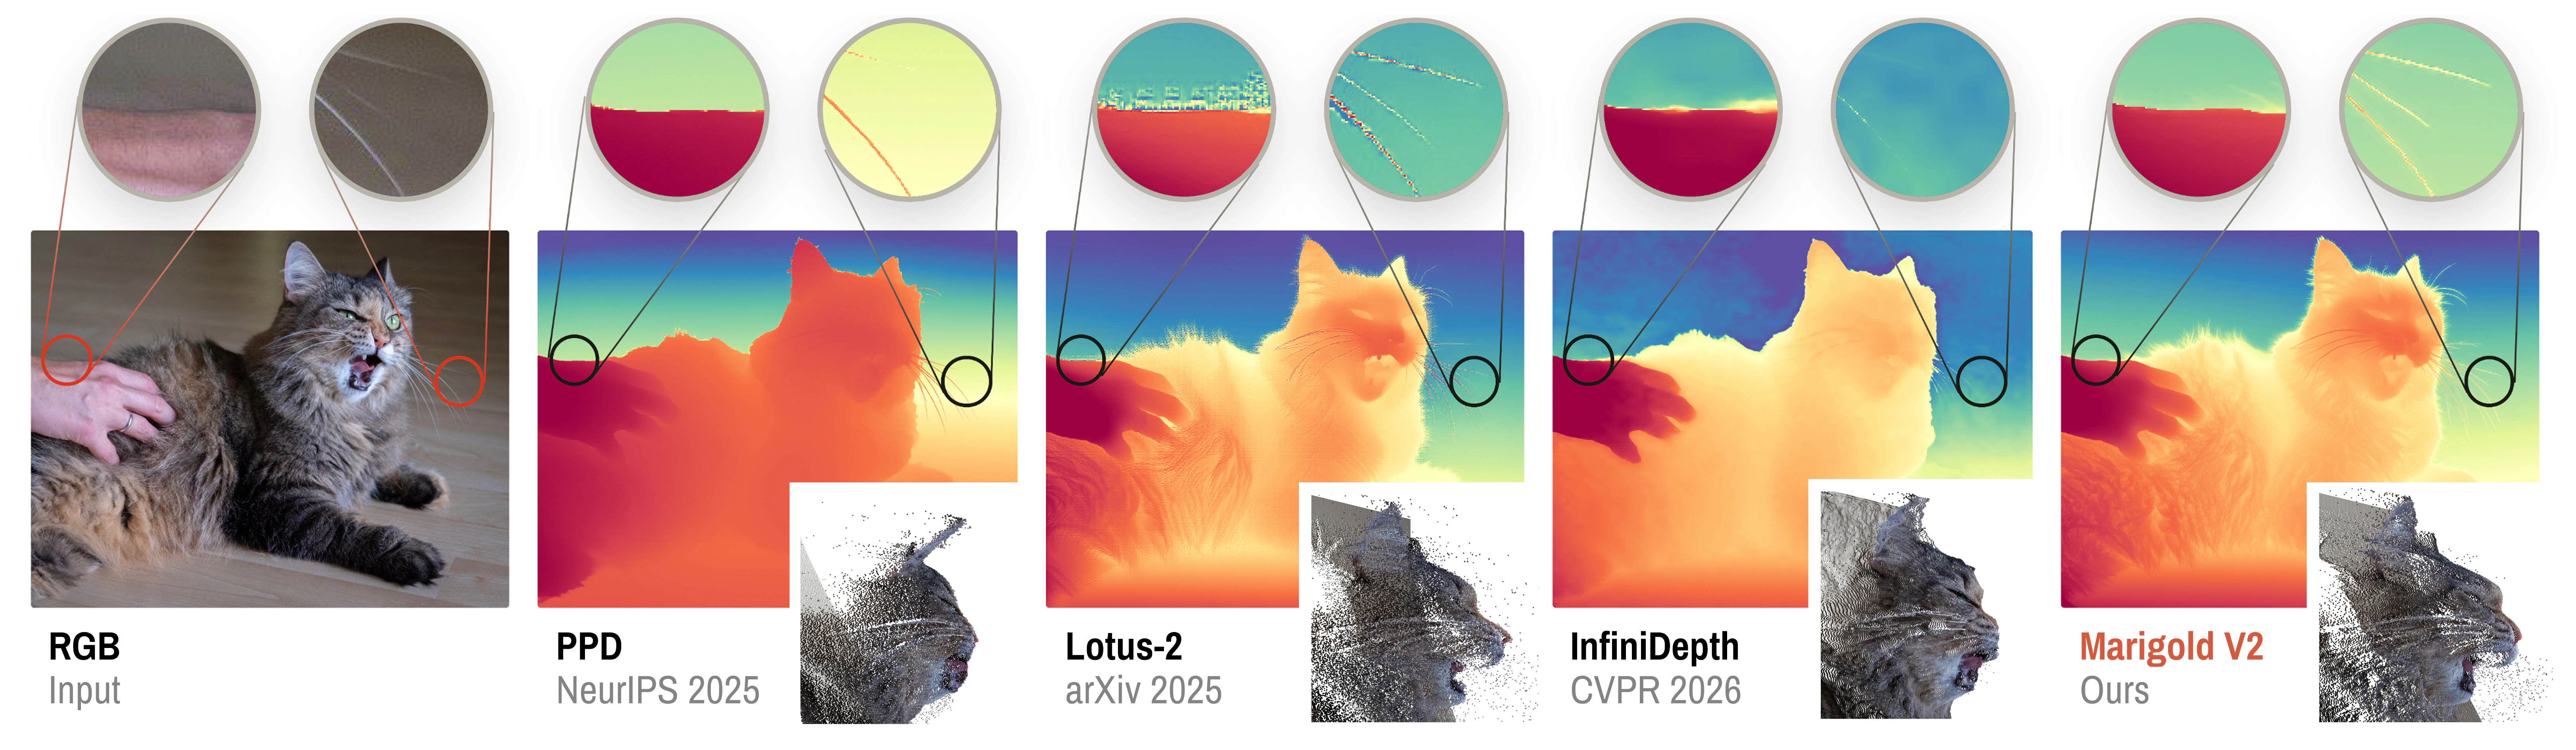
HUAWEI Bayer Lab совместно с EPFL и University of Bologna выпустила Marigold V2 — открытую систему, которая превращает предобученный диффузионный трансформер в одношаговый оценщик монокулярной глубины по одному изображению, а код и веса опубликованы под лицензией Apache-2.0.


Что произошло
Вторая версия системы Marigold построена на предобученной модели Qwen-Image-Edit-2509: бэкбон заморожен, обучение идут LoRA-адаптеры rank 128 поверх DiT, квантованного до 4 бит, а дистилляция из многошаговой flow-matching модели позволяет делать инференс за один шаг. В работе (arXiv:2609.08084) заявлено улучшение AbsRel на 16-26% по KITTI и ETH3D относительно прежнего лучшего результата, а также SOTA на оценке нормалей (NYUv2, ScanNet, iBims-1, Sintel) и на разложении изображения: albedo с PSNR 20.78, SSIM 0.811 и LPIPS 0.195 на Hypersim. Код, веса и веб-демо опубликованы в репозитории huawei-bayerlab/marigold-v2.
Контекст
Первая версия Marigold показала, что предобученную генеративную диффузионную модель можно использовать для плотных предсказаний, в частности глубины, вместо специализированных регрессионных depth-моделей. У таких диффузионных подходов была системная издержка: инференс занимал десятки итераций диффузионного процесса, и именно на этом месте Marigold V2 ставит один forward прогон. Оценка ведётся на стандартных сопоставимых бенчмарках: KITTI и ETH3D по глубине, NYUv2, ScanNet, iBims-1 и Sintel по нормалям, Hypersim по albedo, поэтому заявленные результаты можно сверять с опубликованными цифрами других работ. Методический вклад версии — два конкретных приёма: выравнивание внутренних представлений модели с семантическими признаками (iREPA на DINOv3) и двухстадийный финтюн с новым Sinkhorn-лоссом (SinkLoss), которые предположительно дают резкие края и убирают характерное размытие.
Почему это важно для индустрии
Для отрасли главный сигнал — экономика разработки: предобученный DiT для генерации изображений доведён до SOTA-оценщика плотных величин (глубина, нормали, albedo) LoRA-финтюном на одном потребительском GPU с 32 ГБ, стадия 1 занимает 160k шагов примерно за 5 дней при batch=1. Инференс требует около 17 ГБ VRAM при разрешении 1024x1024 и около 29 ГБ при 2048x2048 и занимает один шаг вместо десятков итераций. Это снижает стоимость разработки и развёртывания dense prediction для робототехники, вычислительной фотографии и 3D-реконструкции: команды получают готовый открытый baseline, на который можно сразу гонять собственные depth- и normals-пайплайны, вместо разработки модели с нуля.
Почему это важно для пользователей
Для читателя модель доступна сразу: её можно попробовать в веб-демо на Hugging Face или запустить локально из открытого репозитория, где код и веса лежат под Apache-2.0. Среди чекпоинтов есть вариант Log-layered, предсказывающий глубину «сквозь» прозрачные объекты, например за стеклом, а новую модальность для модели можно подключить через YAML-конфиг. Для творческих задач это готовые резкие карты глубины без характерного для старых моделей размытия шерсти, листвы и тонких краёв.
Что пока неизвестно / ограничения
Все SOTA-цифры (улучшение AbsRel на 16-26% по KITTI и ETH3D, результаты по нормалям и albedo) — авторские результаты из их же arXiv-статьи, независимого воспроизведения пока нет. Опубликованных данных по латентности и throughput инференса нет, управляемого API и SLA у проекта тоже; по состоянию на публикацию это исследовательский open-source baseline, а не сервис.
Источники
- Marigold V2: Revisiting Diffusion Transformers for Monocular Depth Estimation (arXiv:2609.08084)
- Marigold V2: Revisiting Diffusion Transformers for Monocular Depth Estimation — GitHub (huawei-bayerlab/marigold-v2)
- huawei-bayerlab/marigold-v2-0 — Hugging Face (weights)
- Marigold V2 web demo — Hugging Face
Автор
Look at AI, редакция