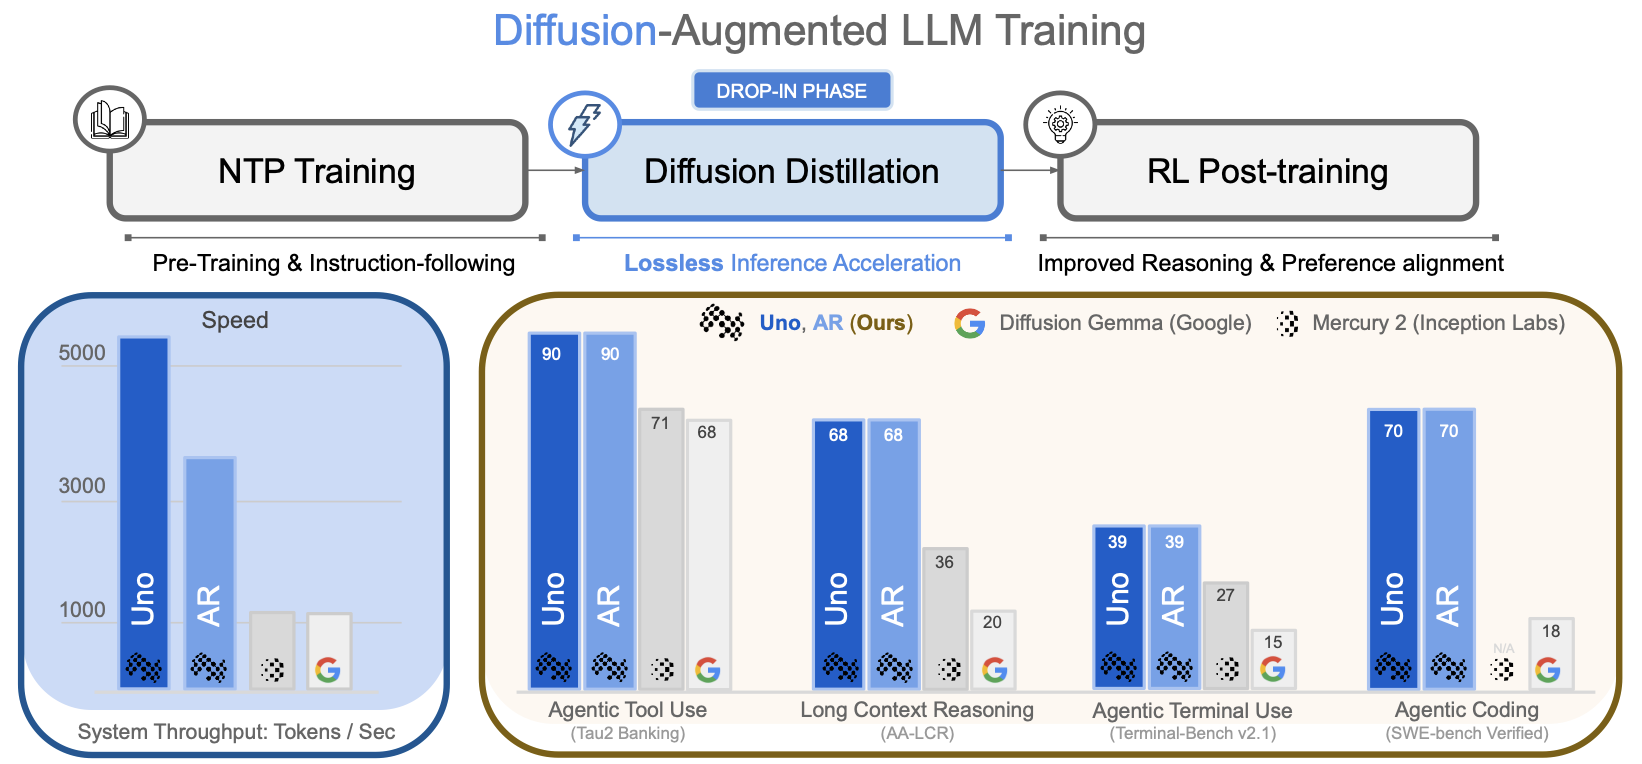
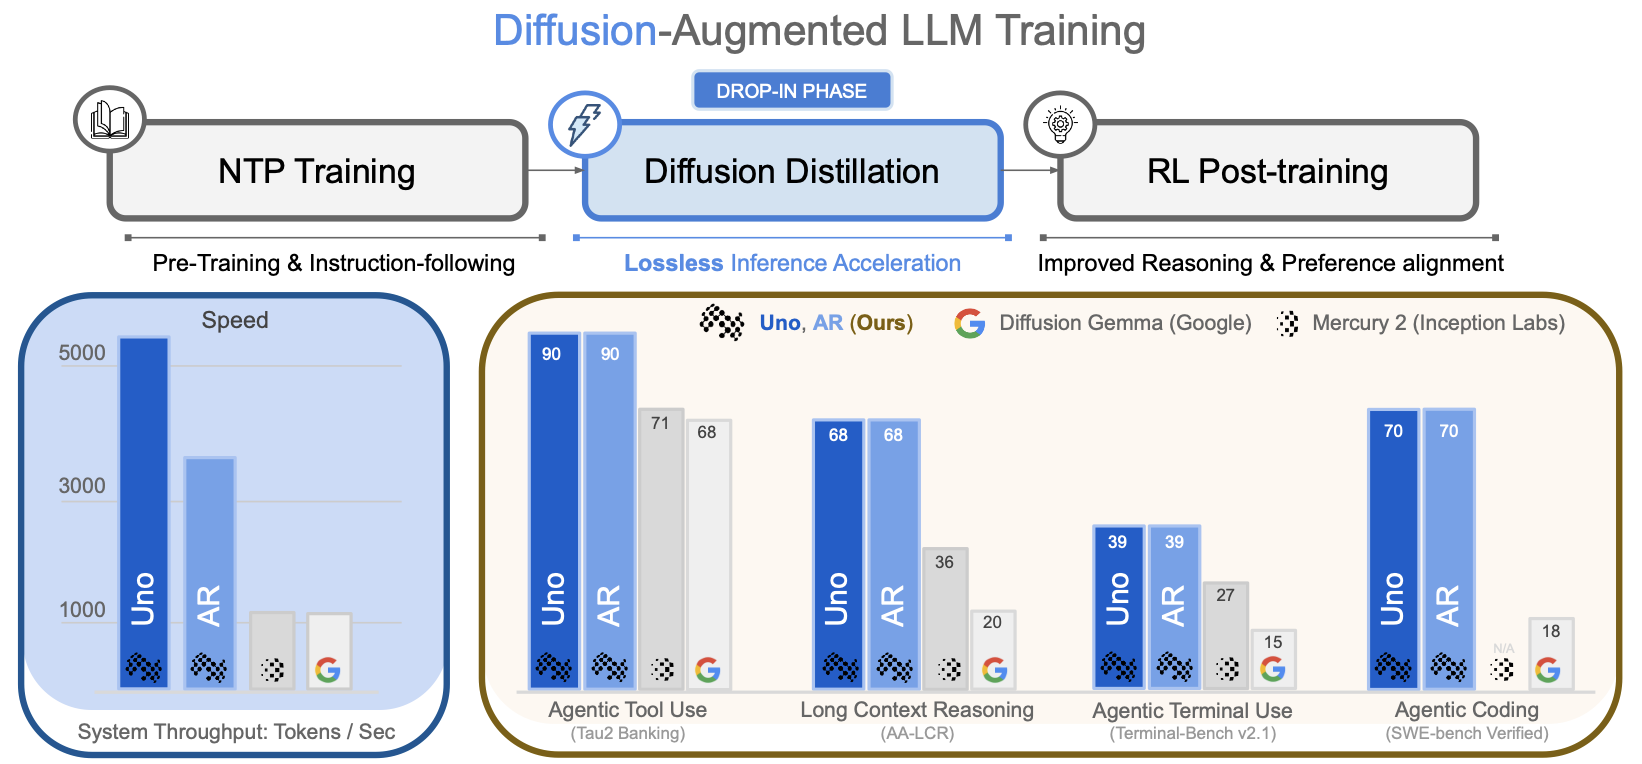
Institute of Foundation Models и Cerebras Systems представили Uno — семейство диффузионно-дополненных LLM, которые, по заявлению авторов, ускоряют инференс до 3x без отдельной draft-модели и без потери качества. Код и веса открыты.

Что произошло
3 сентября 2026 команда из Institute of Foundation Models (IFM) и Cerebras Systems с соавторами из UIUC, Cornell Tech и Harvard опубликовала работу Unlocking Lossless Speedups in LLMs via Discrete Diffusion (arXiv:2609.04010). В ней описана модель Uno — диффузионно-дополненная LLM с двумя наборами весов: AR-веса, обученные на стандартном next-token prediction и отвечающие за качество, и легкие диффузионные веса, которые предсказывают сразу несколько токенов параллельно. Для сэмплирования разработано семейство сэмплеров Psi-Spec, которое, согласно авторам, выдает то же распределение, что и базовая AR-модель, но быстрее. Одновременно открыты код под лицензией Apache-2.0 (github.com/ifm-ai/uno) и веса: Uno 8B на базе IFM/K2-Horizon-7B, Uno 1B на базе IFM/K2-Horizon-0.9B и Uno Qwen3 8B, доступные на Hugging Face без токена.
Контекст
Классический speculative decoding, к числу методов которого относятся DFlash и Eagle3, ускоряет инференс LLM за счет отдельной небольшой draft-модели: она предлагает токены, а более крупная модель их проверяет. Главный минус такого подхода — необходимость держать вторую модель в памяти и в операционном контуре. Uno предлагает иной путь: вместо внешней draft-модели скорость встроена в саму архитектуру, и легкая диффузионная часть предсказывает блоки токенов параллельно. Дополнительный обучающий этап Diffusion Distillation добавляется к существующему пайплайну с пренебрежимыми издержками. Участие Cerebras Systems указывает на возможную связь метода с аппаратно-ориентированным ускорением.
Почему это важно для индустрии
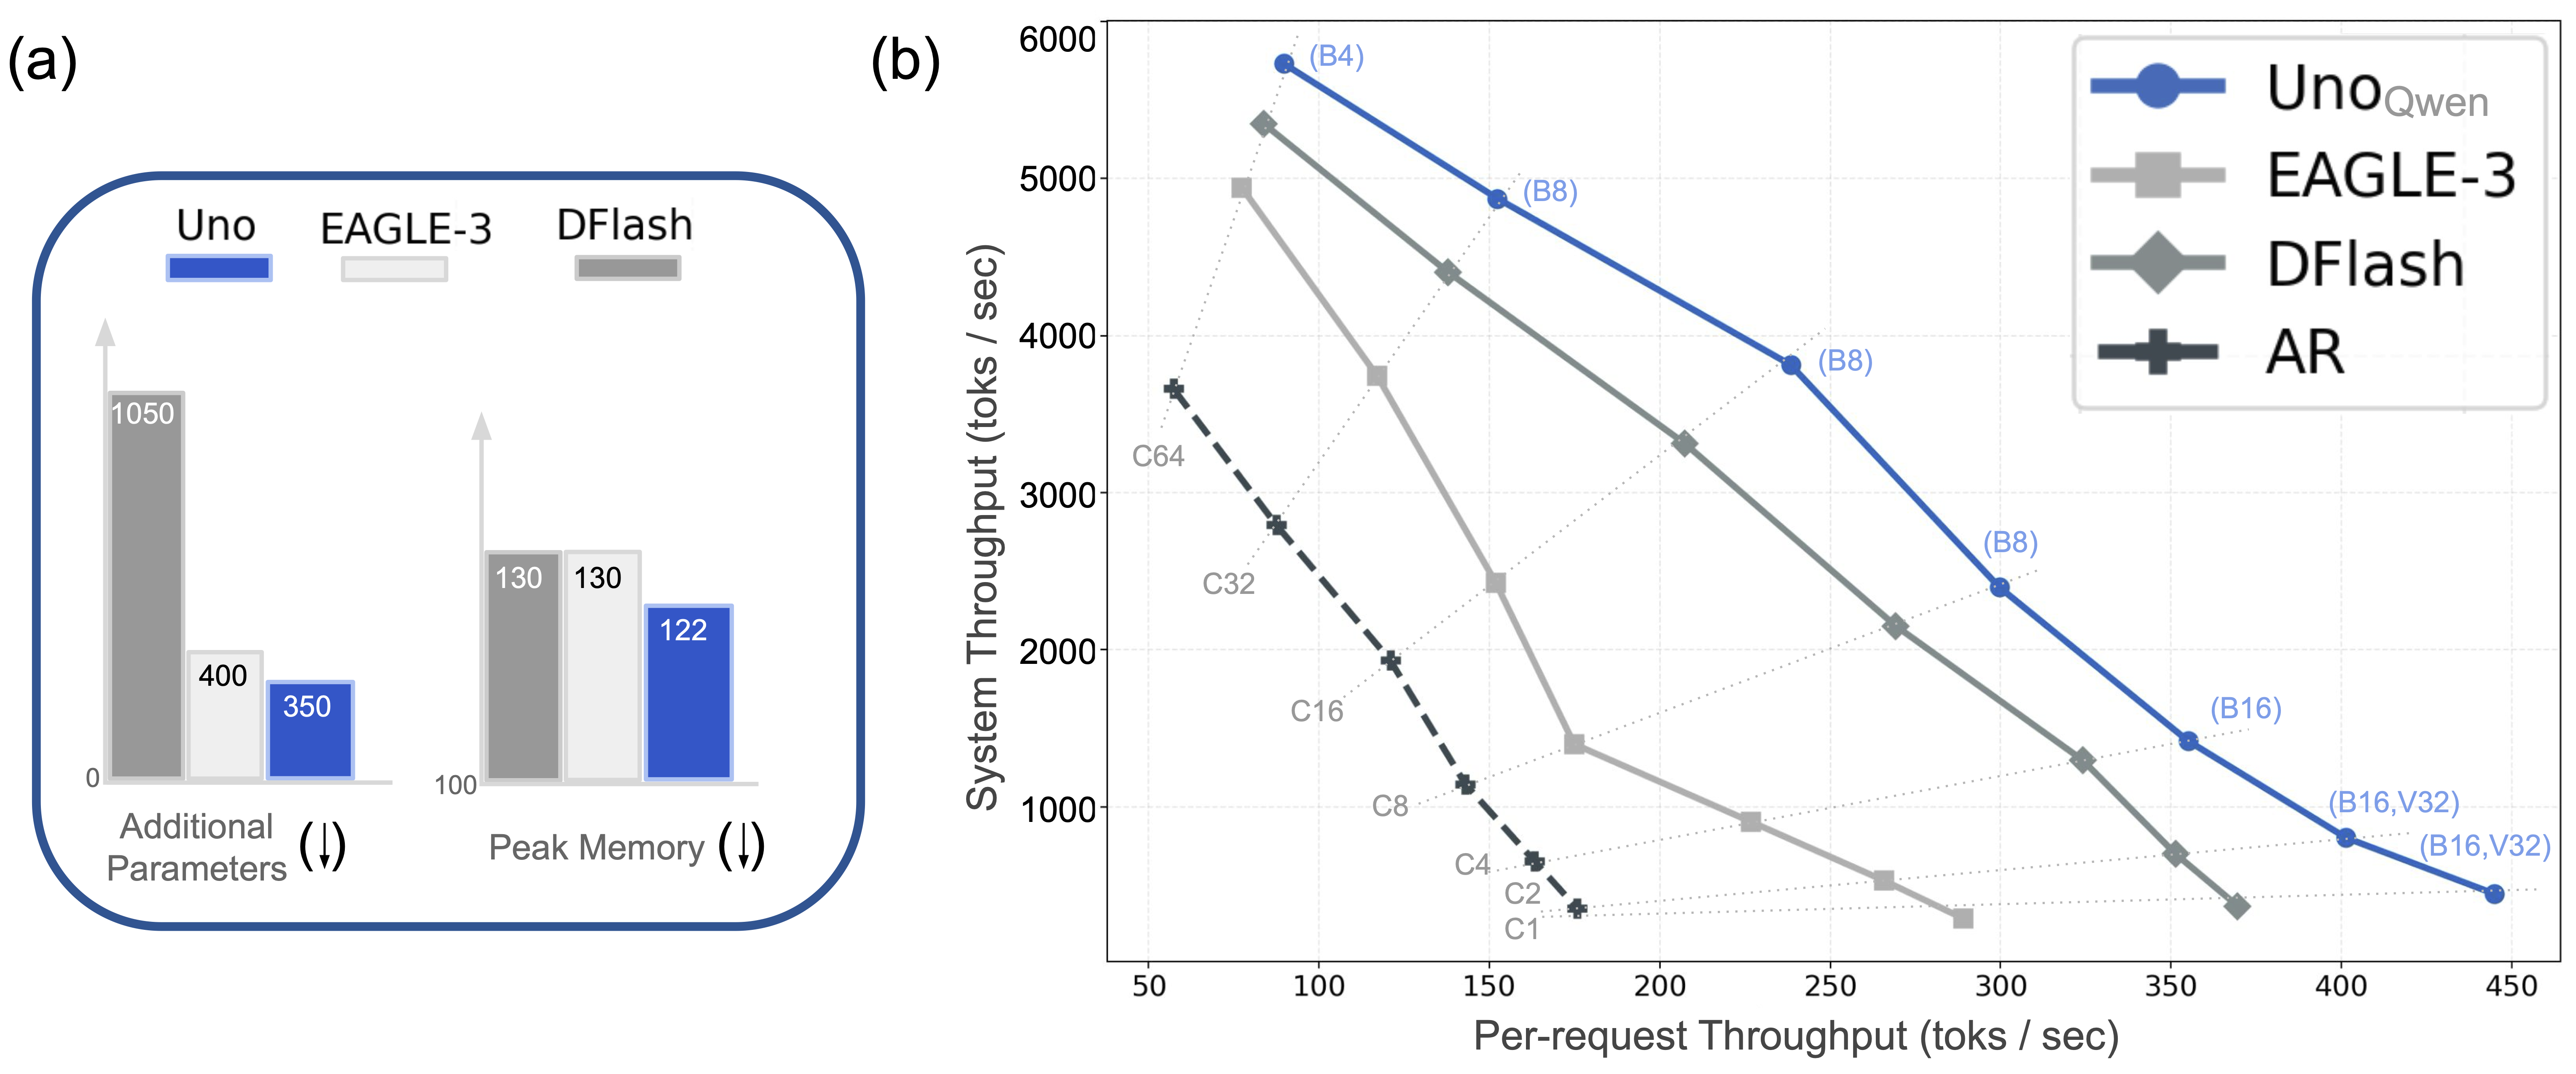
Uno задает новый класс diffusion-augmented LLM, в котором качество (AR-веса) и скорость (диффузионные веса) отделены внутри одной модели, а структурный минус speculative decoding в виде отдельной draft-модели с ее памятью и операционной сложностью исчезает. Авторы утверждают, что метод превосходит DFlash и Eagle3 по throughput во всех проверенных batch sizes при наименьшем числе дополнительных параметров и минимальном потреблении памяти при инференсе. Если независимое воспроизведение подтвердит заявленные цифры, Psi-Spec станет реальной альтернативой draft-model-спекулятивному декодированию в открытых inference-стеках: часть команд сможет заменить DFlash и Eagle3 на него ради меньшей памяти и простоты, а интеграция в serving-контуры снизит себестоимость запроса.
Почему это важно для пользователей
Для читателей это конкретная открытая реализация, которую можно воспроизвести уже сейчас: веса Uno 8B, Uno 1B и Uno Qwen3 8B лежат на Hugging Face без токена, а код инференса открыт под Apache-2.0. Инженер может развернуть inference.py с линейным или tree-сэмплированием, замерить TPF и TPS на собственном железе и сравнить с DFlash и Eagle3 в том же стеке. Сегодня это инструмент для бенчмаркинга: на его основе можно оценить ускорение на собственном workload и решить, стоит ли переходить с классического спекулятивного декодирования.
Что пока неизвестно / ограничения
Все количественные заявления — до 3x, превосходство throughput над DFlash и Eagle3, а также выигрыш Uno 8B над 26B DiffusionGemma и проприетарным Mercury 2 на бенчмарках агентного tool use, кодинга и long-context reasoning — являются данными самих авторов. В доступных источниках нет признаков независимой верификации равенства распределений и реальных ускорений, нет абсолютных цифр латентности (TPOT), hosted API и поддержки в крупных инференс-платформах. До независимого воспроизведения это крепкий исследовательский артефакт, а не production-ready решение.
Источники
- Unlocking Lossless Speedups in LLMs via Discrete Diffusion — project page (IFM + Cerebras)
- arXiv:2609.04010 — Unlocking Lossless Speedups in LLMs via Discrete Diffusion
- GitHub: ifm-ai/uno — код инференса, обучения и оценки (Apache-2.0)
Автор
Look at AI, редакция