9 сентября 2026 года Tencent (Hunyuan) открыла исходный код AuK — speech foundation-модели на 1.5B параметров под лицензией MIT. В ней синтез, редактирование, очистка и разделение речи объединены в одной модели, которая управляется командами на естественном языке.


Что произошло
В релиз вошли веса tencent/AuK и tencent/AuK-Flash, код, технический отчет (arXiv:2609.08936), Python API, ComfyUI-ноды и пайплайн fine-tuning, а поддержка в SGLang-Omni появилась в день публикации. Через единый instruction-интерфейс AuK выполняет zero-shot TTS и клонирование голоса по референсу, TTS по описанию без референса (Instruct TTS), заменяет, вставляет и удаляет слова в готовой записи, переписывает текст песни с сохранением мелодии, настраивает питч, скорость и громкость, меняет эмоцию и тембр, удаляет акцент и нечленораздельные звуки, переводит речь в шепот, а также делает денойзинг, разделение говорящих, выделение вокала из микса и извлечение целевого спикера по сказанному. Отдельно выпущена AuK-Flash — дистиллированная версия с 4-шаговым инференсом без classifier-free guidance, ускоряющая вывод в 4,5 раза по wall-clock. По данным техотчета, instruction tuning выполнялся на примерно 3,03 млрд instruction-примеров и 1,95 млн часов надзора.
Контекст
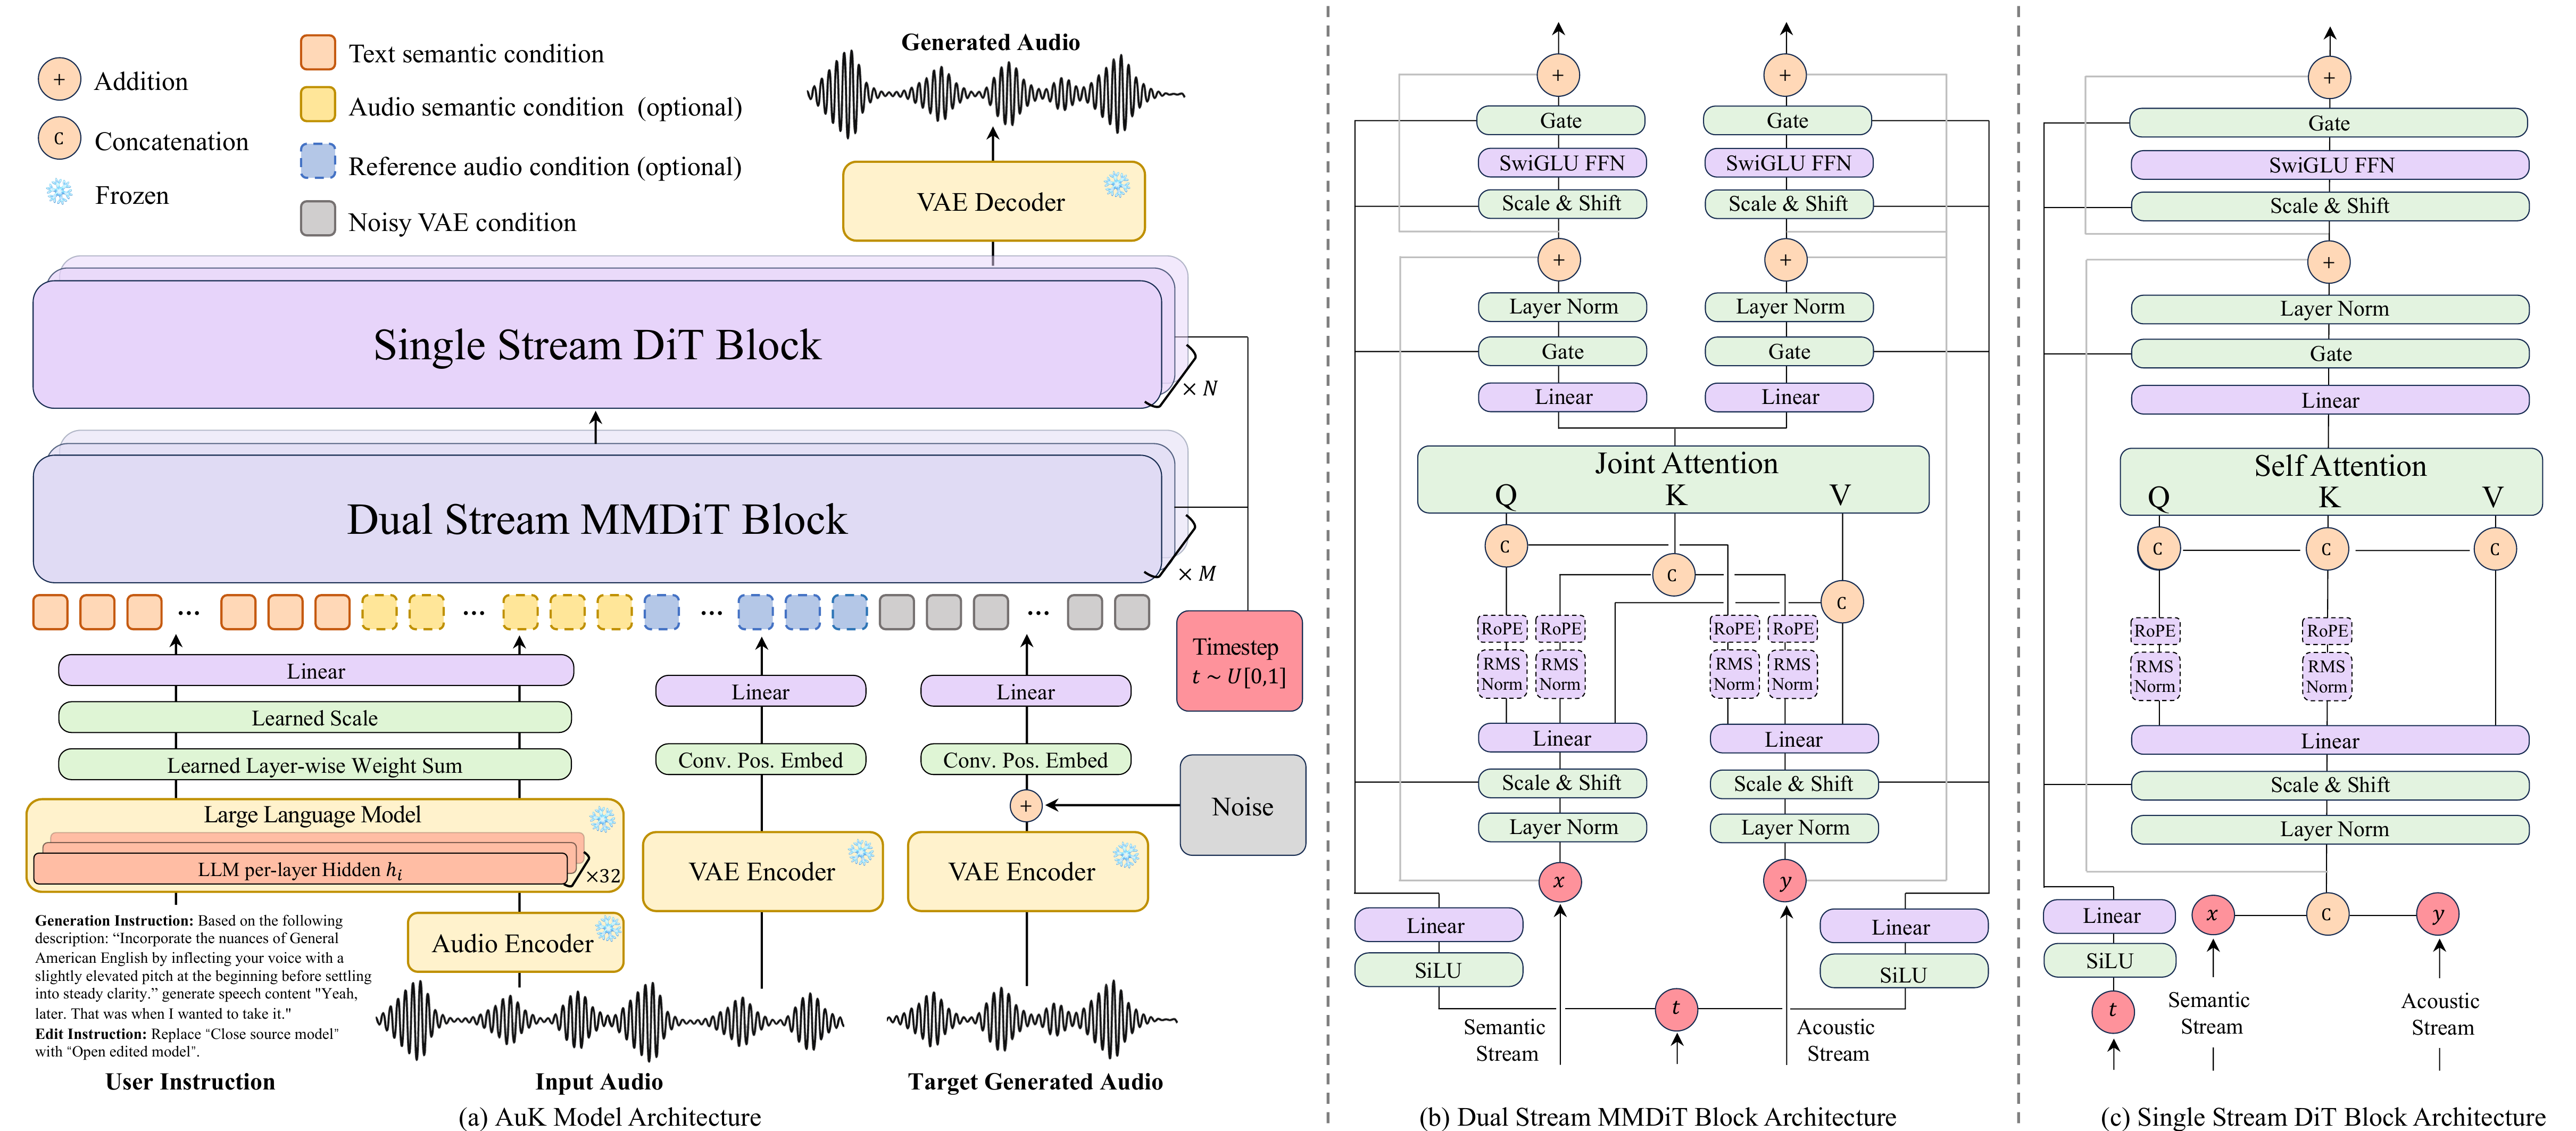
Системы синтеза и обработки речи до сих пор обычно строились как набор отдельных task-specific моделей и закрытых API, а сама генерация звука опиралась на autoregressive-расшифровку последовательностей. AuK использует иную схему: мультимодальный LLM-энкодер Qwen2.5-Omni-3B работает в связке с audio-VAE, обученным на речи, общем аудио и музыке, и гибридным rectified-flow трансформером, в котором сначала идут двухпоточные MMDiT-блоки, а затем однопоточные DiT. Генерация и редактирование строятся на flow matching, а не на autoregressive-расшифровке, что позволяет одной модели работать и с новым звуком, и с уже записанным материалом.
Почему это важно для индустрии
AuK — одна из первых полностью открытых (MIT) speech foundation-моделей, поэтому она задает открытый baseline, к которому теперь можно прижимать более крупные закрытые системы. Командам впервые доступно не только API, но и само ядро голосового функционала: веса можно дообучать на собственных корпусах и голосах, встраивать в продукты через SGLang-Omni и ComfyUI, а дифференциация смещается из синтеза речи на уровень воркфлоу и голосовых агентов. Для рынка это прямое давление на цены закрытых TTS-поставщиков: базовые голосовые фичи дешевеют, превращаются в commodity-компонент, а себестоимость прототипа падает почти до нуля.
Почему это важно для пользователей
Пробовать можно сразу: демо работают на HuggingFace и ModelScope, веса tencent/AuK и tencent/AuK-Flash скачиваются, а через Python API и ComfyUI-ноды модель запускается локально. Реалистичные первые сценарии — клонирование голоса по короткому референсу, исправление отдельных слов в готовой записи, денойзинг и выделение вокала из микса. Русский язык официально не заявлен, но мультиязычный энкодер Qwen2.5-Omni-3B оставляет шанс, что он тоже поддерживается, и это стоит проверить на своих данных.
Что пока неизвестно / ограничения
Заявленные цифры — ускорение AuK-Flash в 4,5 раза по wall-clock и результаты на бенчмарках генерации, редактирования, очистки и разделения — взяты из техотчета Tencent и требуют независимой проверки. Насколько качество AuK-Flash уступает полному инференсу после дистилляции, в открытых материалах не раскрывается. В них также нет реальных показателей latency, throughput и требований к GPU, так что для production модель пока остается на уровне PoC, а качество на русском языке не заявлено и не подтверждено.
Источники
Автор
Look at AI, редакция