DeepSeek 10 сентября 2026 года выпустила DeepSeek-V4.1-Flash — наименьшую модель в новой линейке архитектур с нативным пониманием изображений. Это MoE на 552B параметров с архитектурой Causal Encoder–Decoder (8B активных параметров на вход и 16B на выход) и контекстом до 1M токенов; модель уже доступна в DeepSeek API под именем deepseek-flash, а с 14 сентября к ней переключат и запросы прежнего флагмана deepseek-v4-pro.
Что произошло
Модель уже работает в production: в DeepSeek API она доступна как endpoint deepseek-flash с нативной мультимодальностью и раскатывается в веб- и мобильных клиентах. Прежние отдельные режимы — быстрый, экспертный с reasoning-бюджетом и распознавание изображений — объединены в одну модель, которая сама определяет сложность запроса и включает зрение, когда на входе приходит изображение. Открытые веса опубликованы на Hugging Face под именем deepseek-ai/DeepSeek-V4.1-Flash вместе с техническим отчётом. С 10 сентября 2026 года действует новый прайс: off-peak-цена в 2 раза ниже пиковой. Старые эндпоинты deepseek-v4-flash и deepseek-v4-flash-vision-exp продолжают работать, временно маршрутизируясь на новую модель, а с 04:00 UTC 14 сентября 2026 года все запросы deepseek-v4-pro также будут уходить на V4.1-Flash.
Контекст
Ключевая техническая новизна — архитектура Causal Encoder–Decoder с асимметричными активными параметрами: 8B на входе против 16B на выходе, то есть разделённые вычислительные бюджеты на входную и выходную части внутри MoE, где доля активных параметров составляет лишь около 1,5–3% от 552B суммарных. В связке с KV-кэшем, который занимает в 4 раза меньше HBM и в 8 раз меньше SSD, чем у предыдущего поколения, это конкретный инженерный механизм снижения стоимости вызовов на длинном контексте. Нативная мультимодальность означает, что зрение не является отдельным режимом: модель сама включает его при получении изображения, а открытость весов и технического отчёта позволяет сторонним командам самостоятельно перепроверить архитектурные заявления.
Почему это важно для индустрии
DeepSeek фактически вытесняет собственный флагман V4-Pro более дешёвой и быстрой V4.1-Flash, и механизм экономии здесь конкретен: экстремальная разреженность 552B MoE с 8B/16B активными параметрами плюс сжатый KV-кэш напрямую снижают стоимость агентских вызовов на длинном контексте, а off-peak-тариф в 2 раза ниже пикового уменьшает затраты на agent-нагрузки. Сегмент «быстрых, дешёвых, мультимодальных» запросов сжимается в одну открытую модель с 1M-контекстом: себестоимость агентных вызовов с зрением падает, а ниша команд, которые продавали «дешёвый инференс» и ручную маршрутизацию между режимами, коммодитизируется. Для разработчиков модель — готовая дешёвая мультимодальная альтернатива GPT/Claude-классу в нише быстрых дешёвых запросов: поддержка уже есть в WorkBuddy/CodeBuddy и OpenCode, а Causal Encoder–Decoder со сжатым KV-кэшем становится ориентиром, который другие лаборатории будут проверять и, вероятно, копировать.
Почему это важно для пользователей
Переключиться на deepseek-flash в DeepSeek API или веб-чате можно прямо сейчас: одна модель ведёт диалог, разбирает картинки и решает сложные задачи без ручного выбора режима, а существующие интеграции со старыми flash-эндпоинтами продолжают работать через автоматическую маршрутизацию, так что ничего ломаться не должно. Для self-host существует vLLM-рецепт: требуется vllm 0.30.0 или новее, по оценке vLLM минимум около 614 ГБ VRAM, готовый Docker-образ vllm/vllm-openai:deepseekv41-flash; вместе с 1M-контекстом это вариант локального мультимодального агента. Новый прайс уже действует: если нагрузки можно сдвинуть в off-peak, их цена вдвое ниже пиковой.
Что пока неизвестно / ограничения
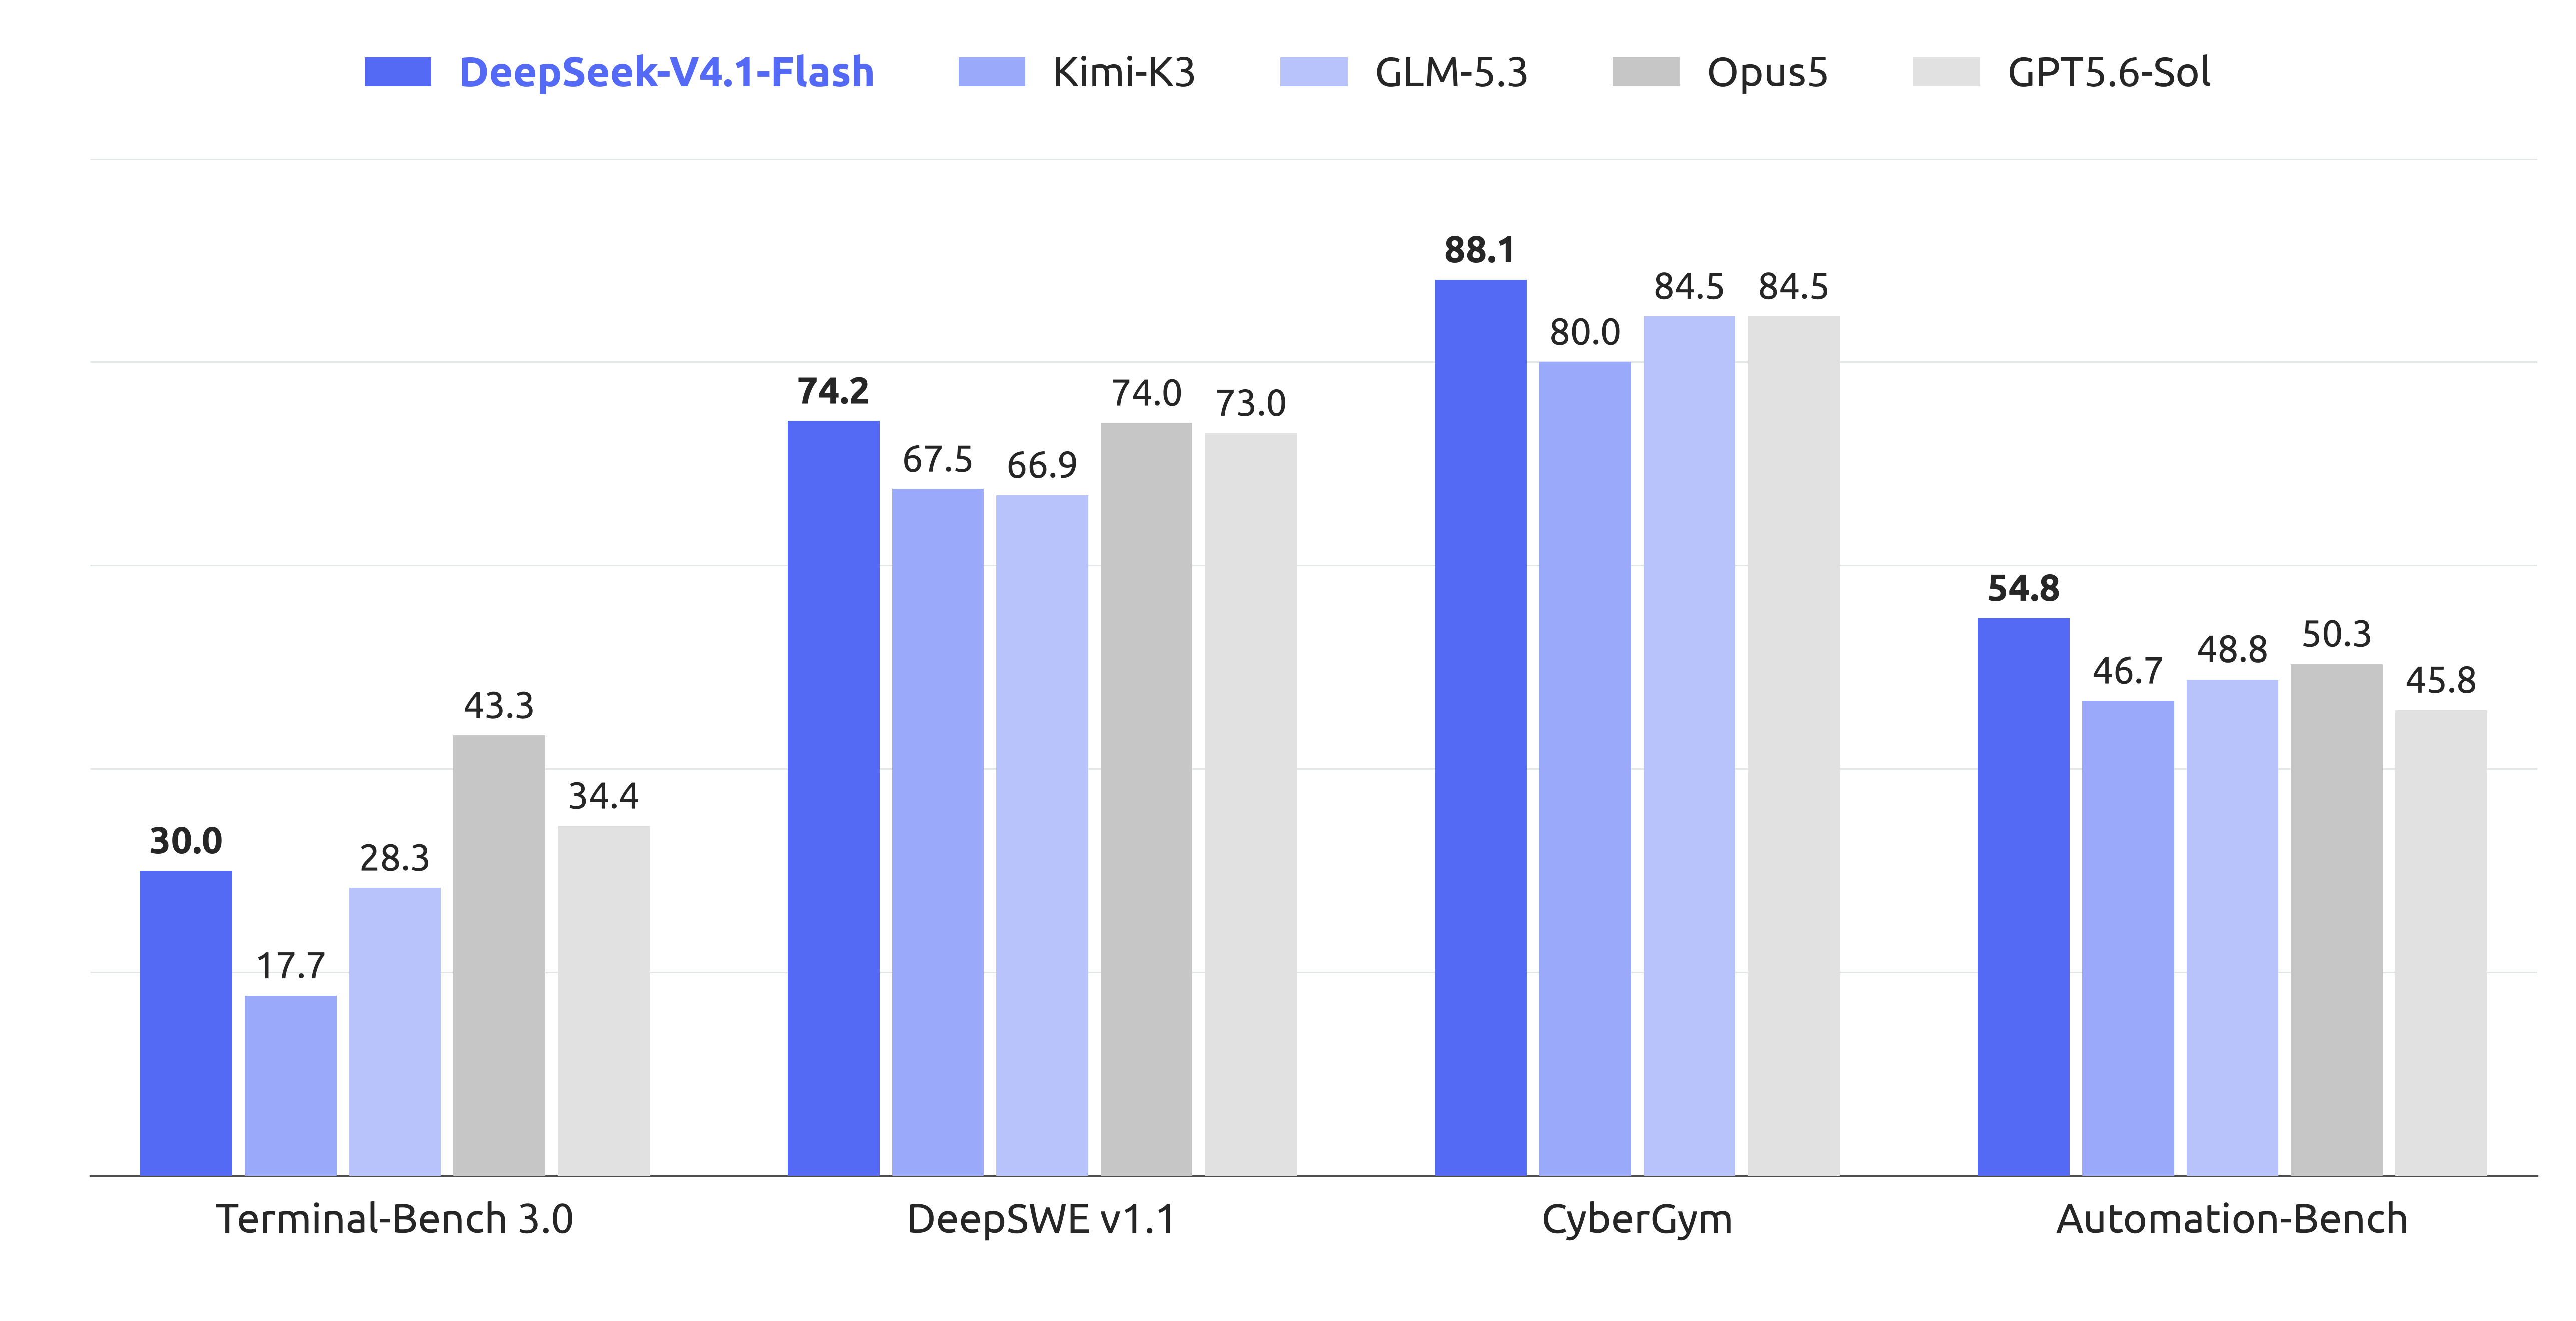
Заявление DeepSeek о том, что V4.1-Flash обходит V4-Pro по качеству, стоимости, скорости и общему времени выполнения, подтверждено пока только материалами самой компании, включая график «DeepSeek-V4.1-Flash agentic benchmark comparison» со страницы новостей: независимых бенчмарков ещё нет. Механизм того, как модель сама определяет сложность запроса и переключается между быстрым и экспертным режимами, в опубликованных материалах не описан детально. Фактическое сжатие KV-кэша и снижение стоимости на реальных масштабах инференса предстоит проверить сторонним командам, опираясь на открытый технический отчёт.
Источники
- Официальная страница новостей DeepSeek: Introducing DeepSeek-V4.1-Flash: smarter, faster, more efficient
- Модель и технический отчёт deepseek-ai/DeepSeek-V4.1-Flash на Hugging Face
- Инструкции по деплою DeepSeek-V4.1-Flash на vLLM Recipes
Автор
Look at AI, редакция