Инженерная группа Sail Research опубликовала разбор оптимизации prefill для модели Gemma 4 31B на узле из четырёх чипов TPU v6e в стеке SGLang-JAX: утилизация чипов выросла с ~32% до ~63% MFU, пропускная способность при промпте в 8192 токена увеличилась с 18 228 до 36 669 токенов в секунду, а время до первого токена (TTFT) сократилось с 449,4 до 223,4 мс. Рецепт построен на укрупнении query-блоков в Ragged Paged Attention, коллективных матричных умножениях вместо монолитного AllReduce и собственных Pallas-кернелах.
Что произошло
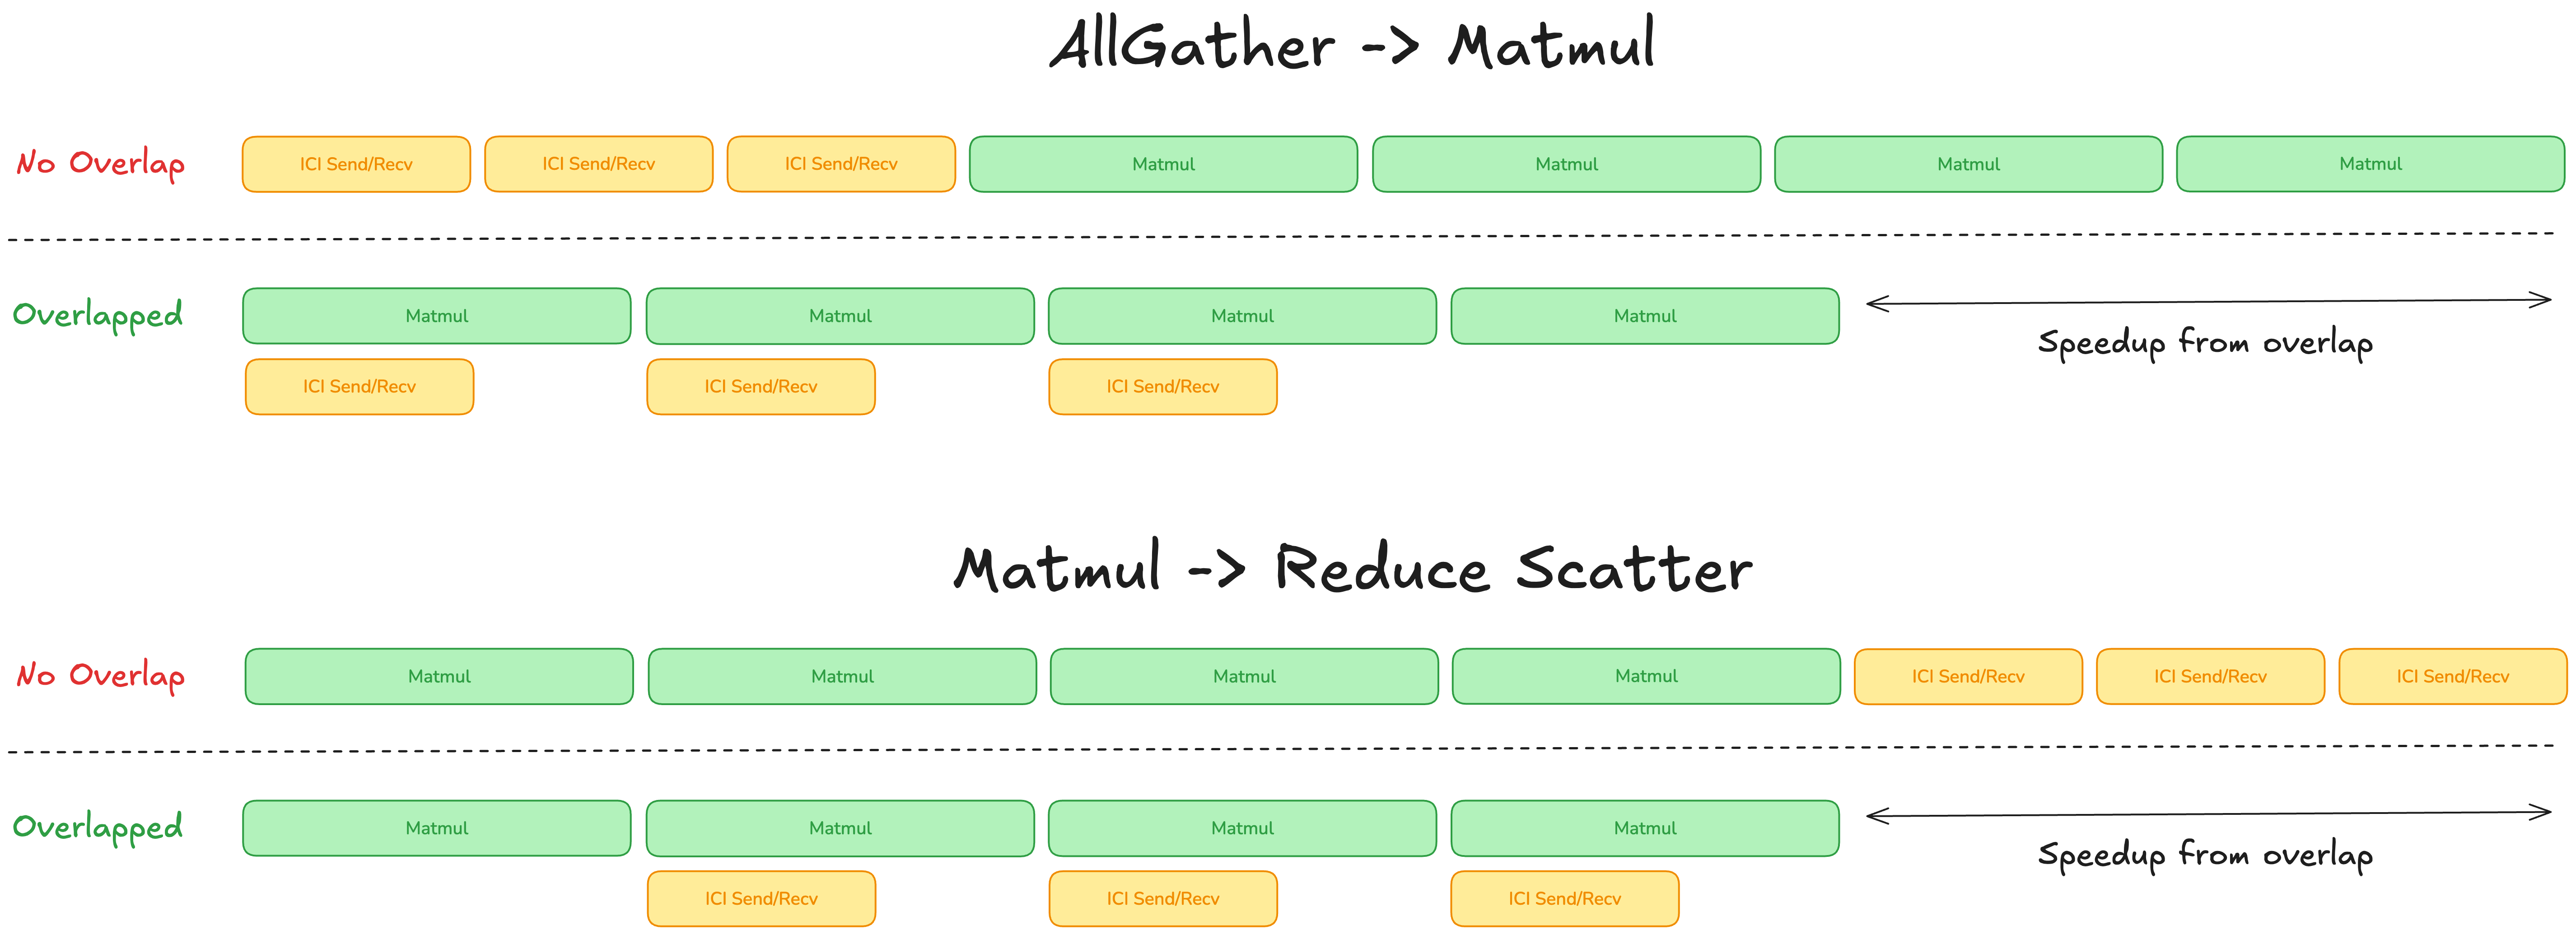
9 сентября 2026 года Sail Research под авторством Ben Mayer выпустила материал Chasing Speed of Light on TPU v6e — 16-минутный инженерный разбор того, как выжать максимум из prefill-фазы Gemma 4 31B на узле из четырёх чипов TPU v6e, соединённых топологией 2x2, поверх стека SGLang-JAX. Первый приём — увеличение размера query-блока в Ragged Paged Attention с 32 до 512, чтобы attention обрабатывался крупными порциями и меньше ресурсов уходило на накладные расходы мелких операций. Второй — замена монолитного AllReduce на коллективные матричные умножения (collective matmuls), наложенные непосредственно на вычисления поверх кольцевой межчиповой сети ICI. Третий — собственные Pallas-кернелы, написанные потому, что автоматическое слияние коллективных операций в компиляторе XLA оказалось недостаточно эффективным. Каждое утверждение в материале сопровождается профилями в Perfetto и XProf, а сам разбор вытекает из недавнего открытого релиза инструмента HTDYM (How To Deploy Your Model).
Контекст
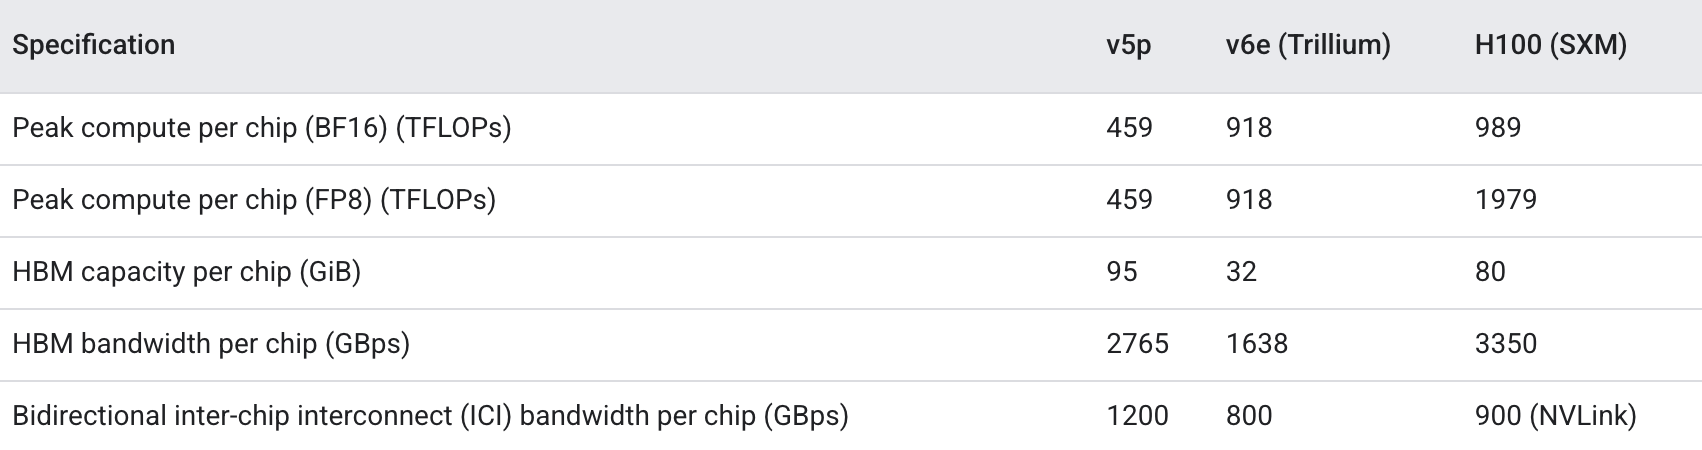
Prefill — это фаза инференса, в которой модель обрабатывает весь входной промпт до генерации первого токена; при длинных контекстах и батч-обработке именно она определяет скорость ответа, поэтому RAG-системы, long-context агенты и пакетная обработка относятся к prefill-нагруженным workload'ам. MFU показывает, какая доля пиковой производительности чипа реально затрачивается на вычисления, так что исходные значения означали, что более двух третей возможностей чипов не доходило до полезной работы. TPU v6e — ускоритель, у которого BF16 FLOPs находятся на уровне H100, но объём памяти HBM в 2,5 раза меньше, а пропускная способность межчиповой сети ICI составляет порядка 180 GB/s против примерно 400 GB/s у AllGather на H100: чип силён вычислениями, но ограничен памятью и межчиповым обменом. Материал продолжает открытый релиз HTDYM (How To Deploy Your Model) от 27 августа 2026 года — симулятора, который позволяет моделировать производительность инференса и выбирать чип ещё до закупки железа.
Почему это важно для индустрии
Для отрасли материал меняет логику выбора железа под инференс малых и средних моделей: вопрос «какой чип быстрее» уступает вопросу «какой чип дешевле под конкретный workload». По оценке Sail Research, память HBM формирует более 63% стоимости производства ускорителя, поэтому чип с сопоставимыми FLOPs, но меньшим объёмом памяти, выигрывает по цене именно на prefill-нагрузках. На этом фоне TPU v6e становится экономически привлекательным опционом для RAG-систем, long-context агентов и батч-обработки, а представленный путь оптимизации — воспроизводимым рецептом повышения MFU на нестандартных архитектурах. Команды, уже работающие на TPU v6e и JAX, получают проверенную последовательность шагов к сокращению TTFT и росту throughput без замены железа, а HTDYM позволяет обосновать выбор чипа моделированием ещё до закупки. Если результаты подтвердятся на других моделях и топологиях, ниша ускорителей, сильных по FLOPs и слабых по памяти, может систематически закрепиться в инференс-рынке.
Почему это важно для пользователей
Читателю материал полезен как рабочий кейс, а не анонс: в нём точные цифры, профили в Perfetto и XProf и объяснение, в какой момент компилятор XLA перестаёт справляться и приходится спускаться на уровень собственных Pallas-кернелов. Главный практический урок в том, что в инференсе узким местом часто оказываются не FLOPs, а коммуникации между чипами и «хвост» мелких операций, поэтому профилирование и тюнинг окупаются быстрее смены железа. Два артефакта доступны сразу: открытый симулятор HTDYM, с которым можно прикинуть производительность и стоимость до покупки чипов, и сами рецепты оптимизации для стека SGLang-JAX. Для разработчиков на JAX это готовая последовательность действий, для остальных — публичные ориентиры по MFU, throughput и TTFT, на которые можно опираться при выборе железа под собственные prefill-задачи.
Что пока неизвестно / ограничения
Материал является инженерным блог-кейсом, а не рецензируемой статьёй с ablation-разбором: раскладки прироста MFU по отдельным приёмам нет, поэтому вклад каждой из трёх оптимизаций по отдельности неизвестен. В публикации отсутствуют повторные запуски и оценка дисперсии, а также сравнение с базовыми конфигурациями и другими инференс-стеками. Цифры получены для одной модели, одной топологии 2x2 из TPU v6e и промпта в 8192 токена, так что перенос результатов на другие модели, чипы и длины контекста остаётся недоказанным: воспроизводимость здесь следует понимать как принципиальную, а не как гарантированный исход. HTDYM описан лишь как недавний открытый релиз, без данных о его точности и валидации.
Источники
- Chasing Speed of Light on TPU v6e — Sail Research (Ben Mayer, 9 сентября 2026)
- HTDYM (How To Deploy Your Model) — Sail Research, 27 августа 2026
Автор
Look at AI, редакция