4 сентября 2026 года Anthropic объявила о первом полном машинно-проверенном доказательстве последней теоремы Ферма. Внутренняя исследовательская модель Claude, сопоставимая с Claude Fable 5.1, 11 дней почти автономно формализовала теорему в Lean, а независимое ядро исчерпывающе проверило результат из 13 миллионов строк кода Lean 4. Это не новая математика, а первый случай, когда многолетнюю коммьюнити-задачу формализации знаменитой теоремы закрыл LLM-агентный пайплайн.
Что произошло
Anthropic представила результат 4 сентября 2026 года. Внутренняя исследовательская модель Claude, сопоставимая с Claude Fable 5.1, работала над формализацией в ассистенте Lean почти автономно 11 дней и потребила около 6 миллиардов выходных токенов. Итог — 13 миллионов строк кода Lean 4 (Lean 4.33.1, Mathlib v4.33.0, собранная с исходников), что более чем в 5 раз превышает размер библиотеки Mathlib; в конечном доказательстве использовано 29 500 промежуточных теорем из 30 300 формализованных. Проверка многоуровневая: сборка с нуля 60 475 модулей, сравнение формулировки с собственным утверждением Mathlib через leanprover/comparator v4.33.0 и прогон через независимое ядро Lean, написанное на Rust (nanoda 0.4.13, 1 052 234 декларации). Доказательство опирается только на три стандартные аксиомы Lean, в том числе propext.
Контекст
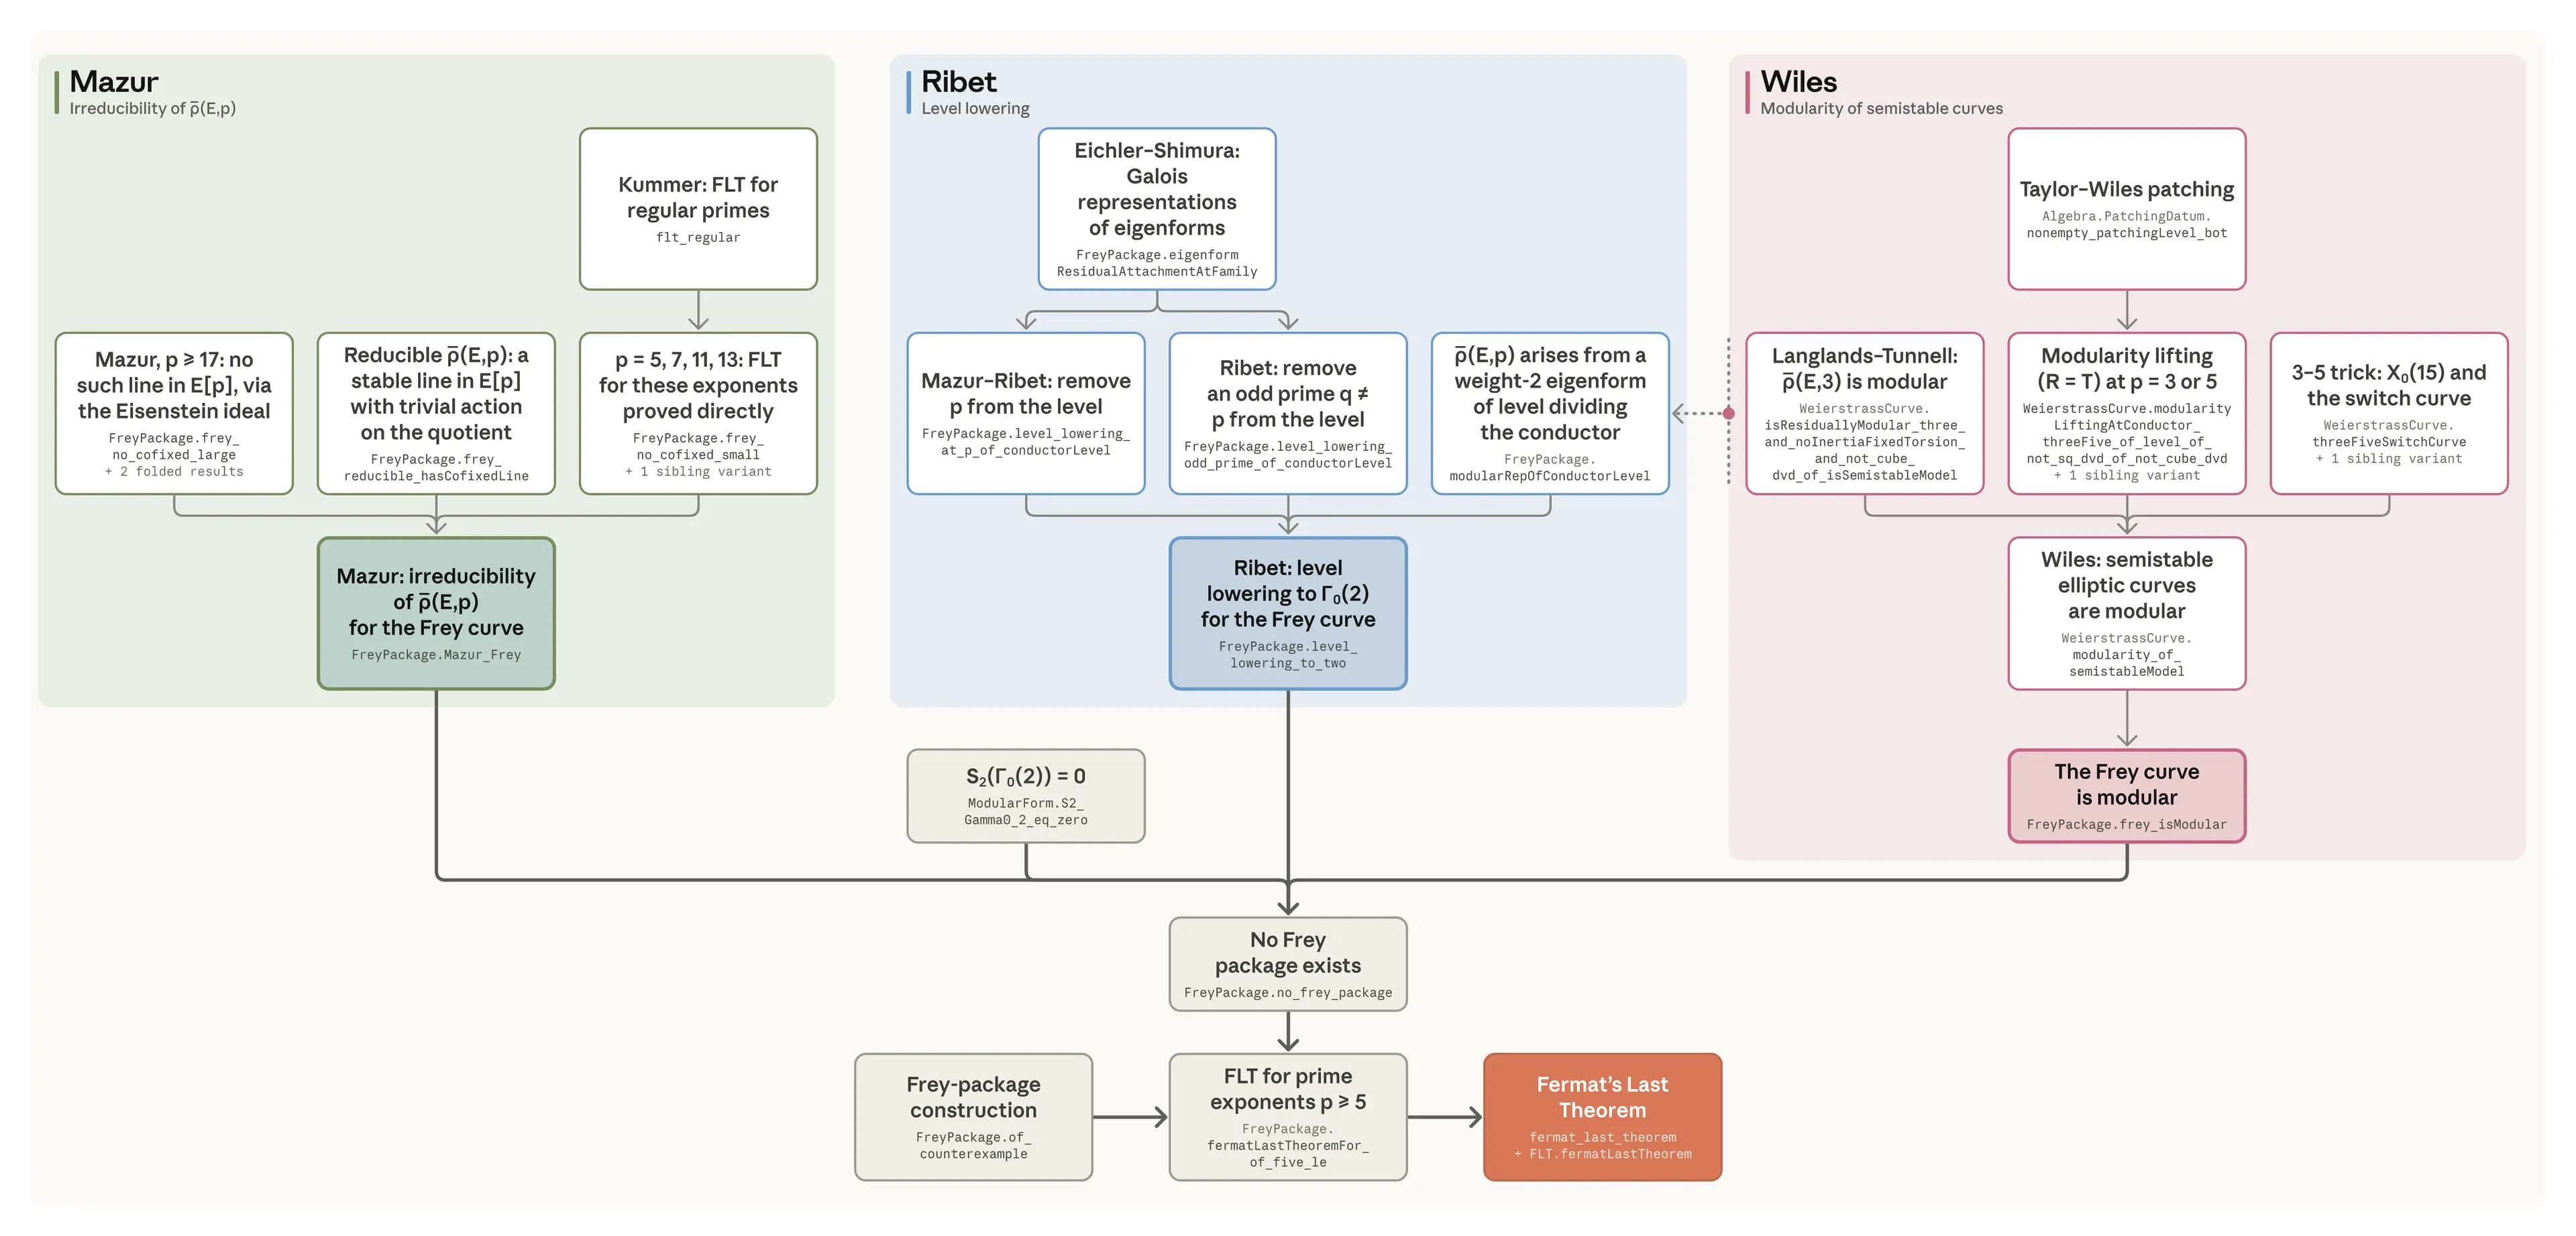
Математическая часть доказательства не нова: формализация следует упрощённой версии аргумента Фрая-Сера-Рибета-Уайлса-Тейлора-Уайлса и превращается в форму, которую ядро Lean проверяет исчерпывающе, то есть это машинная проверка известного аргумента, а не открытие. Lean — ассистент доказательства, а Mathlib — его стандартная математическая библиотека: машинно-проверенное доказательство в такой системе означает, что каждая цепочка шагов проверена программой, а не человеком. Формализация последней теоремы Ферма была многолетней коммьюнити-задачей: её в 2024 году запустил Кевин Базард из Imperial College London как проект ImperialCollegeLondon/FLT, и она воспринималась как чисто человеческая. После публикации proofs коммьюнити не доделало её за год.
Почему это важно для индустрии
Для отрасли ценность — в механизме, а не в теореме. Первый полный машинно-проверенный доказательный граф FLT стал референсным артефактом: контрольная точка смещается от доверия к лаборатории к доверию к проверке, и верифицируемость, а не авторство становится критерием для доказательств и кода, генерируемых ИИ. LLM-агентный пайплайн за 11 дней закрыл задачу, которую коммьюнити не доделало за год, — это меняет экономику длинных агентных задач и демпфирует moat услуг, продающих ручную формализацию. Открытый репозиторий сразу доступен как реперный бенчмарк: для аудита и обучения пайплайнов, как eval-кейс для агентов и как образец интеграции машинной проверки AI-выхода в CI. В ближайшие месяцы ожидаются повторные попытки других лабораторий на других крупных теоремах, первые независимые аудиты proof-графа со стороны коммьюнити Mathlib и сравнения соотношения цены и качества LLM-формализации против человеческих команд.
Почему это важно для пользователей
Доказательство можно изучить и перепроверить самостоятельно, не полагаясь на слова лаборатории. Репозиторий anthropics/fermats-last-theorem открыт под лицензией Apache 2.0 (856 звёзд, 72 форка), содержит полный код Lean 4, файл PROOF-PATH.md и офлайн-версию в папке html/ объёмом около 390 МБ, где можно читать все 29 511 теорем с графом зависимостей. Полная пересборка с нуля занимает около 5 часов 32 минут на 96 потоках, а итоговую проверку делает независимое ядро. Для читателя это публичный пример того, что LLM способны за один длинный автономный цикл — 11 дней и около 6 миллиардов токенов — закрыть задачу, которую люди не довели до конца, и проверить результат может любой.
Что пока неизвестно / ограничения
Это исследовательская демонстрация, а не продукт: API, ценообразование и данные о latency не объявлены, модель внутренняя и не доступна, поэтому генеративную часть нельзя воспроизвести независимо. Нет peer-reviewed описания и публичного агентного harness, а формулировка почти автономно не раскрывает объём человеческого участия, так что заявление о возможностях модели пока опирается на единичную демонстрацию. В источниках также есть небольшое внутреннее расхождение: в сводке — 29 500 использованных теорем из 30 300 формализованных, а в офлайн-HTML-версии — 29 511 теорем; на корректность ядровой проверки это не влияет, но перед цитированием чисел стоит запросить уточнение.
Источники
- Formalizing Fermat's Last Theorem — Anthropic (официальная статья, 4 сентября 2026)
- anthropics/fermats-last-theorem — машинно-проверенное доказательство в Lean 4, Apache 2.0
- Hacker News: Claude formalized Fermat's Last Theorem in 11 days (обсуждение)
Автор
Look at AI, редакция