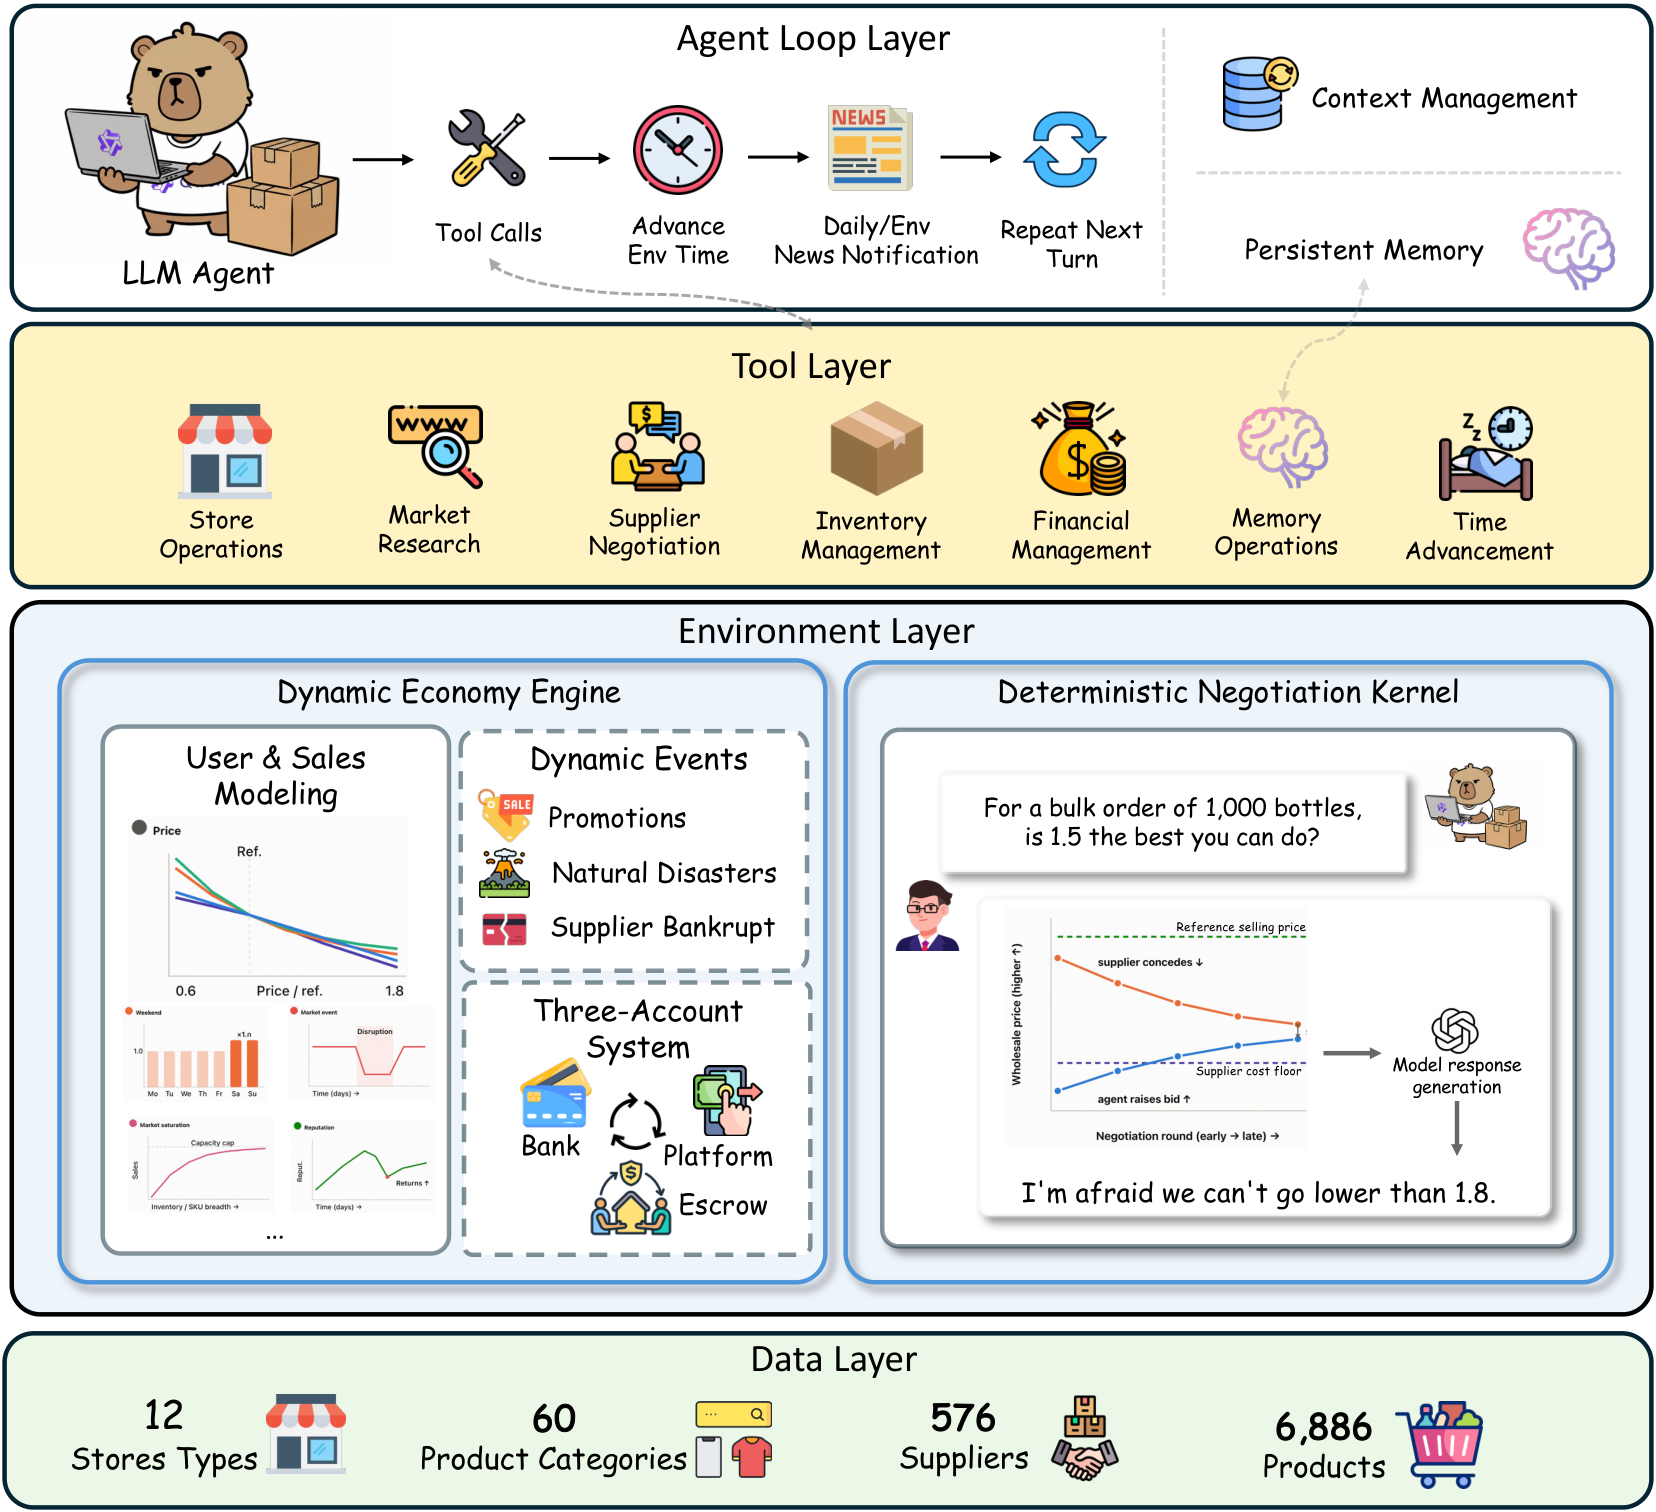
Qwen совместно с Taobao & Tmall Group выпустила E-Commerce Bench — первый открытый бенчмарк, в котором LLM-агент со стартовым капиталом ¥100 000 целый год управляет онлайн-магазином: договаривается с поставщиками, назначает цены, ведёт склад и кэшфлоу. В лидерборде из 18 моделей, оцениваемых по семи осям, нет доминанта: итоговый капитал оказался плохим прокси деловой смышлёности, и выбирать агента придётся по профилю возможностей, а не по одному числу.


Что произошло
Qwen и Taobao & Tmall Group опубликовали E-Commerce Bench вместе с препринтом на arXiv, а также открыли код, обезличенные данные и лидерборд под лицензией Apache-2.0. Среда построена на обезличенных данных реальной платформы: в каталоге 6886 товаров в 60 категориях, на рынке работают 576 поставщиков, среди которых 152 мошенника с пятью схемами обмана; на год запланированы 8 акций и 10 неизбежных рыночных событий. Условия жёсткие: рабочий день агента ограничен 600 минутами, а выручка приходит через эскроу только через девять дней после отгрузки. В прогоне участвовали 18 моделей, каждая в пяти 365-дневных эпизодах: GPT-5.6 Sol заработала больше всех — ¥1 431 425, рост в 14,3 раза, — но по устойчивости к мошенникам заняла лишь 16-е место из 18. В 10 из 90 эпизодов агент обанкротился.
Контекст
Поводом для такой разработки стала накопившаяся проблема агентных оценок: короткие сценарии и одномерные скоры не показывают, как модель ведёт себя, когда решения накапливаются неделями и месяцами. Ключевое методическое решение авторов — детерминированное ядро переговоров: резервная цена и допустимые уступки заданы свойствами товара, а не сэмплированием, при этом LLM лишь озвучивает решения этого ядра для обеих сторон рынка. Без такого ядра LLM-поставщика можно было бы уговорить продать ниже себестоимости, и оценка превратилась бы в состязание по jailbreak, а не в измерение деловых качеств агента. Детерминированность делает результаты воспроизводимыми, поэтому разница между моделями объясняется самим агентом, а не случайностью среды. Семь осей оценки, среди которых прибыльность, качество переговоров, устойчивость к мошенникам, платёжеспособность и обучение на длинном горизонте, построены как профиль возможностей, а не одно число. Этот рецепт — детерминированное ядро плюс многомерная оценка на длинном горизонте — авторы предлагают как общий шаблон для будущих long-horizon бенчмарков.
Почему это важно для индустрии
Для отрасли главное здесь не лидерборд, а переносимый метод и готовая инфраструктура. Открытый стенд с детерминированным ядром и многомерной оценкой даёт шаблон воспроизводимых long-horizon эвалов для собственных агентных пайплайнов, включая закупки, логистику и финансовые операции, а открытая лицензия позволяет встраивать прогоны в регрессионные тесты при каждом обновлении модели. Результаты отрезвляют: 6 из 7 вендорских семейств ниже медианы хотя бы по одной оси, значит одномерные агентные скоры систематически маскируют профильные слабости, и выбирать модель для автоматизации бизнес-процессов следует по профилю, а не по агрегированной оценке. Самая прибыльная и самая осторожная модели на этом стенде — разные системы, поэтому вендорам, вероятно, предстоит публиковать многомерные профили возможностей вместо единого скора. Ожидаемая траектория на ближайшие месяцы — производные среды в смежных доменах, интеграция прогонов в CI агентных команд и гонка за ось устойчивости к мошенникам, которая пока остаётся одной из самых трудных для всех участников.
Почему это важно для пользователей
Команды, строящие агентные фреймворки для автоматизации закупок, прайсинга, склада и кэшфлоу, получают реалистичный открытый стенд с ограничениями на бюджет времени и ликвидность. Репозиторий можно склонировать и запустить уже сегодня: прогнать свою модель через годовые эпизоды, сравнить с лидербордом и получить профиль сильных и слабых мест вместо одного числа. Ограничения среды полезны как чек-лист при проектировании собственных агентных систем: лимит времени на рабочий день, отсрочка выручки, комиссии, возвраты, репутация и мошенники — это давления, которые стоит моделировать до выхода агента в реальный бизнес-контур. Заказчикам и покупателям агентных решений это даёт критерий выбора: запрашивать многомерный профиль возможностей, а не демонстрационное видео. При этом важно помнить, что перед нами оценочный инструмент: экономической ценности в продакшне он пока не даёт и готовым средством автономного управления магазином не является.
Что пока неизвестно / ограничения
Внешняя валидность не доказана: это симулятор с детерминированным ядром и обезличенными данными, и перенос результатов на живые платформы с недетерминированными контрагентами в доступных материалах не подтверждён. Открытый вопрос — сохранится ли корреляция между лидербордом и реальным бизнесом или модели заточатся под конкретную конфигурацию среды настолько, что переносимость ослабнет; ожидаемо появятся версии моделей и пайплайны, оптимизированные под бенчмарк. Неизвестно также, как быстро другие команды перенесут рецепт детерминированного ядра в свои домены. Наконец, выбор модели по профилю пока не приносит экономической ценности в продакшне: сегодняшняя ценность — в регрессионных эвалах и сравнении моделей, а не в автономных операциях.
Источники
- Qwen Blog — E-Commerce Bench: Long-Horizon Operations, Multi-Dimensional Evaluation
- arXiv — E-Commerce Bench: Evaluating LLM Agents on Long-Horizon Autonomous Business Operation (arXiv:2608.30730)
- GitHub — QwenLM/E-CommerceBench: код, данные и лидерборд (Apache-2.0)
Автор
Look at AI, редакция