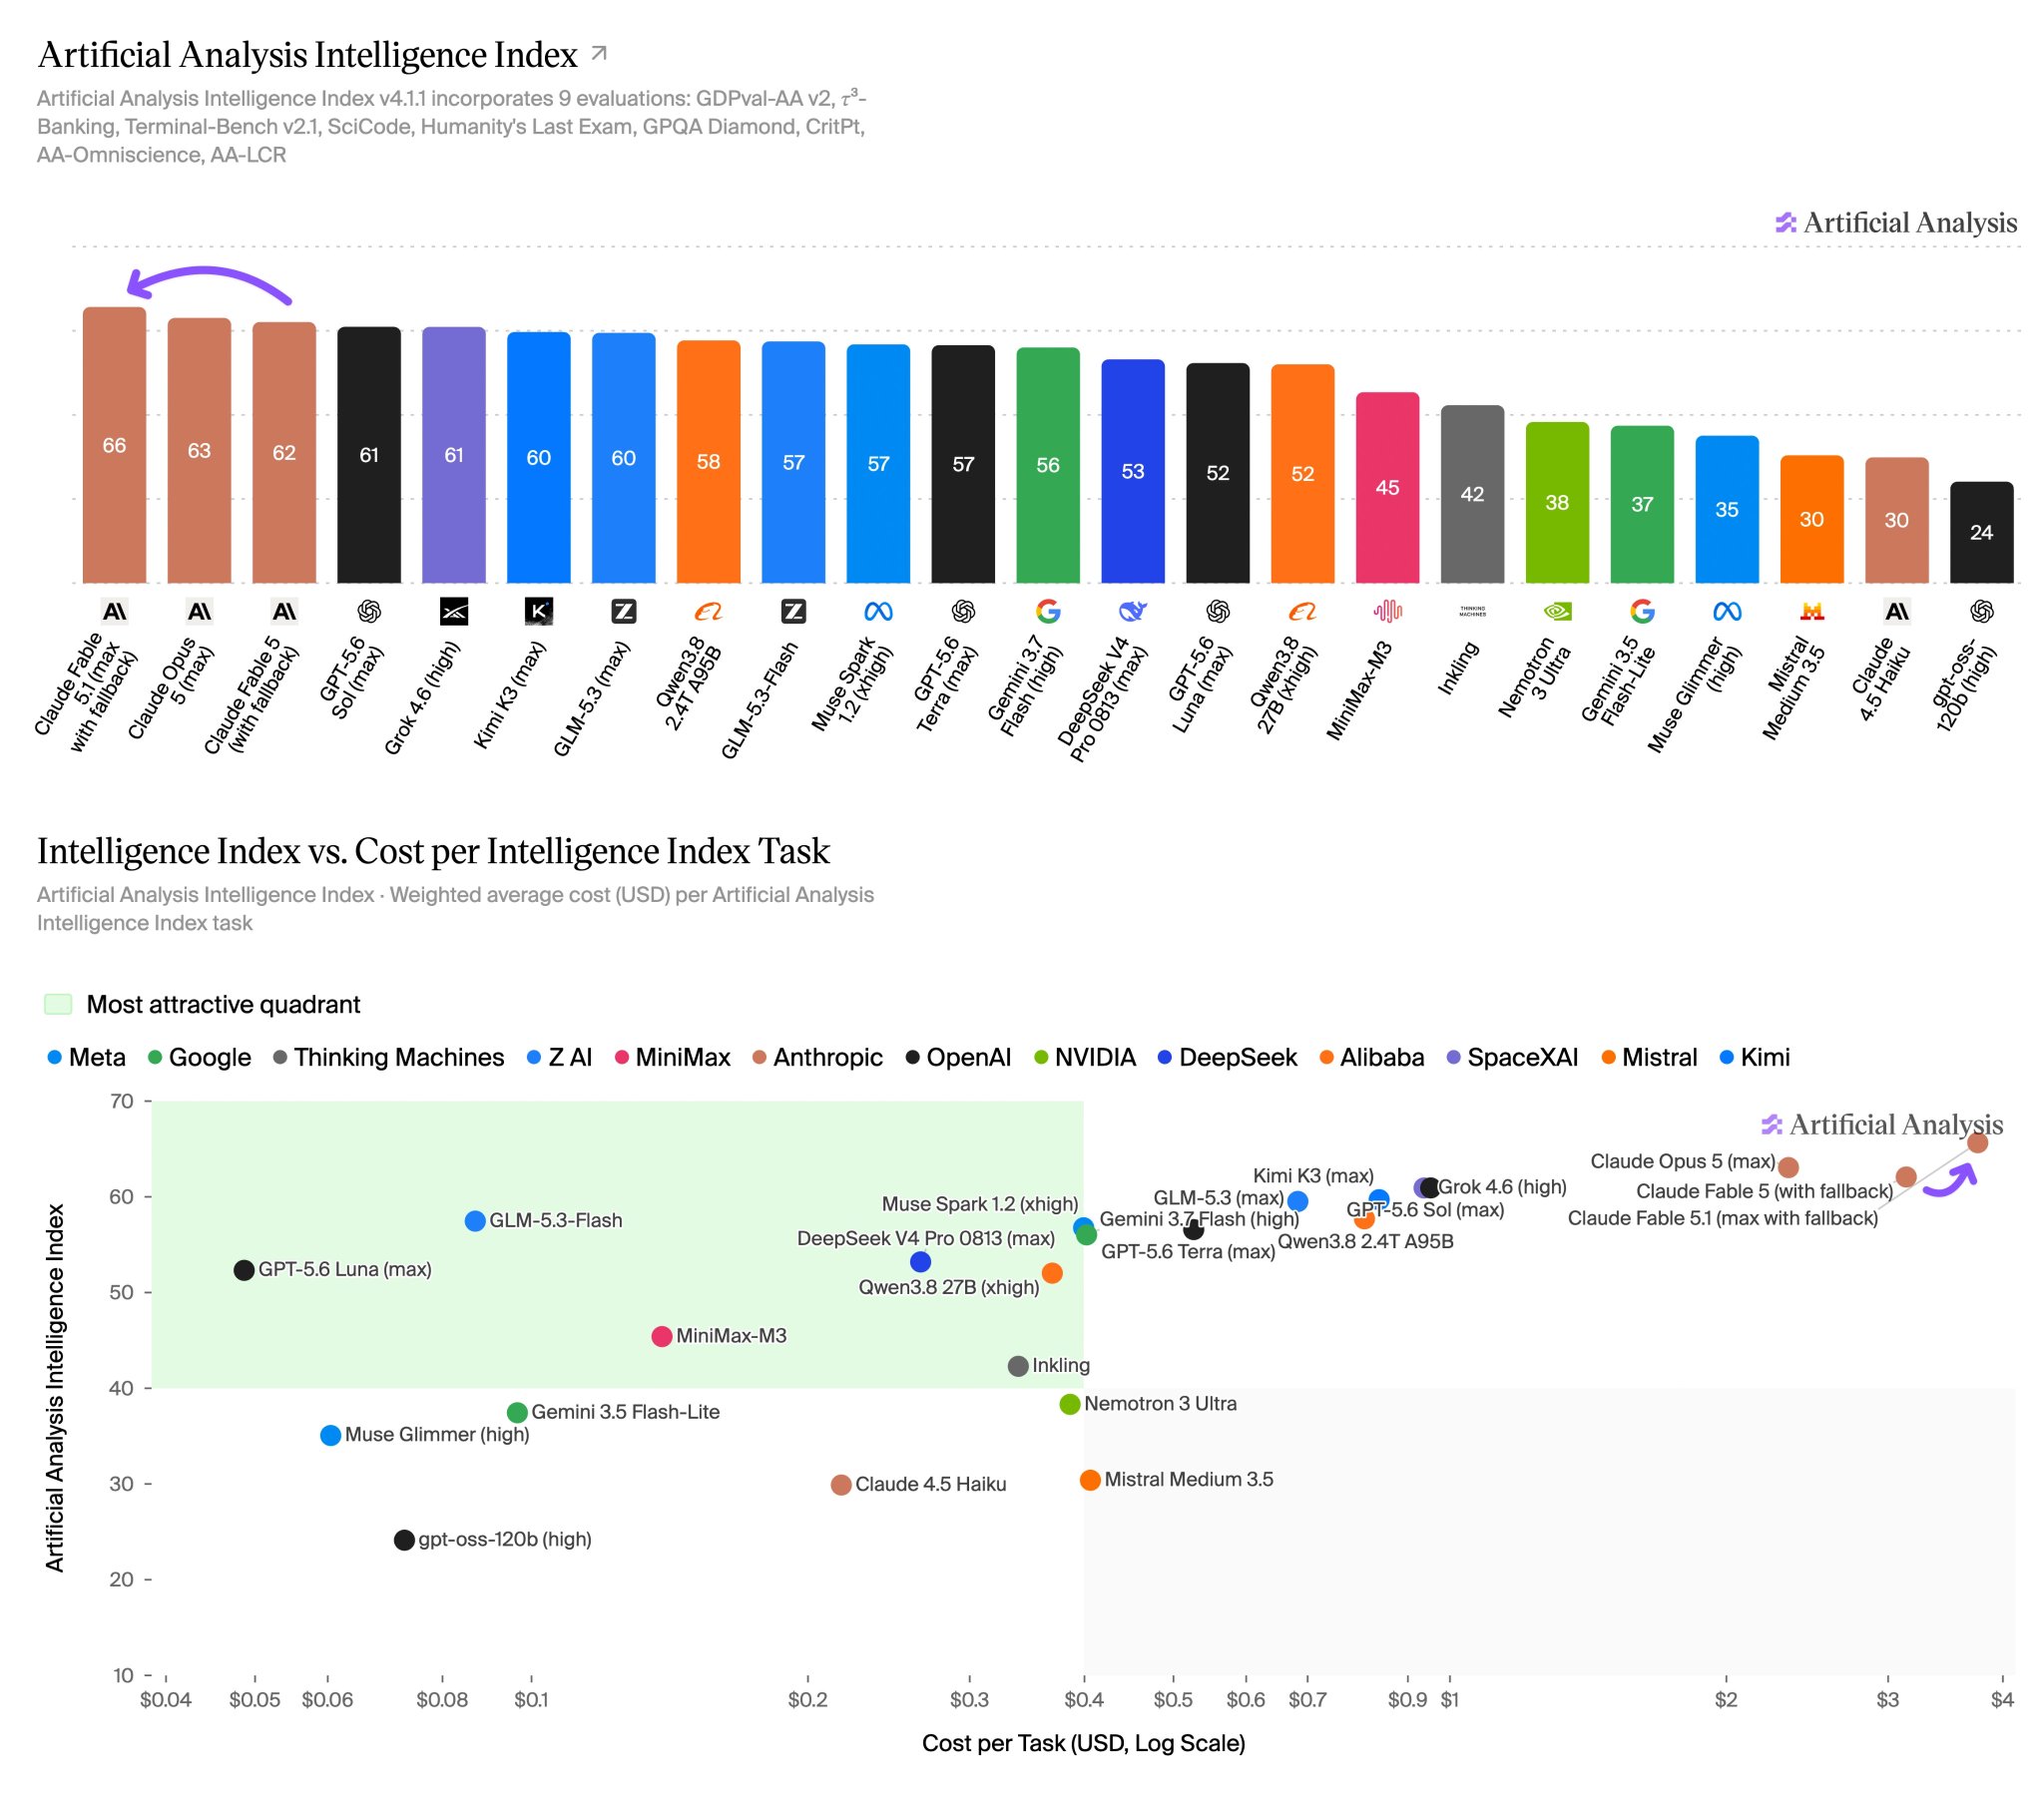
Anthropic 1 сентября 2026 года выпустила Claude Fable 5.1, и в тот же день Artificial Analysis опубликовала первую независимую оценку модели. На максимальном уровне усилий (max effort) Fable 5.1 набрала 66 баллов в Intelligence Index — высший результат из когда-либо измеренных, на 4 балла выше предыдущей Claude Fable 5 и выше Claude Opus 5 (63) и GPT-5.6 Sol (61). Рекорд достался не бесплатно: стоимость решённой задачи выросла на 20%, потому что модель тратит заметно больше выходных токенов, а итоговая экономика теперь решающим образом зависит от выбранного режима усилий.
Что произошло
Fable 5.1 установила новые лучшие измеренные значения сразу на трёх бенчмарках: 59,1% на Humanity's Last Exam, 91,4% на Terminal-Bench v2.1 и 62,0% на SciCode. Рост цены оказался следствием конкретного механизма: на уровне max effort модель расходует примерно в 1,7 раза больше выходных токенов по $50 за 1M, поэтому стоимость задачи поднялась с $3,14 у Claude Fable 5 до $3,76. Частично это компенсировало снижение цены чтения кэша на 75%, с $1,00 до $0,25 за 1M токенов, что сэкономило около $1,40 на задачу; без этой скидки стоимость составляла бы примерно $5,16. Подключить модель можно уже сейчас: claude-fable-5-1 доступна в Claude API, Amazon Bedrock, Google Cloud и Microsoft Foundry.
Контекст
Понять новую экономику помогает разброс между режимами усилий: low и max расходуют 13,1M и 143,7M токенов, то есть отличаются в 11 раз, при разнице баллов всего от 58 до 66. Рекорд получен в самой дорогой точке кривой «качество за инференс-компьют», и именно на этом уровне измерены все лидерские значения. Структура тарифов при этом не изменилась: контекст 1M токенов, вход $10 и выход $50 за 1M, как у Fable 5; сдвиг произошёл в кэше, и Anthropic фактически перенесла экономику в пользу кэширования длинного контекста. Это структурный сигнал для агентных систем, которые живут на повторных запросах с большим неизменяемым префиксом.
Почему это важно для индустрии
Интеллект стал покупаться уровнями усилий, и это важнее самого рекорда. Режим xhigh даёт 65 баллов за $2,72 за задачу, то есть почти отдачу флагмана на 28% дешевле max; для сборщиков продуктов это означает, что выигрывает не тот, кто выбрал лучшую модель, а тот, кто нашёл рабочую точку на кривой «качество за инференс-компьют». Пайплайны, работающие на max effort, автоматически дорожают, и юнит-экономику придётся пересчитывать явно. Агрегированный индекс без нормировки на стоимость может искажать картину лидерства, поэтому, если тренд сохранится, независимым рейтингам придётся публиковать результаты в привязке к уровню усилий и цене за задачу. Ожидаемая реакция экосистемы — режимы усилий как явная ручка роутинга в оркестраторах и cost-per-task как основная метрика сравнения наряду с баллами; пока это интерпретация, а не свершившийся факт.
Почему это важно для пользователей
Если вы выбираете модель для агентов и долгих задач, Fable 5.1 сейчас сильнейший вариант по умолчанию, но проверяйте режим усилий. Практически выгодная конфигурация — xhigh: 65 баллов за $2,72 за задачу против 62 баллов за $3,14 у предыдущего флагмана, то есть качество выше, а расходы ниже. Повторные запросы с большим кэшируемым контекстом стали заметно дешевле: сильнее всего выигрывают сценарии с длинным неизменным префиксом, где чтение кэша доминирует в счёте. Модель доступна в четырёх облаках, поэтому первую проверку можно провести немедленно: воспроизведите оценку на своих задачах и зафиксируйте уровень усилий явно в конфиге оркестратора, не полагаясь на дефолт.
Что пока неизвестно / ограничения
Разница между 65 и 66 баллами получена на агрегированном индексе без доверительных интервалов и разбивки по доменам, поэтому на конкретной задаче разрыв между режимами усилий может оказаться и нулевым, и большим. Методология оценки раскрыта не полностью: число повторов, промпт-шаблоны и правило выбора уровня усилий в публикации не описаны, а корректное сравнение с другими вендорами требует фиксации уровня усилий. Наблюдение, что прирост интеллекта покупается thinking-токенами, сделано по одной модели, поэтому экстраполяции на следующие релизы и конкурентов остаются предположениями.
Источники
- Claude Fable 5.1 Tops Artificial Analysis Intelligence Index
- Claude Fable 5.1 - Claude Platform Docs
- Claude Fable 5.1 tops Artificial Analysis Index but costs 20% more | Hacker News
Автор
Look at AI, редакция