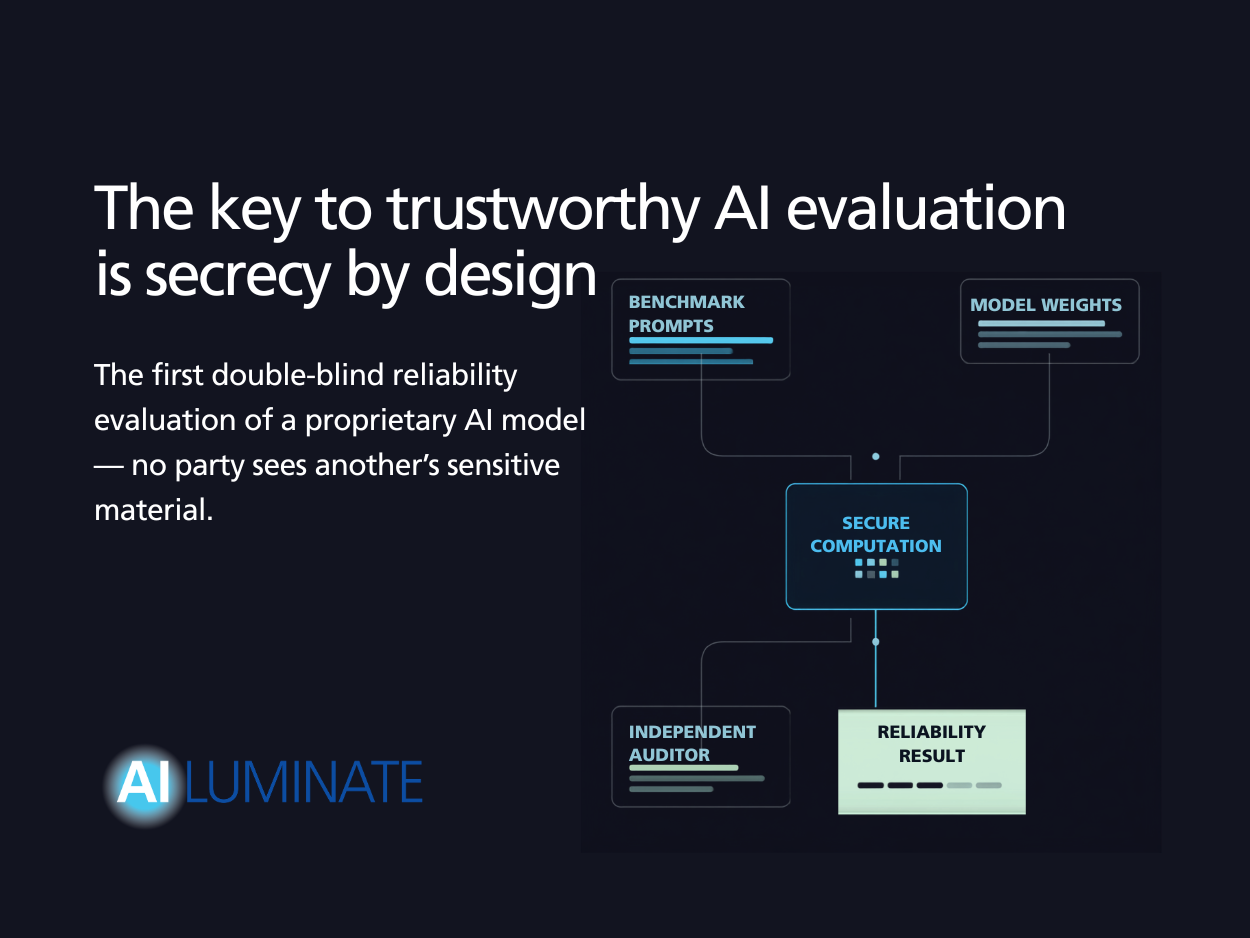
Google DeepMind впервые провела двойную слепую оценку проприетарной frontier-модели: Gemini Flash Lite тестировали четыре внешние организации — AI Safety Institute Сингапура, OpenMined, AVERI и MLCommons — по конфиденциальным бенчмаркам, при этом оценщики не видели весов модели, а Google не видел тестовых промптов. Впервые независимая проверка frontier-системы прошла без взаимного раскрытия секретов, и отрасль получила работающий шаблон такого аудита.

Что произошло
Оценки шли в GPU-анклаве на базе Google Cloud Confidential Space с ускорителями NVIDIA H100 и Intel TDX, аппаратным шифрованием RAM и VRAM (AES-256 / AES-XTS-256), удалённой аттестацией по стандарту IETF RATS и воспроизводимыми сборками; оркестрация выполнялась через PySyft, а политика syft-restrict ограничивала оценщиков allow-list'ом допустимых методов. Накладные расходы на конфиденциальные вычисления составили менее 5%, а анклав после прогона уничтожается без остаточного состояния. Методология и результаты пилота описаны в техническом отчёте DeepMind Double Blind Evals: Resolving the Dual Confidentiality Dilemma in AI Safety Auditing.
Контекст
Мотивация пилота измерима, а не гипотетична. По данным исследования Xu et al., 2024, процитированного в отчёте, признаки утечки тестовых данных обнаруживались примерно у половины из 31 проверенной модели, то есть значительная часть бенчмарков заранее известна оцениваемым системам. Эту картину усугубляет benchmark hacking: в отчёте упомянут случай, когда лаборатория прогнала 27 приватных вариантов модели на Chatbot Arena и опубликовала только лучший результат. Прежний независимый аудит proprietary-моделей упирался в дилемму конфиденциальности: разработчику приходилось либо принимать конфиденциальные промпты оценщиков на своей инфраструктуре, либо отдавать веса модели сторонней организации, и для frontier-моделей схемы, при которой обе стороны сохраняли бы секреты, не существовало. Технологии конфиденциальных вычислений уже были доступны, но до этого пилота не применялись к живым внешним оценкам проприетарных моделей.
Почему это важно для индустрии
Для AI-индустрии двойная слепая оценка впервые даёт криптографически проверяемый механизм независимого аудита frontier-моделей, снимающий дилемму «кто кого первым доверит»: провайдеру больше не нужно раскрывать веса и интеллектуальную собственность, а оценщику — конфиденциальные бенчмарки. Это прямой ответ на benchmark hacking и contamination, подрывающие доверие к лидербордам, и признак зарождения нового инфраструктурного слоя верифицируемых AI-оценок, в котором доверие становится вычислимым. Протокол уже опробован с национальным AI Safety Institute и MLCommons, поэтому его можно рассматривать как шаблон для регуляторных проверок, включая чувствительные сферы вроде кибербезопасности и госсектора. Инженерные команды уже сегодня могут изучать опубликованный стек — Google Cloud Confidential Space, аттестацию по IETF RATS, PySyft с syft-restrict — и прототипировать аналогичные воркфлоу для собственных задач, например аудита RAG-пайплайнов.
Почему это важно для пользователей
Главный практический эффект для читателя — возможность разобраться в первоисточнике: технический отчёт DeepMind это редкий случай, когда конфиденциальные вычисления, включая Confidential Space, H100-энклавы, удалённую аттестацию и PySyft с allow-list'ом методов, применены не на бумаге, а в живом пилоте с внешними организациями. Отсюда же полезная поправка к привычному чтению лидербордов: рейтинги могут опираться на бенчмарки, заранее известные моделям, поэтому к цифрам рейтингов стоит относиться с осторожностью. Важно понимать и встроенное ограничение схемы: она требует доверия к облачному провайдеру и вендору железа, поэтому двойная слепая оценка — это шаг к независимым оценкам, а не их полная гарантия.
Что пока неизвестно / ограничения
Пилот пока единичный: это n=1 на одной лёгкой модели Gemini Flash Lite, перенос протокола на более крупные frontier-модели, другие типы eval-нагрузок и другие анклавы не показан. В источниках нет данных о публично описанном независимом повторении пилота другими командами, а также нет API, прайсинга и данных по латентности, то есть self-service путь для обычных продакшен-пайплайнов отсутствует, и в стандартную практику оценки протокол ещё не встроен. Открытыми остаются вопросы, станет ли протокол частью стандартной практики оценки и распространится ли он на обычные публичные бенчмарки, а не только на конфиденциальные аудиты.
Источники
- Piloting the world's first double-blind AI evaluations — Google DeepMind
- Double Blind Evals: Resolving the Dual Confidentiality Dilemma in AI Safety Auditing — DeepMind technical report (PDF)
- Double-Blind Reliability Evaluation — MLCommons
Автор
Look at AI, редакция