Инженер OpenAI Крис Лири (Chris Leary, команда Intelligence Processors, ранее создатель компилятора XLA в Google) опубликовал 1 сентября 2026 года статью «Compilers 2.0: AI as stochastic optimizer» о том, как AI пишет ядра (kernel) для ускорителей OpenAI. Ключевой пример — MLA-ядро проекта Jalapeño, показанное на HotChips: начиная с кода, почти неотличимого от numpy, AI за 48 часов выдавал оптимизированное ядро с той же семантикой и часто обгонял вручную настроенные версии экспертов. Лири описывает AI как «стохастический оптимизатор», а гарантией корректности называет не построчное чтение кода человеком, а автоматическую проверку семантической эквивалентности.

Что произошло
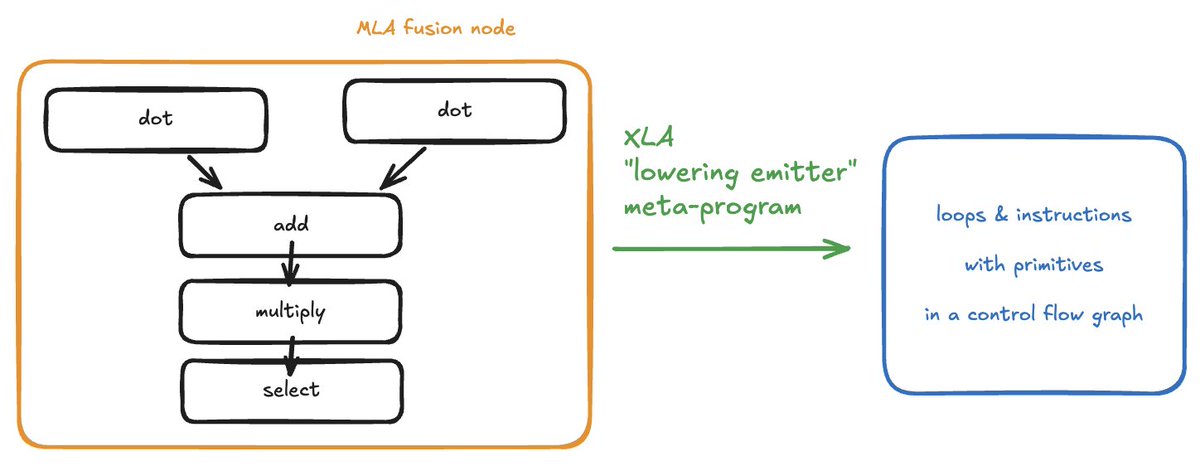
В статье Лири раскрывает устройство пайплайна: AI занимает место метапрограммы-эмиттера в XLA, где одновременно выполняет понижение (lowering) и оптимизацию кода, то есть встроен в компилятор как полноценная стадия, а не подключается снаружи как ассистент. Демонстрационный кейс отсылает к выступлению OpenAI о проекте Jalapeño на HotChips: стартуя с кода, почти неотличимого от numpy, AI за 48 часов поисковой работы выдавал оптимизированное MLA-ядро с той же семантикой, и такие версии часто оказывались быстрее ядер, которые эксперты настраивали вручную. Правильность результата в этой схеме проверяет не человек: её обеспечивает автоматическая верификация семантической эквивалентности, опирающаяся на строгие математические контракты, описанные в статье.
Контекст
Идейная рамка подхода старше самого названия «Compilers 2.0»: стохастическая супероптимизация STOKE появилась ещё в 2013 году, а program synthesis — давнее направление, где программы не пишутся человеком, а ищутся в пространстве вариантов. Новым в статье является не сама идея поиска, а её масштаб и промышленное встраивание: LLM занимает слои пайплайна, где раньше работали ручные эмиттеры и эвристики dataflow-правил. История не возникла на пустом месте — механизм уже вызвал резонанс вокруг выступления OpenAI о Jalapeño MLA-ядре на HotChips и разборов SemiAnalysis, однако развёрнутого первоисточникового объяснения до статьи Лири не было. Дополнительный вес заявке придаёт позиция автора: Лири сам создал XLA в Google и теперь в составе команды Intelligence Processors OpenAI занимается ускорителями, о которых пишет.
Почему это важно для индустрии
Для отрасли это первое развёрнутое первоисточниковое объяснение механизма за нашумевшим выступлением OpenAI о Jalapeño на HotChips. Главный сдвиг в том, что гарантии корректности переносятся с понимания кода человеком на автоматическую проверку эквивалентности: производительность железа начинает зависеть от того, сколько «выстрелов» успел сделать AI-оптимизатор — в примере это 48 часов, — а не только от ручной работы performance-инженеров. Дефицитная экспертиза ручной настройки ядер частично превращается в вычислительный бюджет, и появляется новый trade-off: compute расходуется на оптимизацию, а не только на инференс. Соответственно смещается и ценность команд — от умения писать быстрый код к умению формулировать и проверять строгие контракты. Внешнего продукта пока нет: описанный пайплайн — внутренний инструмент OpenAI, публичного API, репозитория или методологии в источниках не упомянуто. Реальное действие для команд сегодня методологическое: провести инвентаризацию своих пайплайнов на предмет операций со строгими контрактами и усилить автоматическую проверку эквивалентности, например дифференциальными тестами и property-based контрактами.
Почему это важно для пользователей
Читателю статья даёт рабочую рамку вместо магии: AI здесь не «понимает» ассемблер, а делает разумные ходы в пространстве программ — как опытный оптимизатор, только массово. Уровень «ассемблера» при этом просто сдвигается вверх: так же как при компиляции C++ с -O3 никто не читает итоговый машинный код, при AI-оптимизации ядер не предполагается построчный контроль человеком. Отсюда практический ориентир: если операция математическая и для неё можно записать строгий контракт эквивалентности, построчно читать AI-оптимизированный код не нужно — проверять нужно контракт, а не код. Эта рамка заодно помогает трезво оценивать новости о том, что «AI пишет быстрый код»: главный вопрос не в красоте генерации, а в том, есть ли независимая автоматическая проверка результата.
Что пока неизвестно / ограничения
Демонстрация пока одна: речь о dataflow-ядрах ускорителей с математическими контрактами, поэтому вывод о воспроизводимом workflow для любых задач со строгими контрактами — экстраполяция за пределы данных, а переносимость подхода на другие классы задач остаётся гипотезой, а не результатом. Независимой проверки нет: методология, полные бенчмарки и артефакты не опубликованы, публичного API или репозитория в источниках не упомянуто, а разбор SemiAnalysis пока остаётся пересказом без самостоятельных чисел. Неясна и ресурсная сторона: результат зависит от вычислительного бюджета поиска, и сколько «выстрелов» потребуется другим ядрам или доменам, неизвестно. До публикации методологии OpenAI или появления независимых репликаций связку «AI-эмиттер плюс автопроверка эквивалентности» корректно считать заявкой одного авторитетного автора.
Источники
- Compilers 2.0: AI as stochastic optimizer — статья Криса Лири (OpenAI) в X
- Hacker News: обсуждение статьи Compilers 2.0: AI as stochastic optimizer
- Fxtwitter API — зеркало полного текста статьи Криса Лири (без авторизации в X)
Автор
Look at AI, редакция