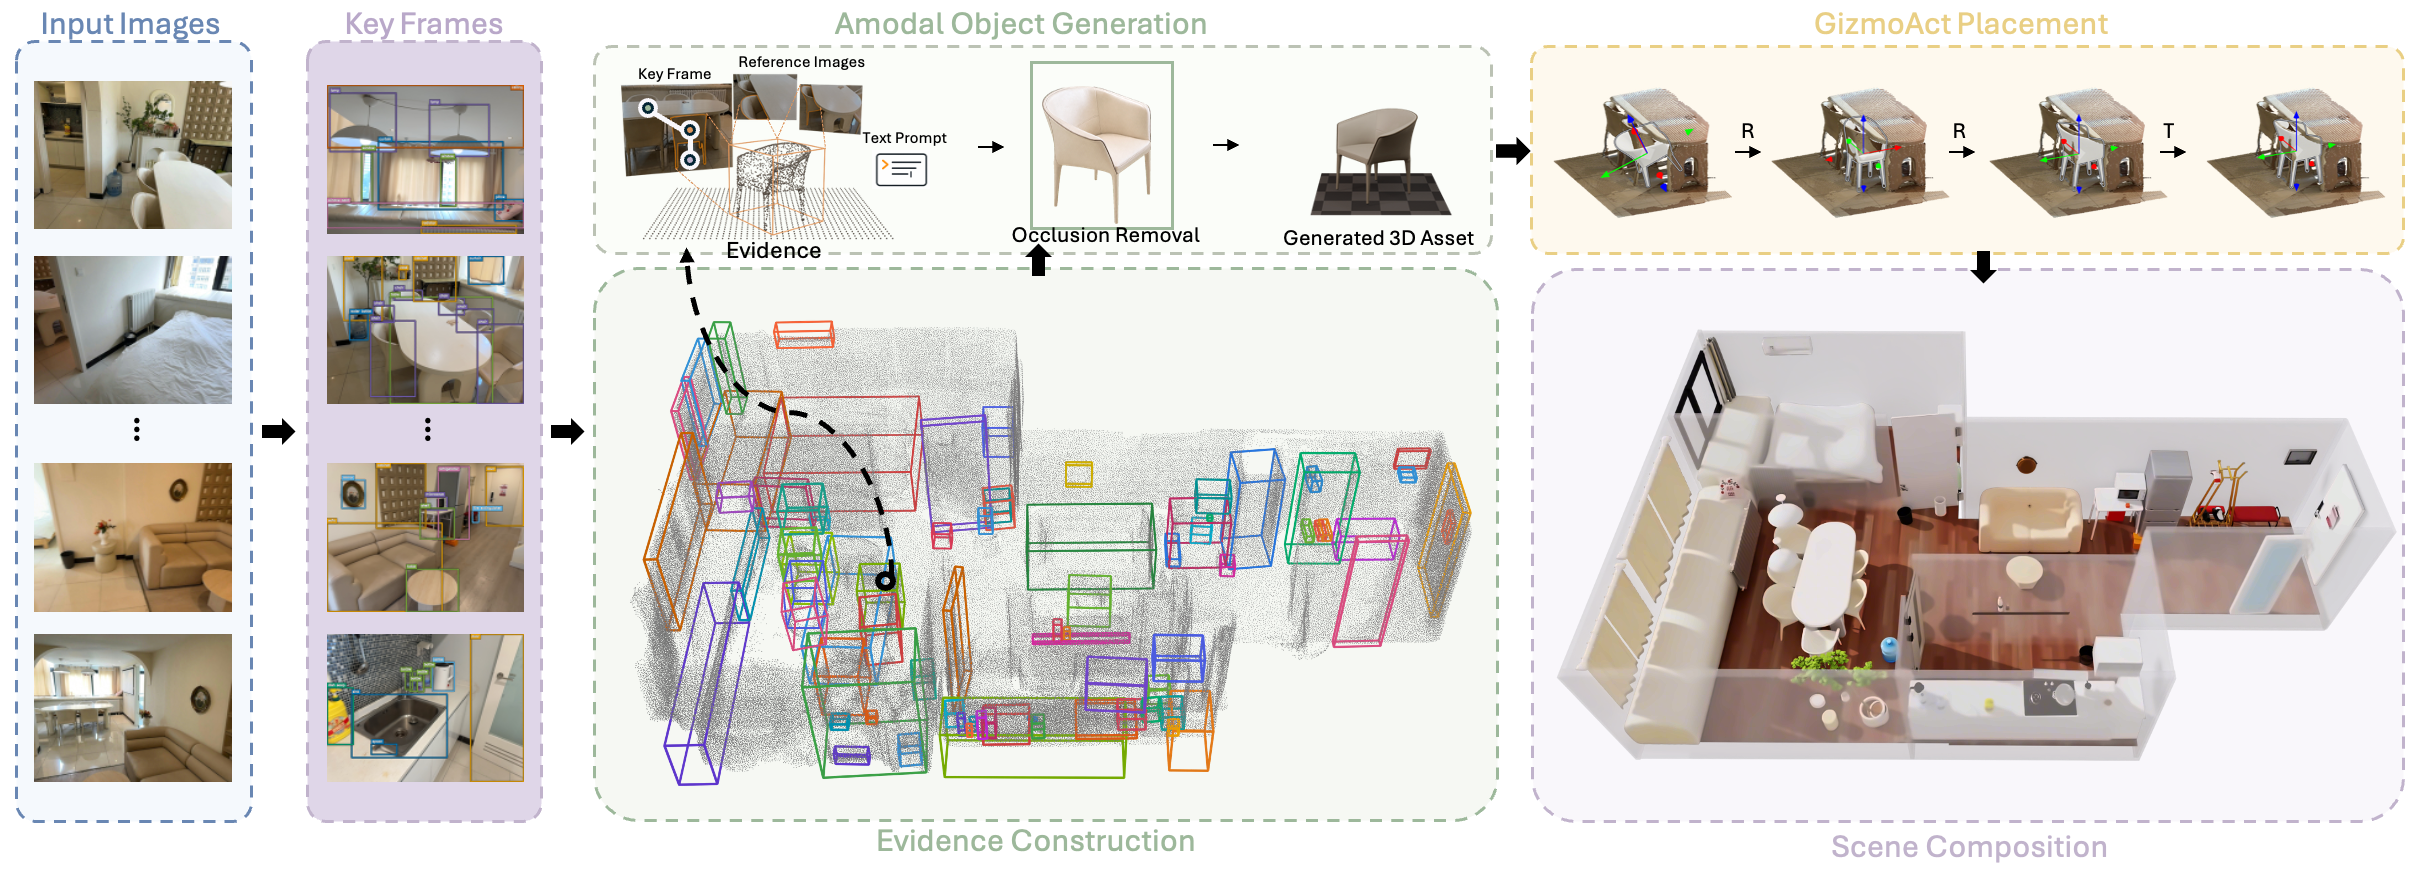
Команда ByteDance Seed совместно с исследователями Пекинского и Чжэцзянского университетов представила Lucida — исследовательскую систему, которая по видео или набору кадров восстанавливает реальное помещение как набор отдельных редактируемых 3D-объектов, а не единую статичную модель. Препринт arXiv:2608.30821 подан 31 августа 2026 года, по числам авторов система заметно обходит известные базлайны на бенчмарках R2S-Scene и CA-1M, а результат уже можно рассмотреть в браузерном демо на PlayCanvas.
Что произошло
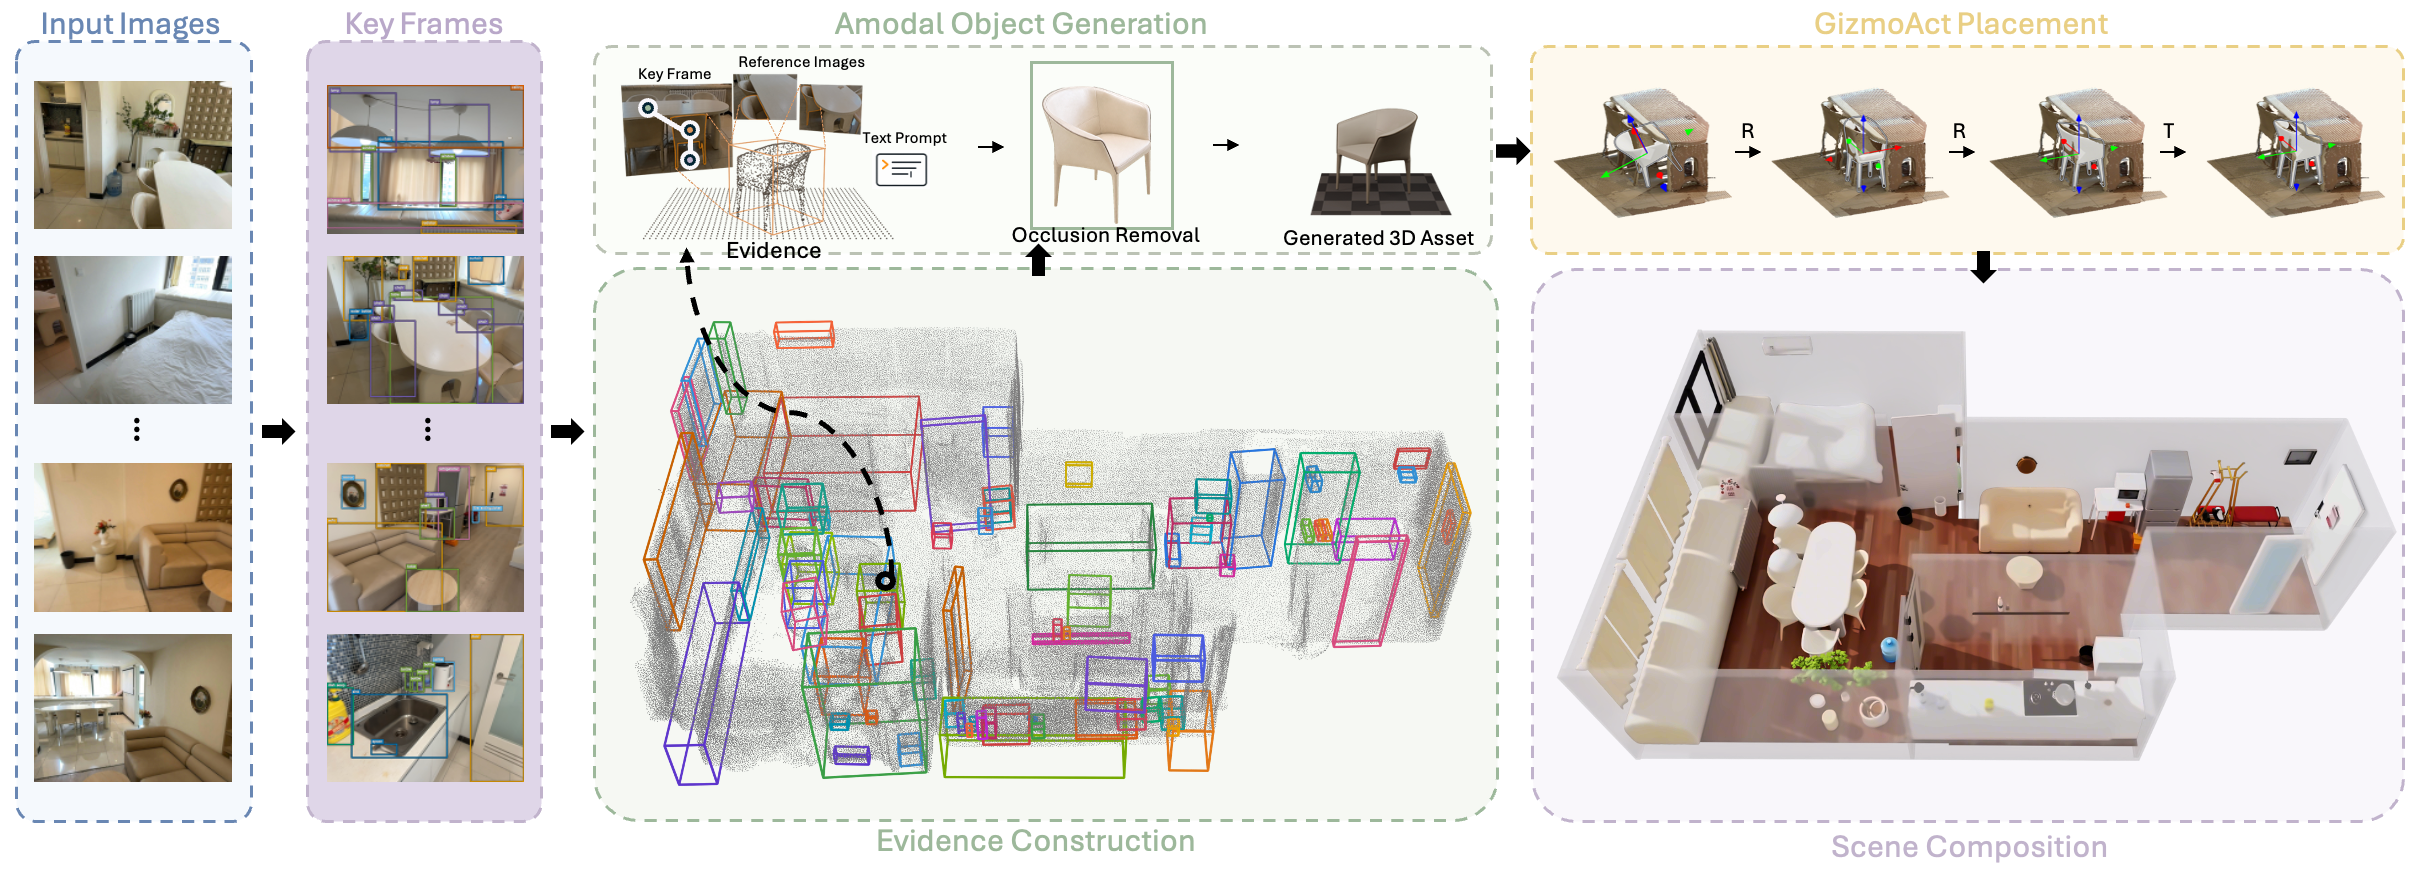
Исследовательская группа ByteDance Seed вместе с учёными Пекинского и Чжэцзянского университетов выложила препринт arXiv:2608.30821 с описанием системы Lucida, которая по видео или набору кадров помещения строит сцену из отдельных редактируемых 3D-объектов. Пайплайн состоит из трёх этапов. Parse строит сцену-граф по ключевым кадрам с масками, 3D-боксами, частичными облаками точек и текстовыми подсказками. Generate синтезирует полный объект, достраивая части, закрытые другими предметами. Place расставляет объекты через модуль GizmoAct: VLM в замкнутом цикле render → edit → re-render двигает объект в 3D-редакторе, пока он не совпадёт с исходными кадрами, и сама решает, когда остановиться. На тесте R2S-Scene Lucida подняла сценовый F-Score с 0,794 у SAM 3D до 0,924, а точность поз объектов ADD-SB@0,05 на CA-1M выросла с 57,8% у RecGen до 83,4% при использовании до 4 ракурсов. К препринту прилагаются официальная проектная страница и интерактивное демо на PlayCanvas с восстановленной из реальной съёмки квартирой.
Контекст
Lucida работает в области real-to-sim: переноса реального окружения в симуляцию, которая нужна робототехнике, digital twins и виртуальному продакшену. Типичная видеореконструкция выдаёт единую статичную модель комнаты, где мебель — часть запечённой геометрии, поэтому для симуляторов, которым требуются манипулируемые отдельные ассеты, такая форма малополезна. Композиционный подход меняет целевую форму результата: на выходе кресло, шкаф или лампа остаются самостоятельными объектами. Ключевая методическая заявка авторов состоит в том, что точность достигается в конце пайплайна, на этапе Place, а не требуется на входе: циклическая сверка с исходными кадрами объясняет заявленную устойчивость к зашумлённой реальной съёмке, и если это подтвердится на независимых данных, требования к качеству входного видео заметно снизятся. Методически самым весомым вкладом выглядит приём GizmoAct: размещение объекта трактуется не как прямая регрессия позы, а как многотурнное GUI-взаимодействие VLM с терминальным условием остановки, и такой шаблон переносим на другие задачи позиционирования и настройки параметров.
Почему это важно для индустрии
Для индустрии Lucida — сигнал, что real-to-sim перенос из обычного видео переходит от статичной реконструкции комнаты к сим-готовым отдельным объектам: выход пайплайна — отдельные mesh-ассеты, пригодные для робототехнических симуляторов и digital twins, где каждый предмет должен оставаться управляемым. Заявленные приросты над именованными базлайнами нетривиальны, хотя все метрики пока авторские. Приём GizmoAct ценен сам по себе: трактовка размещения объекта как многотурнного GUI-взаимодействия агента с условием остановки переиспользуема в других задачах позиционирования и настройки параметров, и на работу уже можно ссылаться в исследованиях по real-to-sim и агентному позиционированию. Для основателей и команд это означает, что производство редактируемых 3D-ассетов из видео становится активной гонкой, а 3D-платформы начнут добавлять сегментацию сцены и подобные функции. Инженерно, однако, это чистая демонстрация: открытого кода, API и данных по latency и стоимости нет, поэтому в продакшен систему сегодня брать нельзя.
Почему это важно для пользователей
Уже сейчас можно открыть интерактивное демо на PlayCanvas и покрутить восстановленную из реальной съёмки квартиру в 3D, вручную оценив качество реконструкции и то, насколько каждый предмет остался отдельным управляемым объектом. Препринт arXiv:2608.30821 открыт для чтения, и из него можно разобрать устройство пайплайна Parse → Generate → Place. Если авторы выложат код, из обычного видео комнаты можно будет получать редактируемую сцену для симуляции роботов, виртуального продакшена или подготовки локаций, где каждый предмет остаётся управляемым объектом, а не частью монолитной геометрии. Пока реализация не открыта, воспроизвести пайплайн на своих видео нельзя, и практическая польза ограничивается демо и изучением материалов.
Что пока неизвестно / ограничения
Все метрики — авторские замеры: независимых воспроизведений на R2S-Scene и CA-1M пока нет. Ключевая заявка о том, что точность достигается в конце пайплайна, а не требуется на входе, подтверждена пока только собственными экспериментами команды. Открытого кода и API не существует, данных по latency и стоимости не опубликовано, поэтому воспроизвести пайплайн и проверить устойчивость к зашумлённой съёмке вне авторских условий нельзя. Выкладка реализации ожидаема в течение нескольких месяцев после публикации, но не гарантирована; если код не выйдет, Lucida останется демонстрационной работой, а рассуждения о продакшен-применении преждевременны.
Источники
- Lucida: Composable Real-to-Sim Scene Modeling — официальная проектная страница ByteDance Seed
- Lucida: Parse, Generate, and Place for Composable Real-to-Sim Scene Modeling — препринт arXiv:2608.30821
- Lucida — интерактивное 3D-демо реконструкции квартиры на PlayCanvas
Автор
Look at AI, редакция