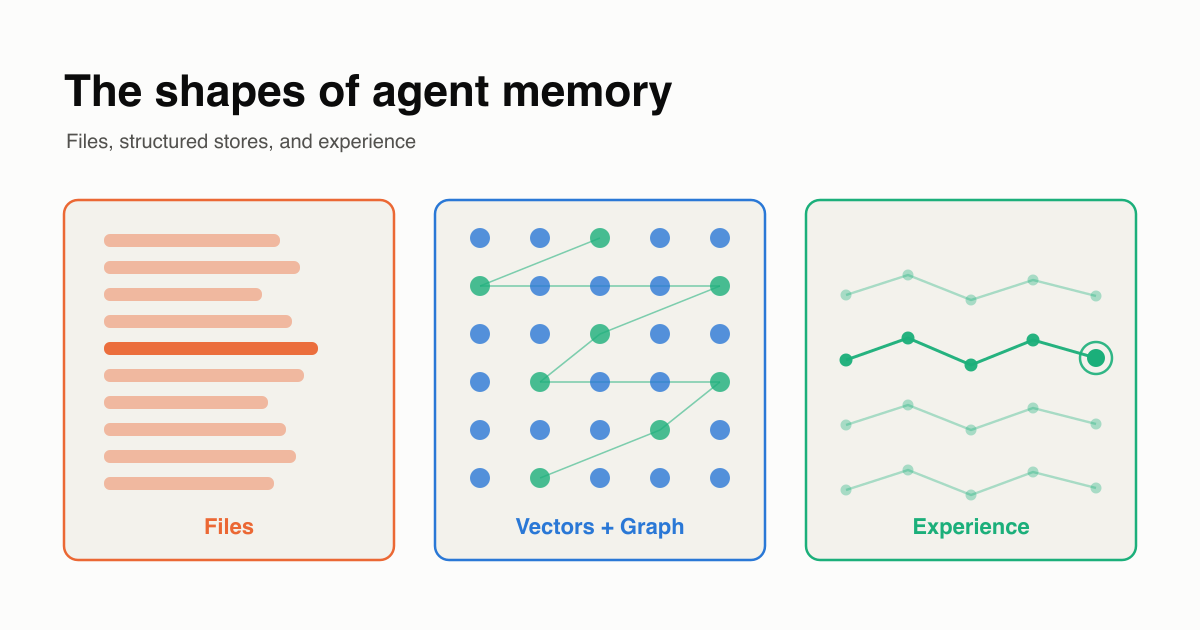
Инженер Пин Линь (pinglin.tw) опубликовал контролируемое сравнение трёх «форм» памяти ИИ-агентов: файлов, которые курует сама модель, структурированных сторов, автоматически добывающих атомарные факты, и «опыта», натренированного в веса модели через обучение с подкреплением. Одна и та же модель Qwen3.6-35B-A3B-mxfp4 и один агентный цикл отвечали на вопросы бенчмарков долгосрочной памяти диалогов, менялся только слой памяти: на held-out LongMemEval-S структурированный стор обошёл файлы на 28,7 пункта, потратив примерно в пятнадцать раз меньше чат-токенов, зато файлы честнее признают, что правильного ответа у них нет. Практическая ценность работы, впрочем, шире соревнования архитектур: разрозненные цифры вендоров памяти оказались несопоставимыми между собой, и автор предлагает проверяемую методику — построчные вердикты с автоматическим верификатором, которые каждый может пересчитать сам.
Что произошло
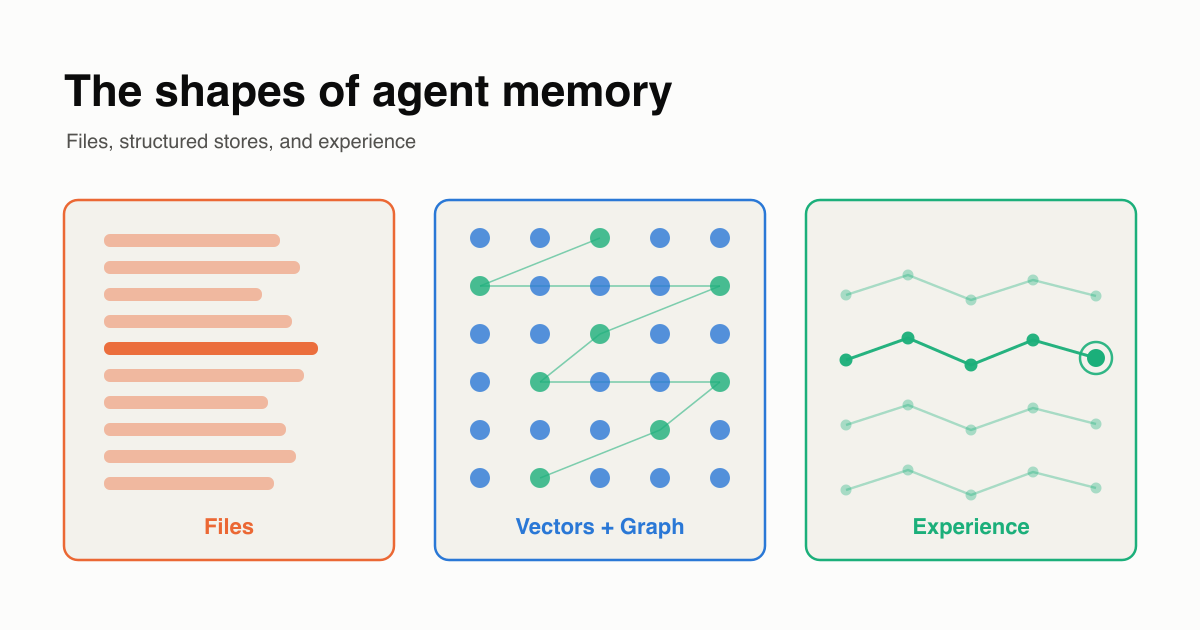
Пин Линь собрал эксперимент, в котором при фиксированной модели Qwen3.6-35B-A3B-mxfp4 и одном агентном цикле менялся только слой памяти, а ответы проверялись на двух бенчмарках долгосрочной памяти диалогов, LongMemEval и LoCoMo. Первая форма — файлы, которые модель ведёт и курует сама; этот подход используют Claude Code, Cline, Cursor и Windsurf, а наиболее развитой реализацией автор называет OpenClaw. Вторая — структурированный стор, который автоматически извлекает из диалогов атомарные факты; так работают mem0, Letta/MemGPT и Zep. Третья — «опыт», записанный в веса модели: система MemHarness обучает политику observe-retrieve-critique-reconstruct-act методом GRPO на 7B-модели. На held-out LongMemEval-S стор набрал 0,7361 против 0,4491 у файлов, при этом на один вопрос уходило 19,3 тысячи чат-токенов против 286,5 тысячи; на LoCoMo отрыв стора достигает 38 пунктов. Единственное измерение, где выиграли файлы, — распознавание вопросов без правильного ответа: 0,889 против 0,778 у стора. Все цифры и построчные вердикты выложены в репозитории a40-labs/memory вместе со скриптом, который пересчитывает каждый результат.
Контекст
Память агентов давно стала отдельным продуктом: вендоры продают её как слой, который стоит поставить поверх любой модели, и выбор до сих пор опирался на одиночные цифры из бенчмарков вроде LoCoMo. Исследование показывает, что эти цифры несопоставимы: один и тот же LoCoMo-результат Zep в разных материалах фигурировал как 84, 58,44 и 75,14 из-за разных методик подсчёта адверсариальной категории, а mem0 цитировали и как 67, и как 92,5. Скрытой переменной оказался и оценочный стек: замена связки «читатель+судья» с локальной 35B на gpt-4o-mini сдвигает результат на 6,9 пункта — больше, чем разрыв между любыми из сравниваемых сторов, поэтому числа из разных пайплайнов напрямую пересчитывать друг в друга нельзя. На этом фоне контролируемый протокол, где меняется только слой памяти, а каждая цифра сопровождается построчным вердиктом, — редкая для этой области попытка сделать измерение воспроизводимым.
Почему это важно для индустрии
Для команд, строящих агентов, главное следствие в том, что слой памяти теперь можно менять независимо от модели и агентного цикла и измерять его вклад, а не принимать на веру маркетинговые слоганы. Выбор «файлы против стора» превращается в измеренный компромисс между точностью, счётом за токены и честным отказом «не знаю». Второй сигнал ещё существеннее: на метрики сильнее влияет скрытая инфраструктура, чем сама архитектура, — хостед Zep Cloud обошёл открытый движок того же вендора Graphiti OSS примерно на 21 пункт при одном и том же судье, а скрытый инжест-пайплайн хостед-сервиса здесь подозреваемый номер один. Вывод про условия применимости задаёт границы инвестиций: на WebShop память дала +4,2 у слабой модели и ноль у frontier, то есть помогает лишь там, где у актора есть запас роста, — прямой аргумент для команд, решающих, стоит ли вообще вкладываться в память поверх сильной модели. Работа приносит и редкие честные отрицательные результаты, экономящие чужие бюджеты: собственный гибрид автора статистически неотличим от простого векторного индекса (+0,3 пункта), а консолидация-«сновидения» и ассоциативный граф в измеренной конфигурации дали нулевой эффект. Если эта практика закрепится, вендорам придётся публиковать построчные вердикты с верификатором и раскрывать инжест-пайплайны, а выбор memory-провайдера превратится в чек-лист «архитектура плюс инжест плюс судья».
Почему это важно для пользователей
Для тех, кто собирает агентов сам, из исследования выводится простой порядок действий. Файловая память — индекс MEMORY.md плюс grep по тематическим файлам — дёшева, не требует инфраструктуры и честно отвечает «не знаю», когда ответа в записях нет, но на длинных историях диалогов она проигрывает авто-добывающему стору и по точности, и по счёту за токены. Грубое правило: для дешёвого персонального агента берите файлы, для продукта с длинной историей пользователей и платным тарифом — структурированный стор. Отдельное предостережение касается энтузиастов, экспериментирующих с RL-натренированными моделями: грубое подключение банка эпизодов к такой модели ухудшило результат с 76,4 до 70,1 на raw replay, то есть положить опыт в контекст ещё не значит заставить модель им пользоваться. Все выводы проверяются без установки зависимостей: после git clone репозитория a40-labs/memory и запуска python3 scripts/verify_all.py каждая цифра пересчитывается заново, а рядом лежит toy-chatbot с файловой памятью, работающий с любым OpenAI-совместимым эндпоинтом.
Что пока неизвестно / ограничения
Доказательная база сравнения — одна базовая модель в квантованном формате mxfp4, два диалоговых бенчмарка (LongMemEval и LoCoMo) плюс WebShop, поэтому перенос величины отрыва стора и 15-кратной экономии токенов на другие модели, домены и режимы квантизации из этих данных не следует. Вывод «память помогает только там, где у актора есть запас роста» опирается пока на WebShop и ограниченный набор моделей — до проверки на frontier-системах это гипотеза. Объяснение разрыва между Zep Cloud и Graphiti OSS через скрытый инжест-пайплайн — интерпретация, а не измеренный факт, и воспринимать работу стоит не как рецепт «выбора за вечер», а как повод прогнать верификатор на собственных данных.
Источники
- The Shapes of Agent Memory – Files, Stores, and Experience
- GitHub — a40-labs/memory: per-question results and verification scripts for the controlled comparison of agent-memory architectures
Автор
Look at AI, редакция