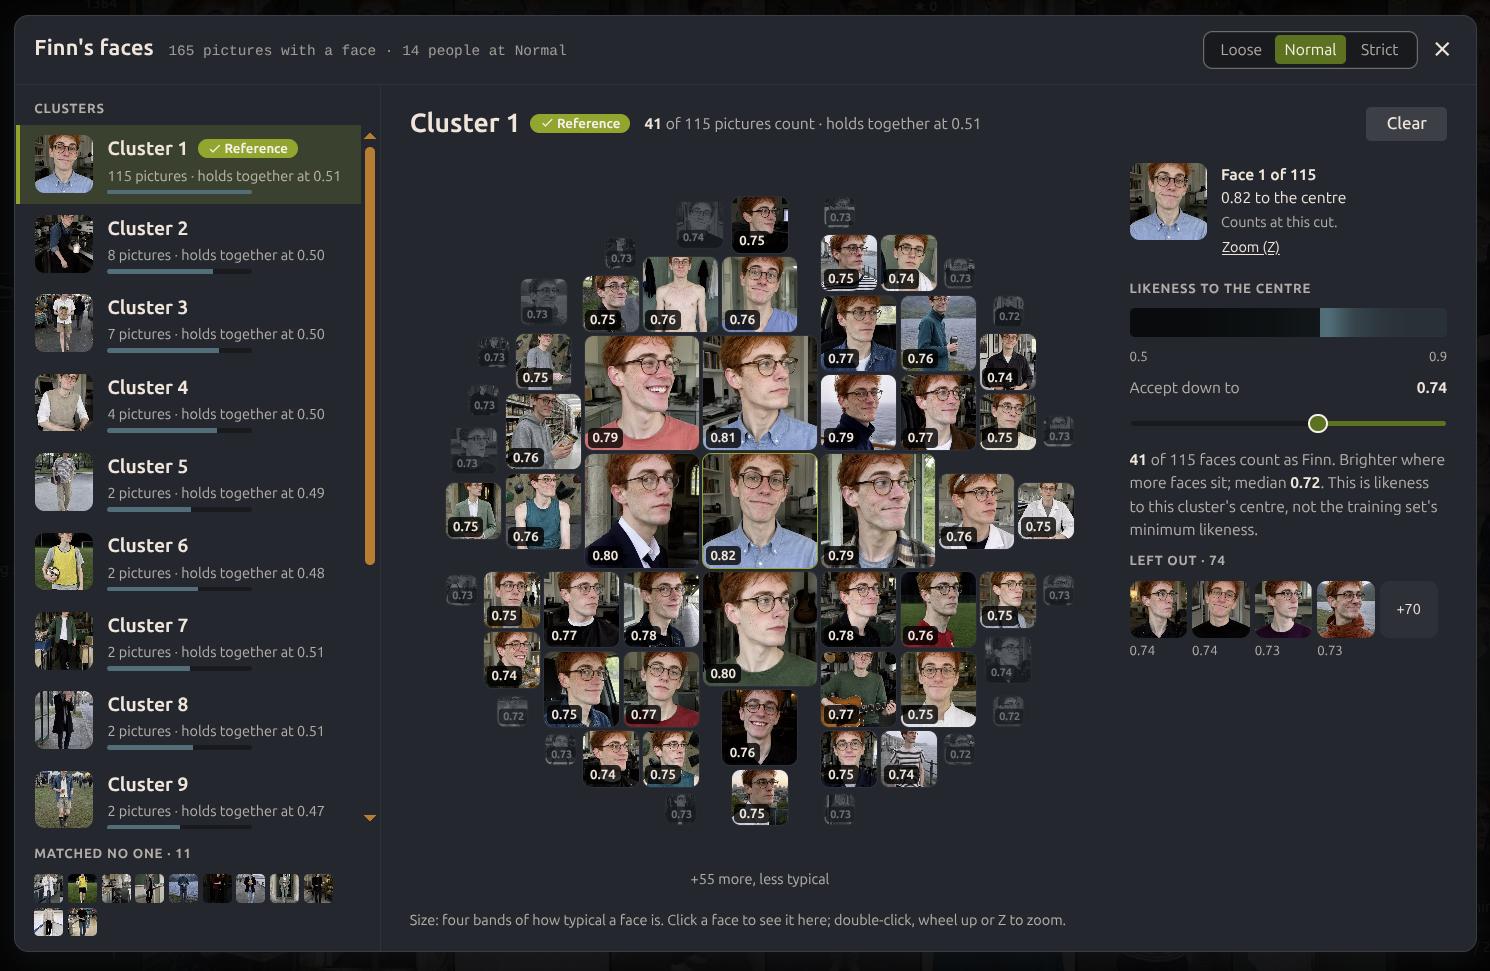
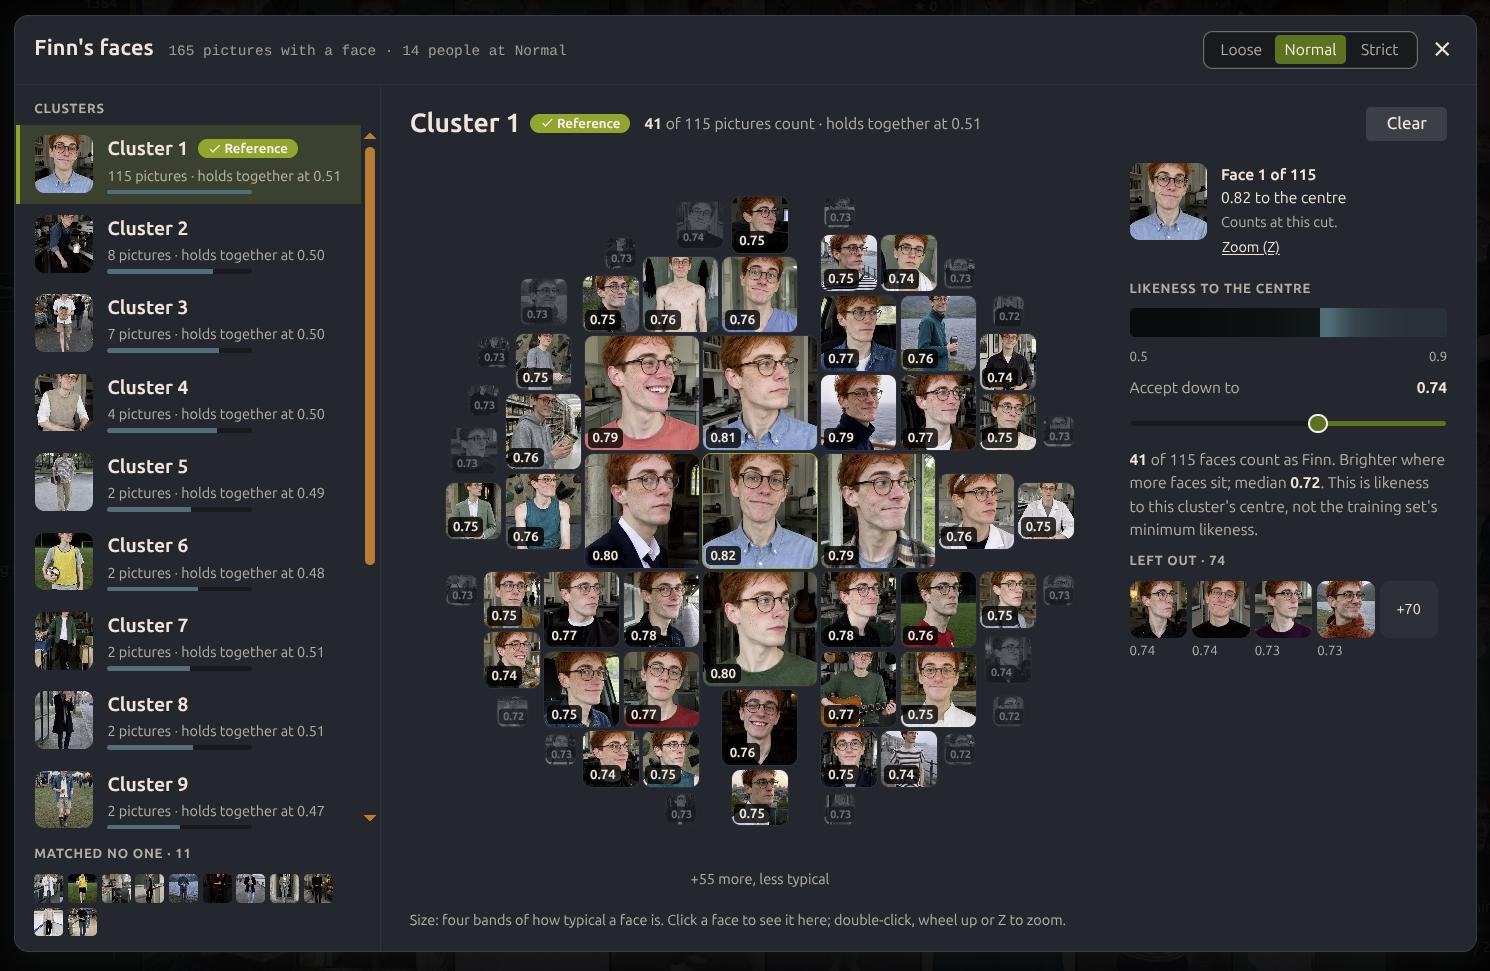
Открытое десктоп-приложение PixlStash обновилось до версии 2.0 и из менеджера изображений превратилось в законченный инструмент персонализации: оно само группирует лица по сходству, собирает из кластеров обучающие датасеты и запускает обучение LoRA на локальной видеокарте через AI-toolkit. Готовая модель автоматически прикрепляется к персонажу и становится доступной в ComfyUI через кастомные ноды. Основной релиз v2.0.0 вышел 10 ноября 2026 года, багфикс-версия v2.0.1 — 16 ноября. Приложение бесплатное, распространяется с открытым кодом и работает на Windows и Linux; сборка для macOS заявлена, но пока не готова.
Что произошло
Основной релиз PixlStash 2.0 (v2.0.0) состоялся 10 ноября 2026 года, а 16 ноября за ним последовал корректирующий релиз v2.0.1. Новая версия встраивает в приложение весь пайплайн персонализации. Фотографии в библиотеке автоматически группируются по сходству лиц — функция face likeness clusters — и эти кластеры служат готовой основой обучающих датасетов для персонажей. Обучение запускается прямо из приложения: встроенный модуль использует AI-toolkit и работает на локальном GPU. После завершения обучения полученная LoRA автоматически прикрепляется к соответствующему персонажу в библиотеке и появляется в ComfyUI через кастомные ноды, поэтому ручного переноса файлов не требуется. В релизе также заявлены готовые схемы, включая Krea 2, MOSS-Image, Flux.2 Klein 9B и Qwen Image Edit 2.1. Приложение работает и как обычный десктоп, и как headless-сервер с веб-интерфейсом.
Контекст
Раньше локальный пайплайн персонализации собирался вручную: кадры для датасета приходилось отбирать по папкам, окружение для обучения настраивать отдельно, а обученную LoRA копировать в воркфлоу ComfyUI. PixlStash 2.0 не предлагает нового метода обучения — его новизна в инженерной сборке уже существующих компонентов в один инструмент. Ключевой ход в том, что формирование обучающих данных становится побочным продуктом обычного ведения библиотеки: фото накапливаются, лица группируются автоматически, и подготовка датасета для персонажа перестаёт быть отдельным этапом. Это часть более широкого тренда на консолидацию пайплайнов персонализации, где библиотека, обучение и инференс перестают быть набором разрозненных утилит, а персонаж начинает существовать в приложении как сущность с привязанной моделью.
Почему это важно для индустрии
Для команд и разработчиков на локальном AI-стеке релиз означает комодитизацию персонализации: связка «собрать датасет — натренировать — встроить в воркфлоу» теперь доступна в бесплатном open-source инструменте, и порог входа падает с уровня инженерного проекта до настройки в течение вечера. Это снижает ценность ручного кураторства данных как отдельной платной работы и задаёт новый ориентир для менеджеров творческих ассетов: связки «библиотека плюс обучение плюс инференс» могут стать ожидаемым стандартом, а конкурирующие приложения начнут добавлять аналогичные интеграции и расширения. Для исследователей новых методов здесь нет, но появляется удобная площадка и источник данных для экспериментов над автоматическим кураторством обучающих наборов. Сдерживающий фактор риска — что проект фактически держится на одном активном мейнтейнере, а быстрые изменения в ComfyUI и AI-toolkit требуют постоянной поддержки совместимости.
Почему это важно для пользователей
Практический выигрыш получают те, кто тренирует LoRA на собственных фотографиях или персонажах. Подбор обучающих данных сводится к просмотру и подтверждению автоматических кластеров лиц вместо перебора папок, обучение идёт на собственной видеокарте без отдельной настройки окружения, а результат сразу подхватывается в ComfyUI без ручного копирования файлов. Работать можно на Windows или Linux, включая вариант headless-сервера с веб-интерфейсом, что удобно, если GPU стоит на отдельной машине. Платить за сам инструмент не нужно, но требования по железу остаются: нужна собственная видеокарта, а ComfyUI и AI-toolkit выступают зависимостями, и все вычисления лягут на вашу технику.
Что пока неизвестно / ограничения
Алгоритм кластеризации лиц не раскрыт: нет метрик точности и разбора граничных случаев вроде визуально похожих лиц разных людей или одного человека при разном освещении, возрасте и ракурсах. Бенчмарков качества LoRA, обученных на автосгенерированных датасетах, против традиционно курируемых тоже нет — тезис о более устойчивой модели остаётся правдоподобным, но непроверенным предположением. Формулировка «почти бесплатно» описывает стоимость формирования кластеров как побочного продукта ведения библиотеки, а не качество полученных датасетов. Сборка для macOS пока не выпущена, несмотря на заявленную поддержку платформы. Наконец, рекомендация автора называть Qwen Image Edit 2.1 лучшей моделью — субъективная оценка без протокола сравнения, хотя готовые схемы под несколько базовых моделей дают материал для такого теста.
Источники
Автор
Look at AI, редакция