Alibaba 16 ноября 2026 года выпустила Qwen4-Max — первый флагман на новой архитектуре Qwen4. Модель опирается на MoE-бэкбон с 2,4 трлн параметров, принимает текст, изображения и видео и работает с контекстом до 1 миллиона токенов. По данным Qwen, средняя стоимость задачи на внутреннем бенчмарке Work360 снизилась на 62% при одновременном росте качества, а сама модель уже доступна через QwenCloud API, Qwen Studio, QwenWork и Qoder.
Что произошло
Alibaba представила Qwen4-Max, первый флагман на архитектуре Qwen4. Основа модели — MoE-бэкбон на 2,4 трлн параметров, из которых на каждый токен активируются 71 млрд; дополнительно в архитектуре задействованы 328 млрд параметров N-gram Embedding. Контекстное окно составляет 1 миллион токенов, на вход принимаются текст, изображения и видео. В блоке внимания появились три новых компонента: Gated DeltaNet (GDN), Qwen Sparse Attention (QSA) и Gated Residual (GR). Для демонстрации прогресса Qwen использует внутренний бенчмарк Work360, покрывающий 26 доменов и 721 направление: там Qwen4-Max набрала 52,69 балла против 47,74 у Qwen3.8-Max. По тем же вендорским данным, средняя стоимость задачи упала с $4,43 до $1,67, то есть на 62%, а расход токенов сократился примерно на 24–35% на Work360 и на 48–49% на Terminal-Bench 4.0. API-цены установлены на уровне $1,50 за миллион входных токенов, $4,50 за миллион выходных и $0,075 за миллион токенов кеш-чтения. Модель уже доступна через QwenCloud, Qwen Studio, QwenWork и Qoder; веса самой Qwen4-Max закрыты, однако Alibaba обещает позже открыть меньшие модели линейки Qwen4.
Контекст
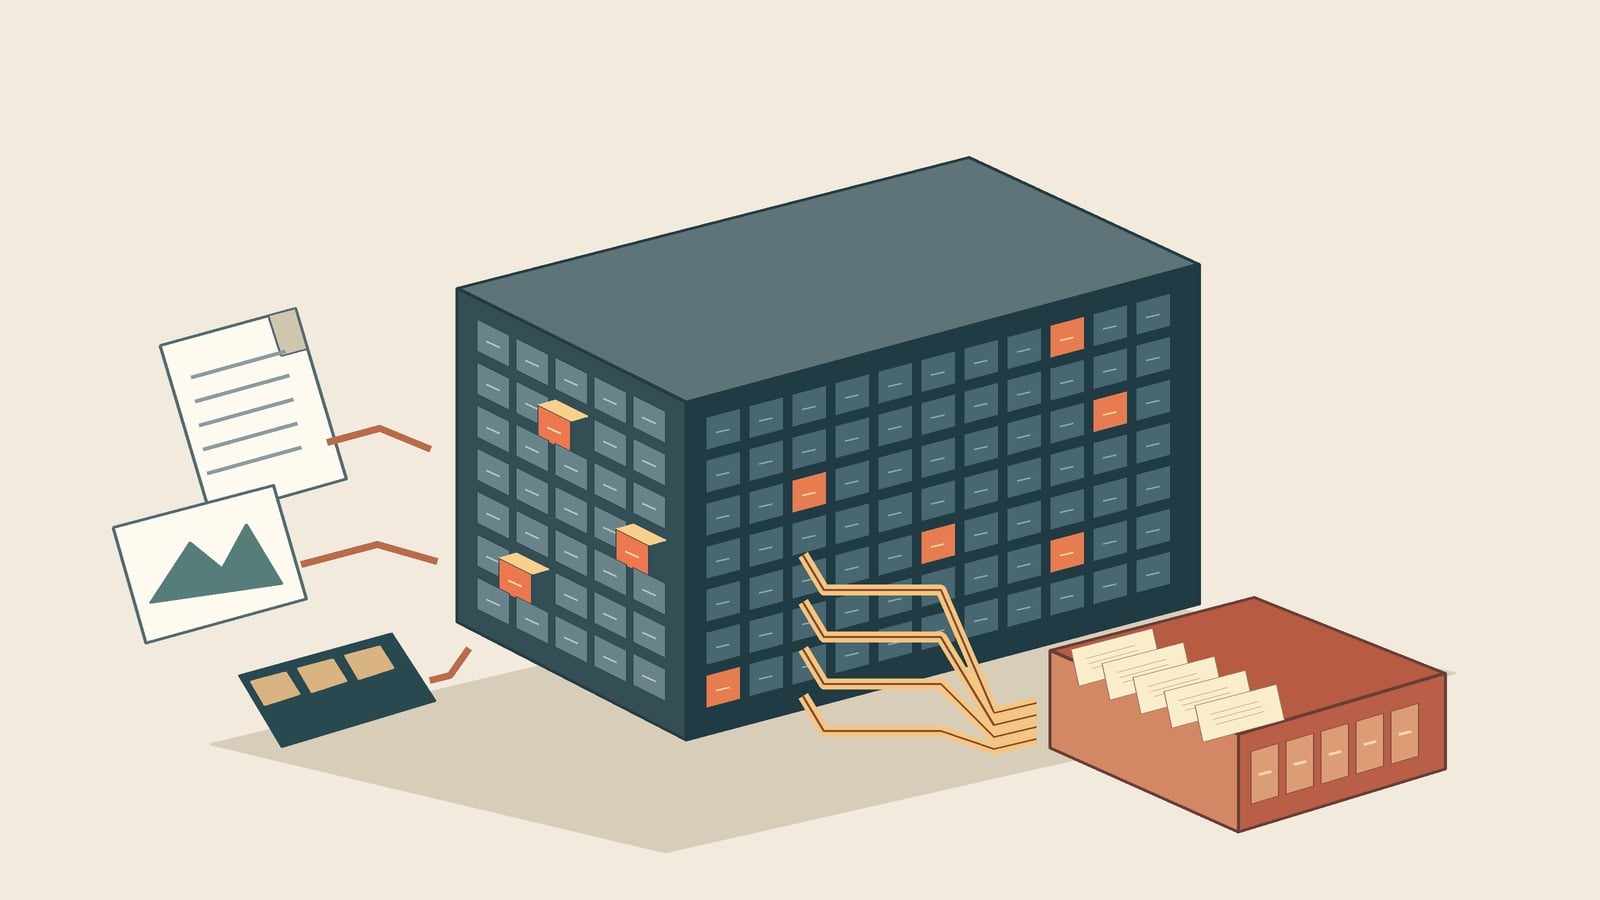
Релиз удобно читать через два рыночных тренда, которые он обслуживает. Первый — экономика архитектур Mixture-of-Experts: общее число параметров наращивается ради качества, но платится только за активную часть, поэтому счёт за инференс определяется 71 млрд работающих на токен параметров, а не полными 2,4 трлн. Второй — высокая стоимость длинного контекста при классическом внимании: именно на неё направлены новые компоненты Gated DeltaNet, Qwen Sparse Attention и Gated Residual, которые, по описанию Qwen, удешевляют работу с большими контекстными окнами. На этом фоне меняется и сама рамка сравнения моделей: вместо цены за токен вендор продвигает стоимость за задачу, потому что в многошаговых агентных сценариях итоговый счёт зависит от расхода токенов и числа попыток, а не только от тарифа. Схема «закрытый флагман сейчас, открытые меньшие модели позже» выглядит осознанной продуктовой стратегией: Max сразу монетизируется через API, а открытые веса становятся инструментом расширения экосистемы.
Почему это важно для индустрии
Главный сигнал для отрасли — новая экономика за задачу, а не паспортные параметры. Если заявленное падение средней стоимости задачи с $4,43 до $1,67 подтвердится, многошаговые агентные сценарии — программирование, анализ документов, промышленные workflow — станут рентабельными для заметно более широкого круга компаний, включая тех, у кого месяц назад такие пайплайны не сходились по юнит-экономике. Цены $1,50 за миллион входных и $4,50 за миллион выходных токенов при кеш-чтении $0,075 усиливают ценовое давление на конкурентов в сегменте флагманских моделей: им придётся отвечать либо сопоставимым снижением стоимости задачи, либо ценой. Если сокращение расхода токенов подтвердится независимыми замерами, связка MoE, разреженного внимания и N-gram Embedding может стать шаблоном для флагманов с длинным контекстом, а «стоимость за задачу» — основной метрикой бюджетирования вместо «цены за токен». Обещание открыть меньшие модели Qwen4 создаёт для билдеров путь «прототип на Max — продакшн на открытых весах» с on-prem-вариантами и приватными данными и одновременно первую возможность независимой проверки архитектуры вне маркетинга вендора.
Почему это важно для пользователей
Модель уже доступна, поэтому проверка не требует ожидания: Qwen4-Max работает в QwenCloud API, Qwen Studio, QwenWork и Qoder. Практичный первый шаг — прогнать 20–50 реальных задач своего продукта параллельно на Qwen4-Max и Qwen3.8-Max и посчитать фактическую стоимость и расход токенов за задачу, а не абстрактный тариф: именно так проверяется главный релизный тезис об удешевлении. Начать пересчёт стоит со сценариев, где длинный контекст был главным блокером экономики — обработка больших документов и многошаговые агентные цепочки; отдельно имеет смысл замерить эффект кеш-чтения по $0,075 за миллион токенов. Тем, кому закрытые веса не подходят, стоит следить за анонсом открытых меньших моделей Qwen4, которые Alibaba обещает выпустить позже.
Что пока неизвестно / ограничения
Ключевые цифры релиза — вендорские самоотчёты. Work360 — внутренняя разработка Qwen: сравнение проведено только с собственной Qwen3.8-Max, а внешний контроль, публичный набор задач и защита от контаминации данных в источниках не описаны, поэтому независимая воспроизводимость пока нулевая. Заявление о снижении стоимости задачи на 62% — составная метрика: она смешивает снижение API-цен, сокращение расхода токенов и изменение качества, а декомпозиция этих факторов не опубликована. Абляций GDN, QSA и GR в материалах нет, поэтому вклад каждой компоненты внимания невозможно отделить от прочих изменений — данных и пост-тренинга. Для продакшен-решений не хватает операционных данных: в источниках нет latency (TTFT и скорости генерации), информации о rate limits, SLA и доступных регионах — всё это придётся выяснять самостоятельно при тестировании.
Источники
- Qwen4-Max: Your New Teammate Has Arrived (Qwen Team Blog)
- Alibaba Releases Qwen4-Max: 2.4 Trillion Parameters, Per-Task Cost Slashed by 60% — BigGo Finance
- Qwen4-Max benchmarks, pricing and specs: How it compares — kingy.ai
Автор
Look at AI, редакция