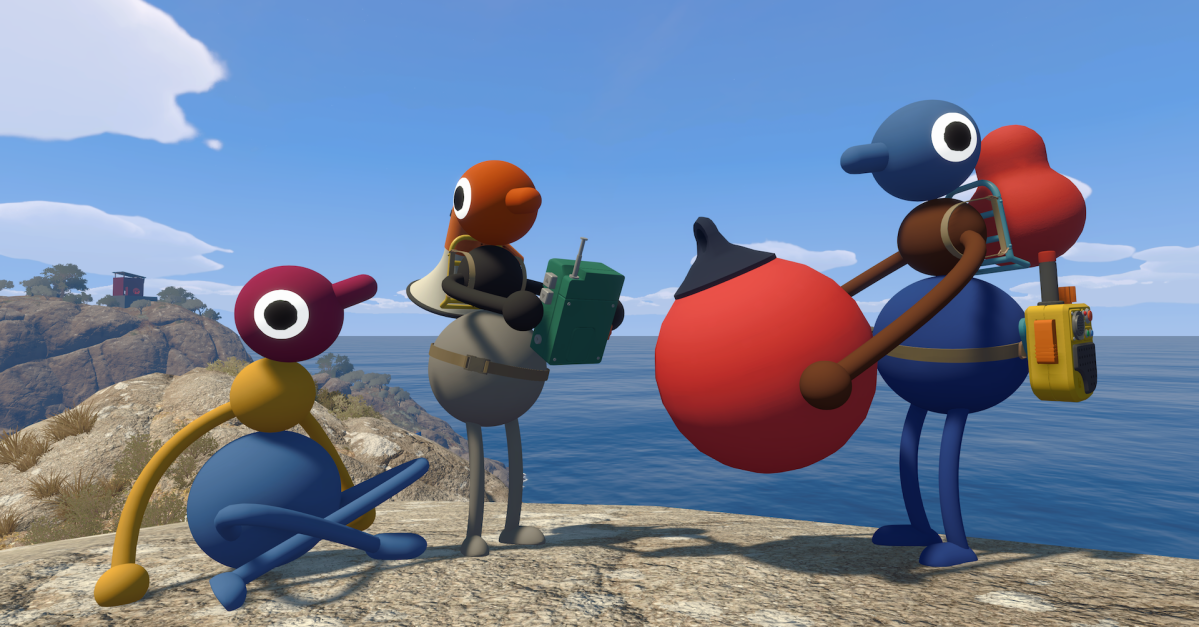
Часть жюри Independent Games Festival (IGF) опубликовала заявление, что не будет голосовать за игры, использующие генеративный ИИ «в какой-либо форме». Поводом стал кооперативный приключенческий проект Big Walk студии House House, известной по Untitled Goose Game: разработчики раскрыли, что на финальном этапе разработки минимально использовали LLM для отладки технических багов. Случай показал, что в инди-сегменте нет единого понимания допустимой границы применения ИИ — спор разгорелся вокруг сугубо инструментального использования, не затронувшего контент игры.

Что произошло
Разработчики Big Walk при подаче игры на Independent Games Festival раскрыли, что на финальном этапе разработки «sparingly», то есть минимально, использовали LLM для отладки технических багов. По собственной оценке House House, доля кода, связанного с этим, «значительно меньше 0,1%» кодовой базы, при этом ИИ не применялся для графики, нарратива или других творческих задач. В ответ группа членов жюри фестиваля выпустила заявление об отказе голосовать за игры с генеративным ИИ; среди подписавших его — автор Telling Lies и Immortality Сэм Барлоу и композитор Celeste Лена Рейн. Дискуссия расколола инди-сообщество, а сам проект стал тестовым случаем того, насколько строго сообщество готово судить любые упоминания ИИ в конкурсной разработке.
Контекст
За конфликтом стоит разрыв в правилах раскрытия. IGF требует от разработчиков декларировать использование ИИ при подаче заявки, тогда как Steam не запрашивает раскрытия применения ИИ в коде или чат-ботах, поэтому один и тот же проект раскрывается перед разными площадками по-разному. При этом применение LLM для отладки на этапе разработки давно нормализовано в инженерной практике: это инструмент дев-процесса, который не попадает в финальный билд и не создаёт релизу новых точек отказа или стоимости инференса. Сложнее то, что критерий «в какой-либо форме» технически не операционализирован: компиляторы, статические анализаторы, LLM-ассистенты в IDE и генеративный ИИ для создания контента образуют один континуум, и без порогов по назначению и по мере использования жюри оценивает декларацию разработчика, а не измеримый артефакт. Big Walk оказался пограничным кейсом, который поставил под сомнение бинарные категории вроде «AI-free».
Почему это важно для индустрии
Для индустрии эффект сугубо процессный: кейс не принёс новых моделей, бенчмарков или методов, однако студии уже пересматривают формулировки раскрытия, а фестивали — определения «генеративного ИИ». Практический вывод для команд: фиксировать, где и как использовался LLM, начиная с промптов, диффов и ревью, нужно с самого начала разработки, потому что задним числом такой отчёт собрать невозможно. Одновременно раскрытие использования ИИ превращается из формальной этикетки в фактор дистрибуции и репутации: теперь инструментальное применение меньше десятой доли процента кодовой базы способно повлиять на конкурсную судьбу проекта. Вероятное, хотя и пока не свершившееся, следствие — эволюция правил наградных программ от бинарных запретов к категориям использования и градуированным декларациям, а также растущий спрос на инструменты, которые логируют LLM-вызовы в дев-процессе и генерируют машиночитаемые отчёты о применении ИИ.
Почему это важно для пользователей
Для читателей, выбирающих игры, практический вывод: статус «AI-free» сегодня — это самоотчёт разработчика, а не проверяемая характеристика, независимого аудита ИИ-вклада в код не существует, поэтому опираться приходится на заявления студий и подписи членов жюри. Кейс также показывает, как работает профессиональное давление в этой среде: даже прозрачное и минимальное использование LLM обернулось публичным спором, а часть подписантов заявления, по сообщениям The Verge, опасалась «профессиональных последствий» из-за своей подписи. Для инди-энтузиастов произошедшее — ориентир: допустимость генеративного ИИ в фестивальных программах сейчас активно пересматривается, и наблюдать стоит не только за контентом игр, но и за тем, как студии декларируют процесс разработки.
Что пока неизвестно / ограничения
Оценка «значительно меньше 0,1%» — самоотчёт без аудируемой методологии: не уточнено, что именно измерялось, строки, коммиты или диффы, поэтому подтвердить или опровергнуть цифру воспроизводимым способом не может ни одна из сторон спора. Логирование LLM-вызовов решило бы проблему раскрытия, но не проблему измерения: лог обращений к API не эквивалентен происхождению кода из-за автодополнения и prompt-to-diff-инструментов. Также неизвестно, сколько членов жюри подписало заявление и как на него официально отреагирует оргкомитет IGF, а ожидания, что наградные программы перейдут к категориям использования и градуированным декларациям, остаются интерпретациями, а не установленными фактами.
Источники
Автор
Look at AI, редакция