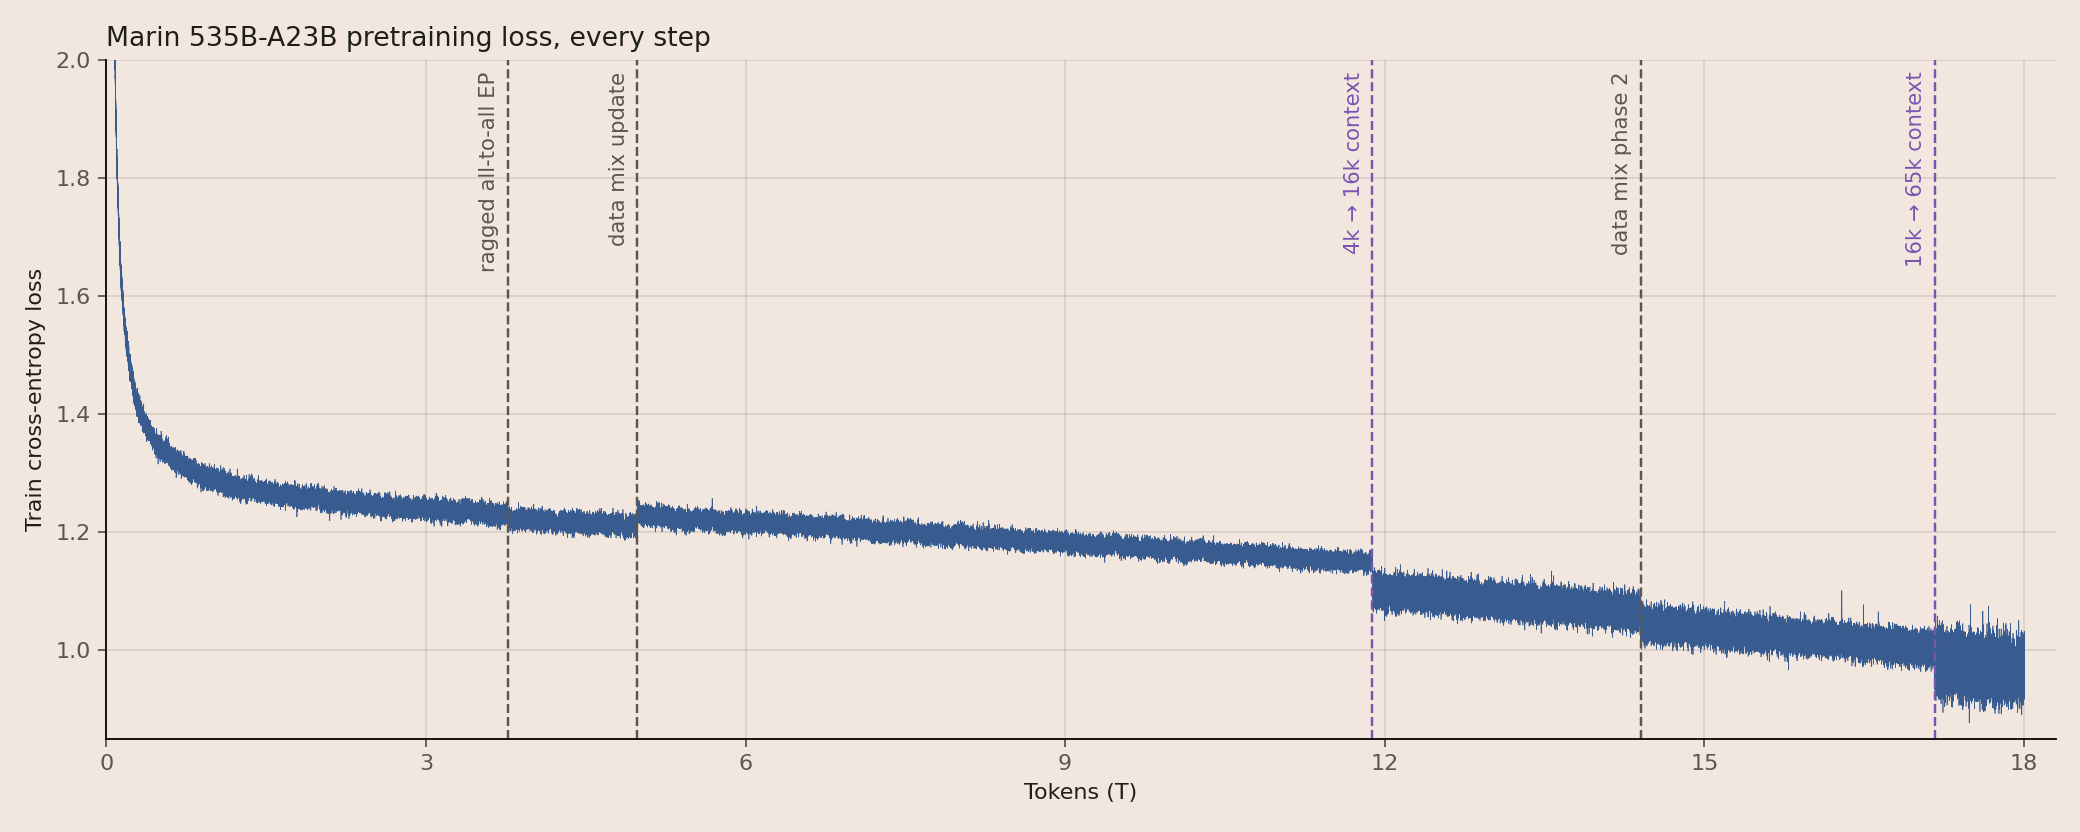
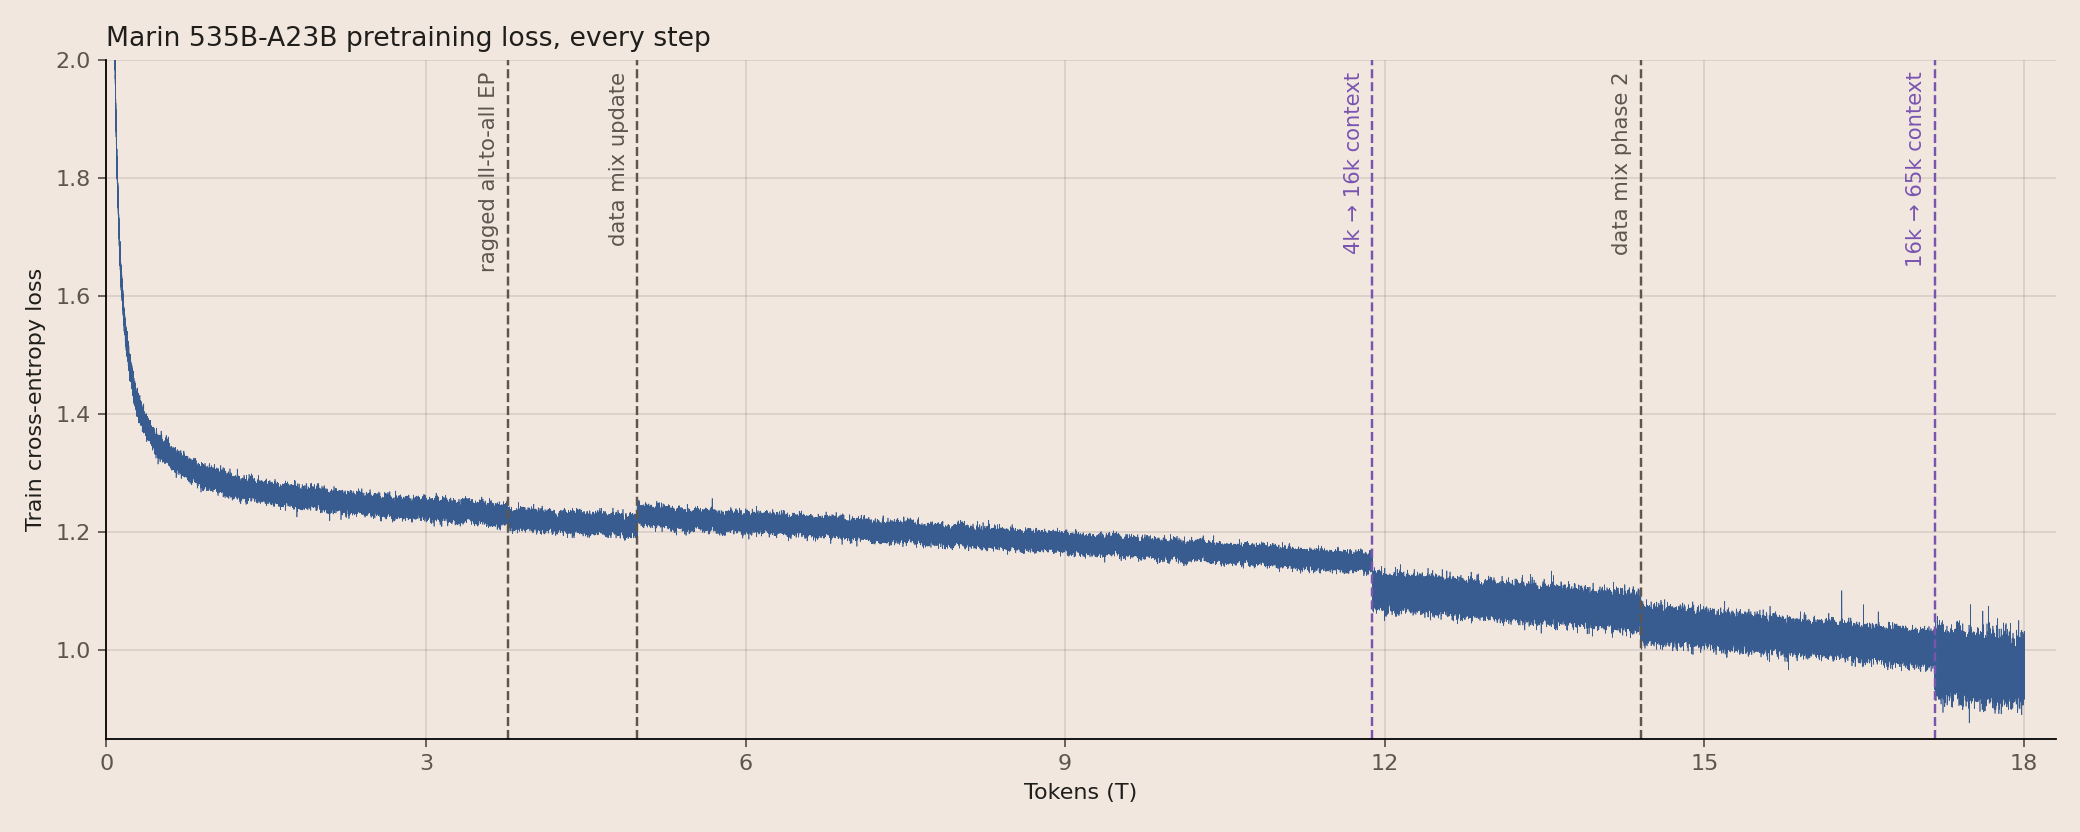
Open Athena, совместный проект со Stanford, опубликовала подробный разбор архитектуры Marin 535B-A23B — MoE-модели на 535 млрд параметров, из которых в каждом шаге активны 23 млрд. 5 ноября 2026 года модель завершила претрейнинг на 18 трлн токенов, который шёл на 768 GPU GB200. Финальный Paloma macro-loss составил 1.982 против заранее зарегистрированного прогноза 2.039, и за весь ран не случилось ни одного loss spike. В публикации раскрыты ключевые архитектурные решения и инженерные приёмы, применённые на протяжении обучения.
Что произошло
Разбор в блоге Open Athena описывает модель до уровня конкретных инженерных решений. Основу составляет Latent MoE: 384 латентных эксперта, из которых активируются 8, плюс 2 shared-эксперта, при сжатии представлений в 2 раза. Expert Parallelism переведён на схему ragged all-to-all, и drop-рейт снизился с 5.5–7.1% до примерно 0.01–0.14%. Оптимизатор собственный — Hyperball, где MuonH отвечает за матрицы, а AdamH за lm_head. Среди прочих компонентов Exclusive Self Attention (XSA), Short Convolutions (SConv) с kernel 4, QK RMSNorm с фиксированным множителем 1.3 и top-k quantile balancing по сырым логитам для стабилизации роутера. Контекст в ходе обучения расширялся поэтапно с 4k до 16k и затем до 65k токенов.
Контекст
Прогноз финального loss был записан ещё до старта ранта — практика, заимствованная из науки, где гипотеза фиксируется заранее, чтобы результат нельзя было подогнать задним числом. Open Athena перенесла этот подход на скейлинг моделей и вела обучение открыто: рант сопровождался публичной отчётностью и трансляциями в прямом эфире, а эксперименты, данные и инфраструктура Marin публикуются. Разбор подчёркивает, что архитектура проектировалась с ориентацией на MFU, то есть на полезную загрузку вычислителей, — отсюда внимание к вычислительной эффективности каждого решения.
Почему это важно для индустрии
Для индустрии это редкий публичный playbook полного цикла крупного MoE-претрейна: цифры, графики и решения разложены так, что приёмы можно переносить в собственные тренировочные пайплайны и планирование рантов сразу, а не ждать анонса продукта. Связка Expert Parallelism и Latent MoE по оценке авторов даёт около 1.3x выигрыша в вычислительной эффективности, а измеримые метрики вроде drop-рейтов позволяют сторонним командам проверять приёмы у себя на меньших масштабах. Отдельный сигнал — сама постановка: претрейн масштаба, близкого к frontier, показан как предсказуемая инженерная задача. При этом рычаг события информационный, а не рыночный: публикация посвящена претрейну и не содержит serving-данных, поэтому на inference и продуктовые решения она сегодня не влияет.
Почему это важно для пользователей
Для читателя это возможность заглянуть в процессы, которые обычно остаются внутри frontier-лабораторий: публикация показывает не только финальный результат, но и то, как инженерные решения принимались по ходу обучения. Все цифры и графики — кривая loss за весь ран, drop-рейты, scaling ladder — разложены в официальном блоге Open Athena, поэтому материал можно использовать как учебный курс по устройству современного претрейна. Тем, кто изучает обучение моделей, он даст понимание, какие компромиссы стоят за каждым архитектурным выбором.
Что пока неизвестно / ограничения
Выводы упираются в несколько ограничений. Попадание прогноза доказывает предсказуемость именно этого ранта, а не статистическую надёжность паттерна: это один самопубликуемый ран, и нужны независимые репликации хотя бы на меньших масштабах. Paloma macro-loss — обучающий прокси, downstream-бенчмарков в источниках нет, поэтому суждения о качестве готовой модели преждевременны. Несколько новых компонентов внедрены одновременно без аблаций в подаче, так что атрибуция заявленного прироста вычислительной эффективности конкретным решениям по одному разбору невозможна. Наконец, сопоставления с чужими рантами того же масштаба и бюджета в источниках тоже нет.
Источники
Автор
Look at AI, редакция