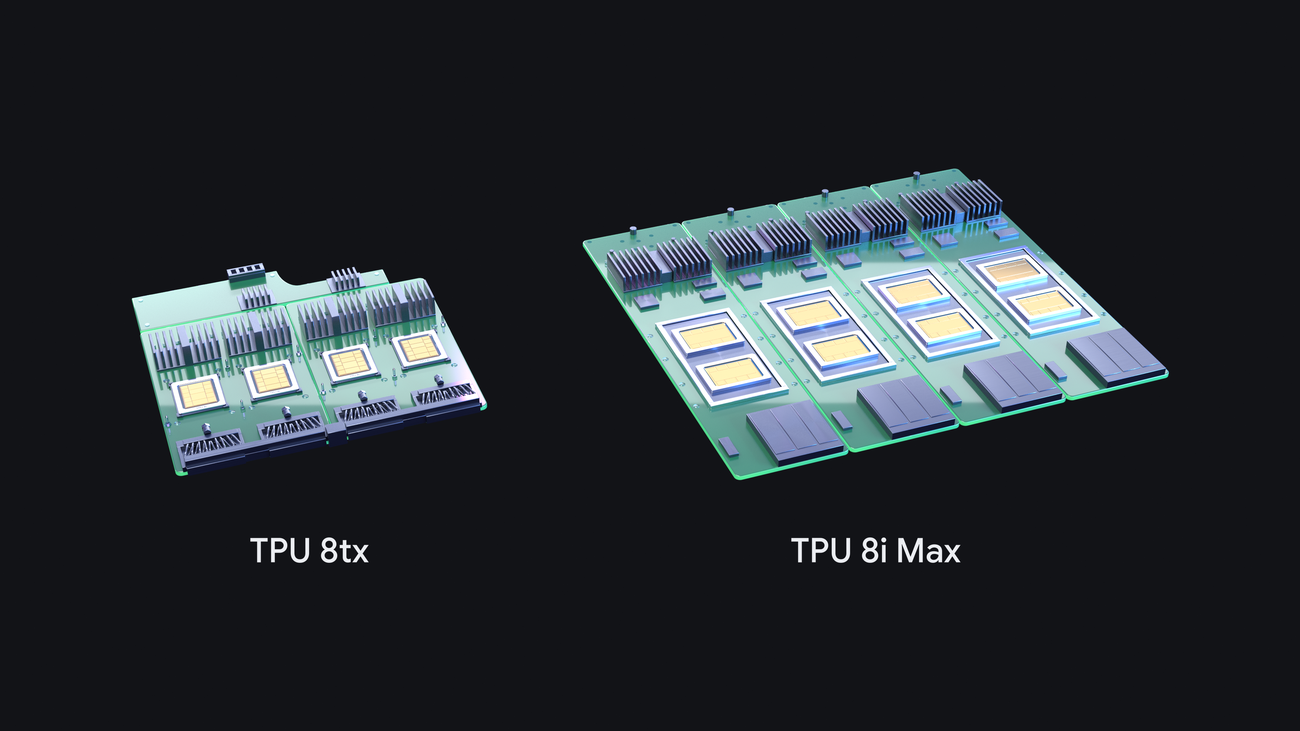
Google 9 ноября 2026 года довела линейку TPU восьмого поколения до четырёх систем: вслед за TPU 8t и TPU 8i вышли TPU 8tx с аппаратным конфиденциальным режимом вычислений и TPU 8i Max с двумя чипами в одном корпусе, рассчитанный на контексты в миллионы токенов. Одновременно компания открыла исходный код TorchTPU и XLA Serving Engine, однако цены, регионы и даты доступности новых ускорителей пока не названы.


Что произошло
Анонс включает две новые аппаратные системы и пакет программных компонентов. TPU 8tx построен на кремнии TPU 8t и работает в связке с хостами на AMD EPYC 5-го поколения; он поддерживает confidential computing на аппаратном уровне, то есть данные и веса моделей остаются изолированными даже во время активной обработки, а задержка, по данным Google, до двух раз ниже, чем у TPU 8t. TPU 8i Max объединяет два чипа TPU 8i в одном корпусе: вычислительная мощность, объём SRAM и пропускная способность HBM удваиваются, а повышенная плотность вычислений на стойку должна помочь справляться с очень длинными контекстами. Параллельно открыт код TorchTPU для нативного запуска PyTorch и моделей Hugging Face на TPU, C++-рантайма XLA Serving Engine для обслуживания моделей на TPU, GPU и CPU, а также компонентов TPU Sync и Agent Compute Engine: первый, по заявлению Google, снижает задержку передачи KV-cache более чем на 90%, второй выгружает состояние простаивающих агентных сессий с чипа за миллисекунды.
Контекст
До этого анонса восьмое поколение TPU состояло из двух систем, TPU 8t и TPU 8i, и все четыре релиза года Google выстроила как единый портфель, отвечающий на два заметных запроса рынка. Первый — аппаратная защита данных: регулируемые отрасли и госсектор требуют, чтобы информация не расшифровывалась в памяти даже во время обработки. Второй — агентные нагрузки, которым нужны контексты в миллионы токенов и долгоживущие сессии, а не только пиковые FLOPS. Отдельным барьером исторически была экосистема: команды с PyTorch-стеком вынуждены были адаптировать код под TPU отдельно, тогда как конкуренты работали в привычном окружении CUDA. Показателен и выбор метрик: Google оценивает новые системы не по сырой производительности, а по сквозным показателям агентных пайплайнов — задержке передачи KV-cache, управлению состоянием сессий и плотности размещения на стойку.
Почему это важно для индустрии
Google впервые за год выпустила четыре TPU-системы и сместила конкуренцию с уровня отдельных чипов на уровень готовых систем, где чипы, сеть Boardfly, хосты и упаковка работают как единое целое. Конкурентам — NVIDIA, AMD и AWS Trainium — теперь придётся отвечать на запросы enterprise-сегмента не только сырой производительностью, но и аппаратной конфиденциальностью и плотностью размещения. Для команд, которые раньше не рассматривали TPU, открытый TorchTPU и мульти-бэкендовый сервисный слой снижают стоимость миграции, а связка TPU 8i Max, TPU Sync и Agent Compute Engine задаёт новый ориентир юнит-экономики агентных продуктов: ниже цена обслуживания длинного контекста, выше плотность сессий на стойку. Если тиражирование состоится, для стартапов на PyTorch-стеке это станет potential platform shift.
Почему это важно для пользователей
Разработчикам с нагрузками на PyTorch и Hugging Face часть изменений доступна уже сейчас: TorchTPU открыт, поэтому код запускается на TPU нативно, без переписывания, а готовые бэкенды для vLLM и SGLang упрощают инференс — переносимость собственного пайплайна можно проверить в экспериментальном контуре до покупки железа. Выбор между новыми системами определяется сценарием: TPU 8tx подходит там, где данные нельзя расшифровывать в памяти, например в финансах, госсекторе или медицине; TPU 8i Max — там, где нужен огромный контекст за один прогон, от десятков параллельных агентов до целых кодовых баз или часов видео. Планировать мощности и бюджет под новые ускорители пока рано, так что практический первый шаг для команды — пилот открытого софта и прототипирование паттерна «сон и пробуждение» для агентных сессий на уровне архитектуры приложения.
Что пока неизвестно / ограничения
Основные неизвестности сосредоточены в железе. Цены, регионы и даты GA для TPU 8tx и TPU 8i Max не объявлены, поэтому считать системы готовыми к промышленной эксплуатации и закладывать их в планирование мощностей и бюджет нельзя. Заявка о задержке до двух раз ниже, чем у TPU 8t, дана без описания нагрузок и конфигураций, и проверить её до появления независимых замеров невозможно. Контексты в миллионы токенов не сопровождаются ни одним измерением: нет данных ни о задержке, ни о пропускной способности, ни о качестве генерации, а TPU 8i Max — это масштабирование через упаковку двух чипов, а не новая архитектура. Открытыми до GA и внешних проверок останутся реальные overhead-цифры confidential computing в продакшене и зрелость бэкендов vLLM и SGLang под TPU.
Источники
- Introducing TPU 8tx and TPU 8i Max — Google Blog (Amin Vahdat, SVP and Chief Technologist, AI and Infrastructure)
- Google expands eighth-generation TPU portfolio with two new TPU systems — Data Center Dynamics (Charlotte Trueman)
Автор
Look at AI, редакция