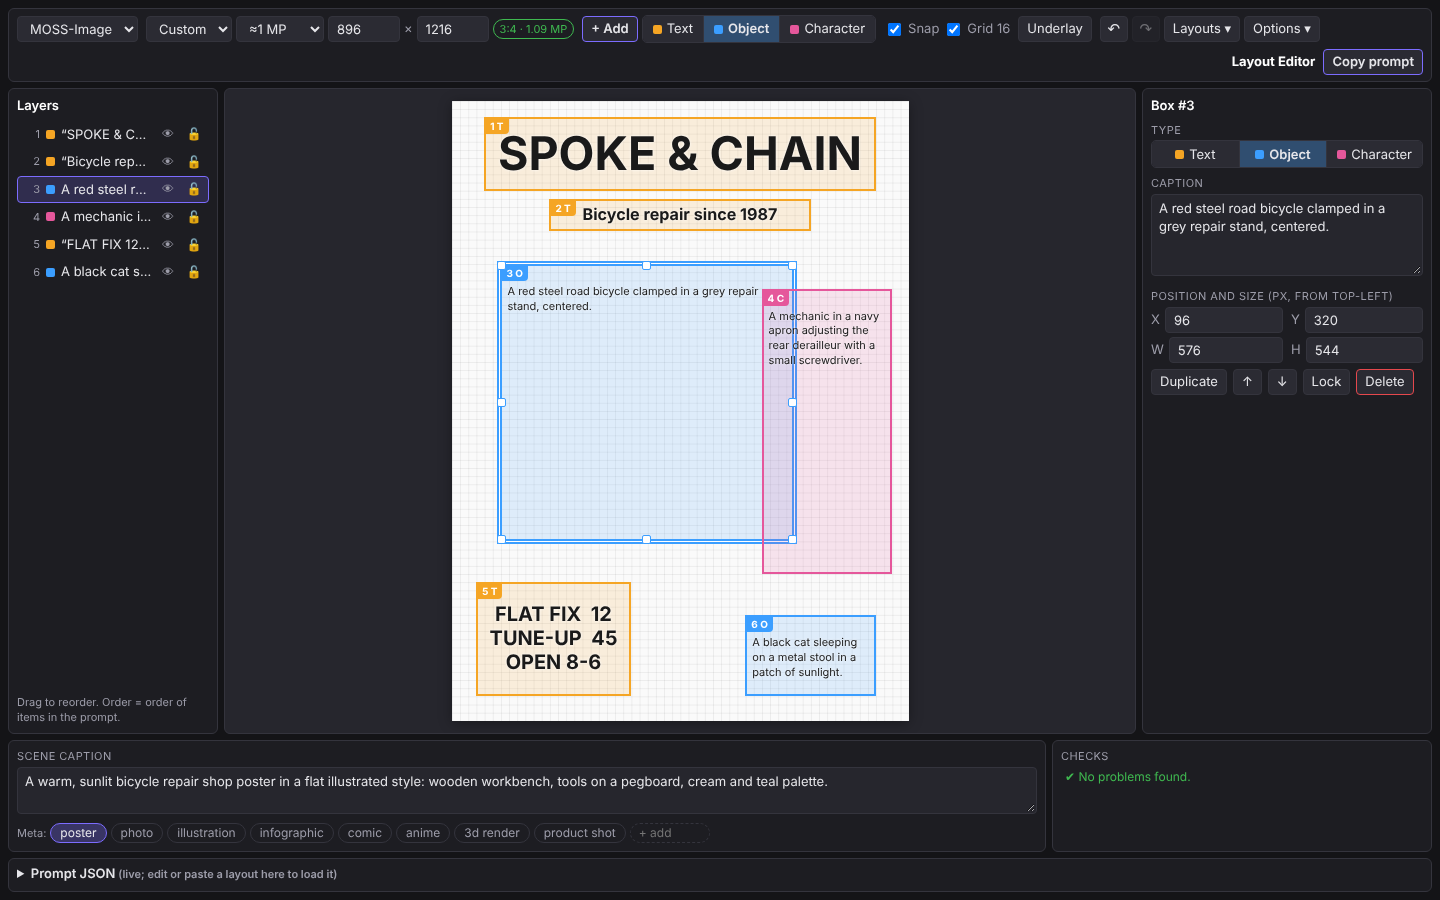
Открытая модель генерации изображений MOSS-Image от OpenMOSS за считанные недели обросла сторонним стеком бесплатных инструментов: поисковым каталогом стилей и персонажей, визуальным редактором раскладок, кастомным сэмплером для ComfyUI, сжатой INT4-сборкой для запуска в браузере и двухшаговой генерацией на новом методе дистилляции без внешнего учителя. Телеграм-канал «Нейронавт» свёл эти разработки в дайджест из примерно двадцати ресурсов. Практический итог для читателей: всё перечисленное работает без установки и без GPU, прямо в браузере.


Что произошло
Телеграм-канал «Нейронавт» опубликовал дайджест из около двадцати бесплатных ресурсов экосистемы открытой модели MOSS-Image от OpenMOSS. Каталог MOSS-Image-Character-Catalog на Hugging Face (Space пользователя hide1) теперь полностью онлайн и работает как поиск: по README репозитория это 33 935 персонажей и 314 стилей с превью и полными промптами, актуальная версия v0.1.2 датирована 4 ноября 2026 года. Для сборки сцен вышел SwarmUI-LayoutEditor пользователя jambavant на GitHub (лицензия MIT, версия от 28 октября): боксы трёх типов — текст, объект и персонаж — расставляются визуально, а раскладка экспортируется в JSON-промпт формата MOSS-Image; редактор работает и как отдельная страница в браузере. Инференс ускоряют два независимых релиза: DeltaEngine/MossInt4 — четырёхшаговый SFT в INT4 объёмом 7,5 ГБ, рассчитанный на полный запуск модели в браузере через WebGPU, и akhaliq/MOSS-Image-IDM-2-Steps — двухшаговая генерация через IDM (Intrinsic Distribution Matching), вариант дистилляции без внешнего учителя, собранный для bf16-версии модели. В подборке также упомянуты кастомный сэмплер comfyui-moss-smart-sampler для ComfyUI с перераспределением сигма-позиций и поток LoRA на Civitai, включая LoRA двойной экспозиции и Disney-2D.
Контекст
MOSS-Image — открытая layout-aware модель: сцену в ней описывает не только текстовое описание, но и структура раскладки, причём рендеринг текста внутри картинки относится к сильным сторонам генерации. Из структурности следует и механическое отличие от привычных промптов: раскладка задаётся боксами и сериализуется в JSON, который можно редактировать, хранить и передавать между инструментами — так устроены и промпты каталога, и экспорт редактора раскладок. Пользовательская среда вокруг такой модели повторяет траекторию Stable Diffusion: сначала каталоги и редакторы, затем кастомные сэмплеры, квантованные сборки и библиотеки LoRA — по оценке автора дайджеста, стек сопоставимого охвата сложился вокруг MOSS-Image примерно за три недели. Отдельный методологический пласт — IDM: в отличие от привычной дистилляции, где few-step-версию учит внешний учитель, здесь супервизией выступает статистика признаков самого генератора, то есть учителя нет вовсе. Если метод будет описан в техотчёте и воспроизведён, это изменит экономику выпуска быстрых версий image-моделей.
Почему это важно для индустрии
Для отрасли главный сигнал — не сама модель, а превращение открытой MOSS-Image в публичную платформу со сторонним стеком: каталоги, редакторы раскладок, кастомные сэмплеры, INT4-квантование и поток LoRA уже появились, а инструменты вроде MossPhoton и HaDeS Suite подстраиваются под модель за дни по оценке дайджеста. Оптимизация инференса идёт сразу по трём независимым направлениям — сжатие под edge-запуск, сокращение числа шагов и перенастройка расписания сэмплирования, — то есть инженерные решения не привязаны к одному проекту. Продуктовая возможность лежит не в тонкой обёртке над генерацией, а в связке «машиночитаемая раскладка в виде JSON-промпта плюс инференс в браузере без GPU»: минимальный вертикальный прототип, где LLM генерирует JSON-раскладку, а рендер выполняет MOSS-Image, собирается за дни на готовых компонентах. На этой базе логично ждать вертикальных продуктов — генераторов комиксов, сторибоардов и рекламных креативов, где JSON-раскладка становится форматом обмена между языковой моделью и генерацией. При почти нулевой стоимости экспериментов выигрывают команды; давление усиливается на продавцов prompt-паков и простых обёрток над генерацией. Если IDM будет опубликован и воспроизведён, учитель-фри дистилляция может за полгода стать стандартным способом удешевления few-step-версий открытых image-моделей.
Почему это важно для пользователей
Всё из дайджеста можно попробовать бесплатно, без установки и без GPU. В каталоге ищутся персонажи и стили, готовые полные промпты копируются как есть, а режим Shuffle помогает случайно перебирать варианты. Композицию удобнее собирать визуально: в SwarmUI-LayoutEditor боксы текста, объектов и персонажей расставляются прямо в браузере, после чего раскладка экспортируется в JSON-промпт формата MOSS-Image. Рендер тоже доступен в браузере: четырёхшаговая INT4-версия модели запускается через WebGPU. Пользователи ComfyUI могут ускорить генерацию кастомным сэмплером, а готовые LoRA — среди них двойная экспозиция и Disney-2D — взять на Civitai. Итог для читателя: собрать постер, обложку или шаблонную сцену реально уже сегодня, без GPU-сервера и без единой установки.
Что пока неизвестно / ограничения
Ключевые цифры дайджеста — 33 935 персонажей, 314 стилей, объём INT4-сборки и число шагов — взяты из README репозиториев и телеграм-анонсов: в источниках нет ни статьи, ни абляции, ни независимого бенчмарка, поэтому проверить их как научные данные пока невозможно. Ни один факт подборки не сопровождается количественной оценкой: нет замеров качества текстового рендеринга и соответствия раскладке, а качество после INT4-квантования относительно bf16-версии и после двух шагов IDM не измерено вовсе. Метод IDM не описан в техотчёте, так что его воспроизводимость остаётся гипотезой. Оценки «примерно три недели» и «адаптация за дни» — это авторские оценки дайджеста, а не измеренные величины, и поведение пресетов кастомного сэмплера независимо не проверено.
Источники
- MOSS-Image Character and Style Catalog — Hugging Face Space (hide1)
- jambavant/SwarmUI-LayoutEditor — layout editor for MOSS-Image (GitHub)
- DeltaEngine/MossInt4 — 4-step MOSS-Image SFT, INT4, WebGPU (Hugging Face)
Автор
Look at AI, редакция