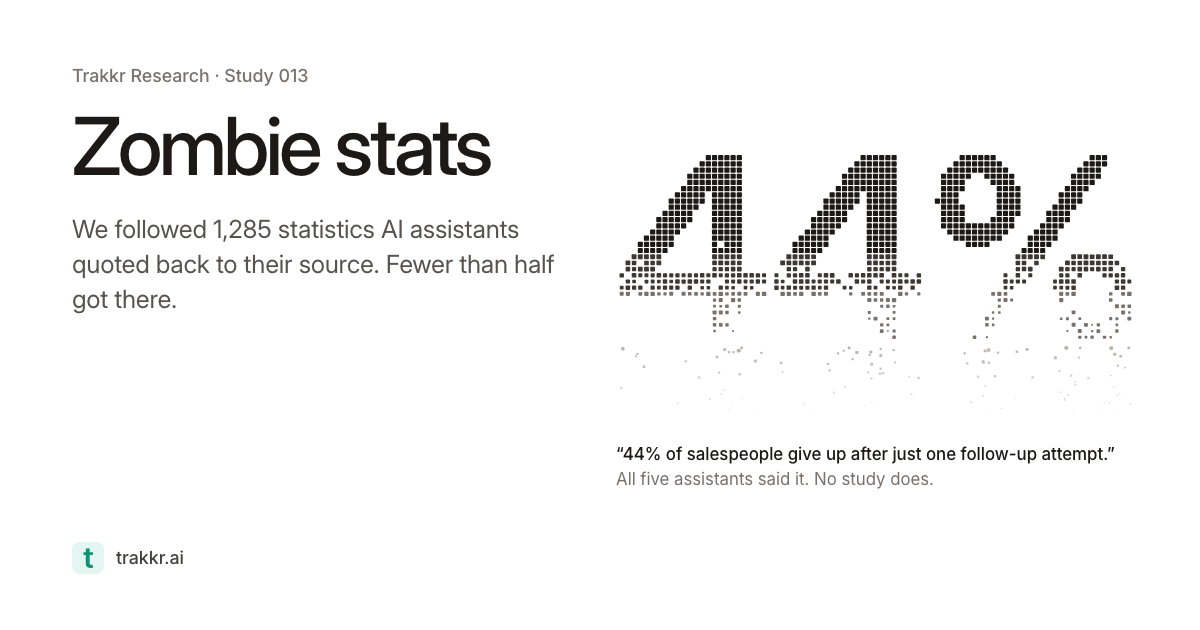
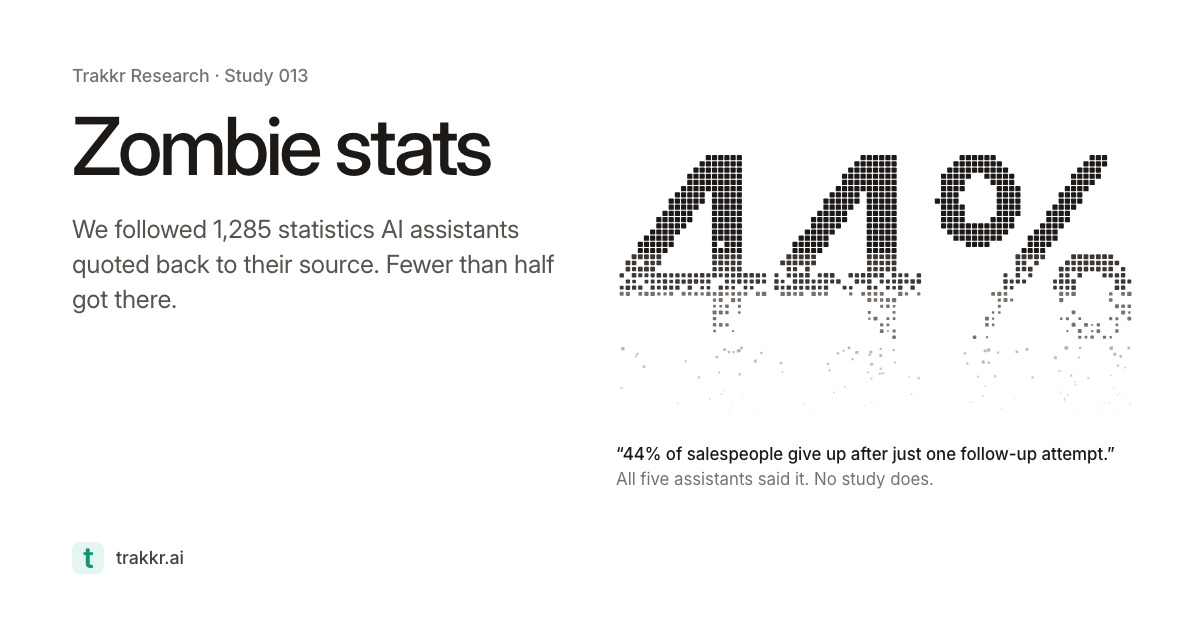
Компания Trakkr Research в отчёте «Zombie Stats: Where the Numbers AI Quotes Come From» (Study 013, октябрь 2026) проследила 1285 статистических цифр, процитированных ChatGPT, Perplexity, Gemini, Claude и Google AI Overviews, до первоисточников — вглубь до пяти страниц. Подтвердить до исследования удалось меньше половины цифр, и чаще всего ссылка ведёт не на науку, а на корпоративный блог. Проблема оказалась не в галлюцинациях: ассистенты почти не выдумывают числа, но цитируют вторичные пересказы, потерявшие связь с первоисточником, — и подают их тем же уверенным тоном, что и проверяемые факты.
Что произошло
В октябре 2026 года Trakkr Research опубликовала исследование Study 013 «Zombie Stats: Where the Numbers AI Quotes Come From». Авторы собрали 1285 статистических цифр из ответов пяти ассистентов — ChatGPT, Perplexity, Gemini, Claude и Google AI Overviews — и трассировали каждую ссылку до первоисточника на глубину до пяти страниц. У каждой цифры оказался один из четырёх статусов: в 40% случаев исследование нашлось и подтвердило именно это число; ещё в 8% исследование обнаружилось, но число или контекст исказились по пути; в 40% цепочка оборвалась на источнике, который закрыт, удалён или ничего не сообщает о цифре; 11% ссылок не привели никуда. В сумме 60% цифр из ответов ассистентов не доходят до проверяемого первоисточника. По доле подтверждённых цифр лидирует ChatGPT со значением 57%, и это та модель, которая цитирует реже всех — 1,3 цитаты на ответ. Claude выдаёт больше всех чисел — 6,8 цитаты на ответ — при худшей доле подтверждённых.
Контекст
Ключевой вывод отчёта в том, что это не классические галлюцинации. Цифра присутствовала на странице, куда ссылалась модель, в 82% случаев, то есть ассистенты практически не сочиняют числа с нуля. Дефект сидит дальше по цепочке цитирования: 54% ссылок ведут на корпоративные блоги, где исходное исследование пересказано с потерей контекста, а иногда и с изменившимся числом. Отсюда и название: статистика становится «зомби», когда цифра продолжает кочевать по сети после того, как связь с породившим её исследованием разорвана. Отдельная находка касается взаимного согласия моделей. На десяти вопросах, по которым все пять ассистентов отвечали одинаково, полностью подтвердились только две цифры, а четыре числа, повторенные всеми пятью, не имели за собой никакого исследования. Когда модели опираются на одни и те же вторичные источники, их единодушие выглядит как перекрёстная проверка, но ею не является.
Почему это важно для индустрии
Для индустрии отчёт переводит разговор о кризисе цитирования из анекдотов в измеримый дефект и точно локализует причину: не в генерации, а в retrieval-слое и правилах цитирования, поэтому улучшать саму генерацию почти бесполезно. Без переобучения модели сегодня можно собрать три рабочих шага: понизить в выдаче агрегаторы и корпоративные блоги, отдавая приоритет первоисточникам; ограничить число статистических утверждений на один ответ, потому что в выборке наименьшее количество цитат совпало с наибольшей точностью; добавить во внутренние eval-наборы аудит трассировки цитат. Оптимизация метрики «больше ссылок» рискованна: она поощряет цитирование именно тех вторичных источников, которые портят данные. Продуктовый прототип уже не выглядит сложным: агент берёт ответ ассистента, извлекает цифры, проходит по ссылкам на глубину до трёх–пяти страниц и возвращает статус каждой цифры (подтверждена, изменилась, источник непроверяем, тупик) — на доступных поисковых и агентных API это дневная работа. Бизнес-риск конкретен: в compliance-документации, регуляторных и инвесторских материалах такая статистика может содержать числа, которые нельзя защитить перед аудитором, при том что NIST AI RMF 1.0 и EU AI Act требуют оценивать качество вывода ИИ. Если выводы подтвердят независимые репликации — это прогноз, а не результат самого исследования, — доля подтверждённых цитат может стать стандартной eval-метрикой для RAG и ассистентов, а доказательство происхождения цифры — обязательным артефактом отчётных процессов.
Почему это важно для пользователей
Для читателя главный сдвиг в привычке: цифра от нейросети не доказательство, а заявка на проверку. Если статистика нужна для поста, презентации, делового письма или разговора с клиентом, стоит попросить у ассистента первоисточник, открыть ссылку и сверить год, размер выборки и точную формулировку утверждения — в этой выборке числа и контекст не раз менялись при пересказе. Наглядный пример — цифра о «44% продавцов»: под ней в оригинале стояло узкое исследование, в котором 15 женщин оценивали сайты здоровья, но после размножения по корпоративным блогам она превратилась в «универсальный факт», который ассистенты уверенно цитируют уже вне связи с исходным контекстом. И последнее: аргумент «несколько моделей это подтверждают» работает не в пользу цифры. Если модели учатся на одном и том же вторичном источнике, повторение наследует его смещение, а не создаёт независимое подтверждение.
Что пока неизвестно / ограничения
Материал остаётся отчётом самой Trakkr Research (Study 013), а не независимым benchmark: в открытых описаниях не раскрыты процедура формирования выборки вопросов и критерии отнесения цифры к той или иной категории, поэтому воспроизвести выводы вне методологии авторов сложно. Непроверяемая цифра не равна выдуманной: часть ссылок оборвалась на закрытых или удалённых страницах, содержание которых восстановить уже нельзя. Выборка ограничена пятью ассистентами и 1285 цифрами, так что переносить доли на все модели и сценарии без независимых репликаций рано. Строить по этим данным прогнозы о будущих стандартах и метриках можно, но это интерпретация, а не вывод отчёта.
Источники
- Zombie Stats: Where the Numbers AI Quotes Come From (Trakkr Research, Study 013)
- Only 40% of AI-Cited Stats Are Verifiable, Trakkr Research Finds (aigovernance.com)
- Zombie Stats: AI Numbers Often Lack Real Sources (Grafy News)
Автор
Look at AI, редакция