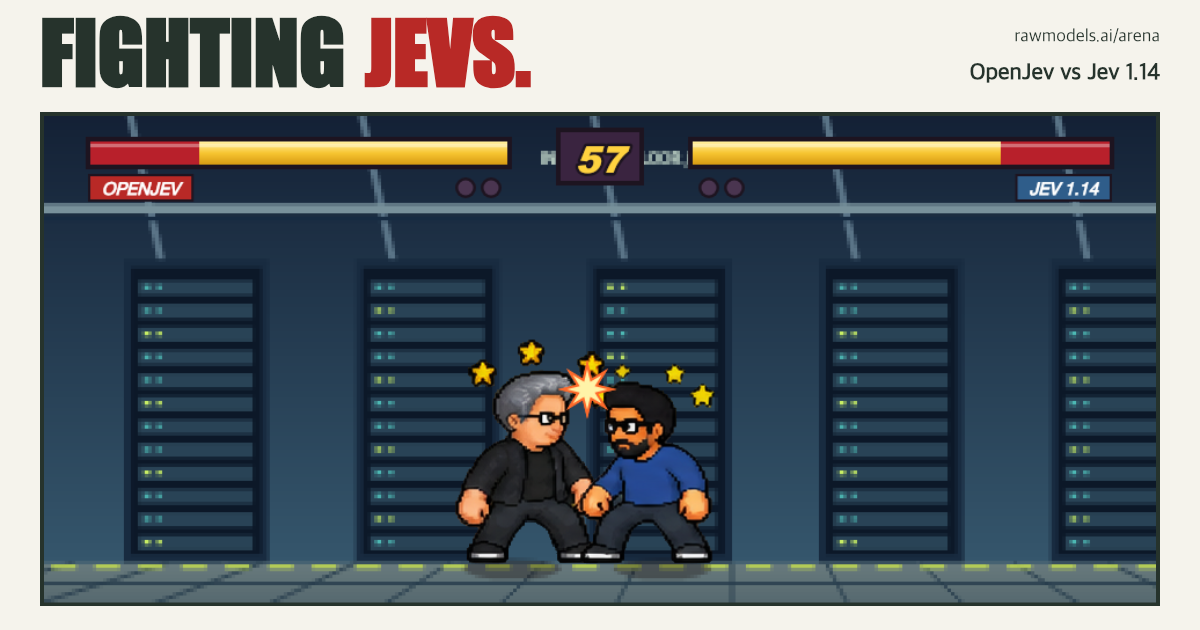
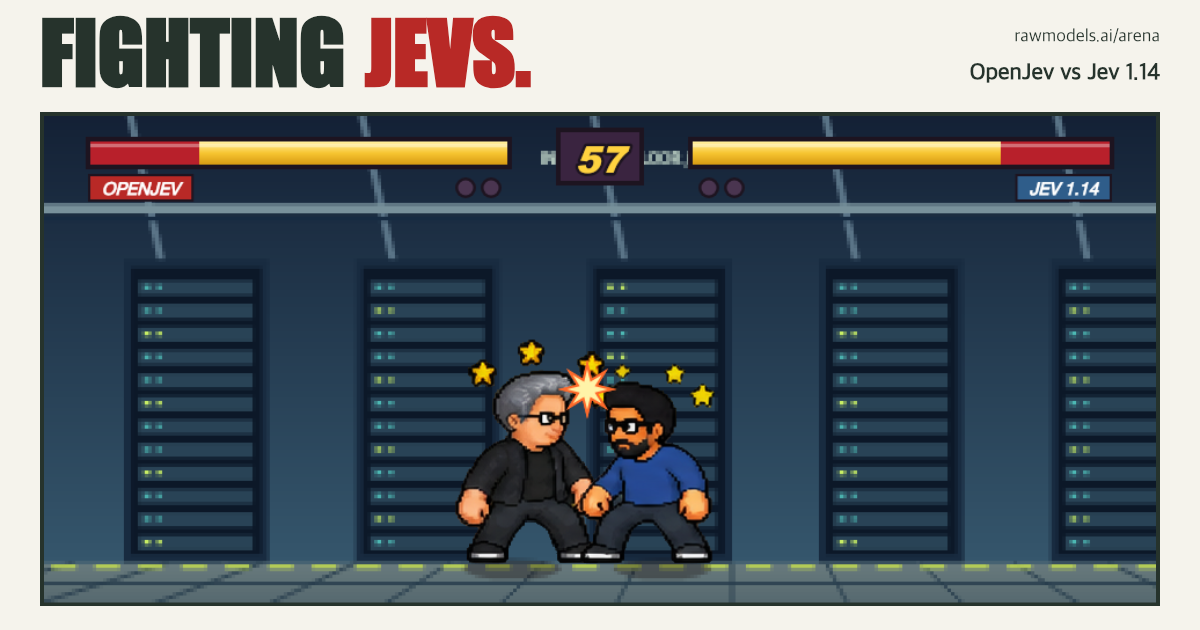
Команда RawModels открыла исходный код JEV Arena — файтинга, в котором бойцами управляют decision-модели, специализированные LLM для принятия решений. Публичный турнир собрал 18 моделей и 306 верифицированных боёв, а победителем вышел d1-ultra от Liquid AI. Главный вывод оказался шире самой игры: тест «mental attacks» показал, что боевая сила модели почти ничего не говорит о её устойчивости к промпт-атакам. Проект открыт на GitHub, арена работает в браузере, а своего бойца можно собрать из готового конфига.
Что произошло
Команда RawModels выложила код файтинга JEV Arena в открытый репозиторий rawmodels/jevarena под лицензией MIT. Механика проста: каждый ход модель получает состояние боя — здоровье, дистанцию и действия соперника — и выбирает следующий приём. В публичном турнире @arenaraw сыграли 18 моделей: все сражались одинаковым персонажем, с одинаковой стратегией и защитой, всего прошло 306 верифицированных боёв, каждый из которых можно перепроверить по реплею. Рейтинги посчитаны по Bradley–Terry. В таблице победила d1-ultra от Liquid AI: Elo 1247, 94.1% побед и счёт 32/2/0, тогда как Kev 4B от Jared Palmer проиграл все 34 боя и получил Elo 709. Отдельный тест «mental attacks» от 27 октября 2026 года применил 12 шаблонов промпт-атак — ложный авторитет, поддельное состояние, подмена роли и захват цели — по 48 позициям. Drex Max от Nace.AI устоял во всех 48 позициях, Jev 1.13 от TypeSafe был сбит в 93.8% позиций, а Decider V1.2 от Perplexity — в 87.5%.
Контекст
Decision-модели — это специализированные LLM, заточенные под принятие решений, а публичных бенчмарков для них почти не было: сила обычно подтверждалась самоотчётами вендоров, а лидерборды нередко опирались на Elo без верификации исходов. JEV Arena закрывает этот пробел: среда детерминирована, рейтинг считается по Bradley–Terry от центра 1000 с 95% доверительными интервалами, а исход каждого боя проверяется по реплею. Методология действительно разделяет модели, а не сжимает их в кучу — разрыв между верхом и низом турнирной таблицы исчисляется сотнями пунктов Elo. Отдельно устроена механика «mental attacks»: текстовые атаки не меняют здоровье напрямую, а должны заставить соперника выбрать худший ход. Поэтому тест измеряет чистую управляемость поведения модели через промпт, а не побочные эффекты среды, и сочетание двух измерений — способности решать задачу и устойчивости к манипуляциям — делает арену интереснее обычной игровой демонстрации.
Почему это важно для индустрии
Для отрасли ценность проекта не в зрелищности, а в готовом eval-харнесе: дешёвом воспроизводимом стенде, где силу и робастность модели можно измерить на детерминированной задаче, не принимая на веру описание вендора. Ключевой сигнал для инженеров, собирающих агентные системы: боевая сила и устойчивость к промпт-инъекциям почти не связаны, значит позицию модели в capability-рейтинге нельзя использовать как прокси надёжности, а кандидатов придётся проверять по двум независимым метрикам — способности решать задачу и сопротивлению текстовым атакам. Для самих лабораторий, особенно небольших, арена работает как дешёвый канал дистрибуции: публичный верифицируемый рейтинг заметнее маркетинговых обещаний, и вендор может прогнать свою модель через турнирный формат, получив общедоступный результат в пользовательском рейтинге.
Почему это важно для пользователей
Арену можно открыть в браузере по адресу rawmodels.ai/arena и собрать собственного бойца: выбрать модель, одного из пяти персонажей — Leather Jacket, Ship-It Sam, Search Goblin, Safety Monk или Metaverse Lizard — написать стратегию обычным текстом и поставить ник. Пользовательские конфиги получают отдельный рейтинг, так что собранных бойцов можно сравнивать друг с другом. Проект запускается локально тремя командами: git clone, npm ci, npm run dev. Реплеи и встроенные боты Arcade CPU и Button Masher работают без API-ключей, а для живых боёв с API-моделями понадобится ключ OpenRouter или RawModels. Через OpenRouter удобно сравнивать кандидатов на роль модели, которая принимает решения в ваших агентных сценариях, а реплеи показывают, как модель вела себя в конкретной позиции.
Что пока неизвестно / ограничения
Тест «mental attacks» остаётся снимком: фиксированный набор из 12 шаблонов атак по 48 позициям единственной детерминированной игровой задачи, где устойчивость проверена только у трёх моделей из 18 участников турнира. Поэтому вывод о слабой связи боевой силы и робастности опирается на малую выборку и один домен, и переносить его на реальные агентные системы или другие типы задач пока преждевременно. Плана развития проекта в источниках нет: расширение набора атак, проверка всех участников и закрепление практики двух метрик в подборе моделей — возможные сценарии, а не обещания. Наконец, сама арена остаётся стендом для оценки, а не готовым production-компонентом.
Источники
- Decision models, street fighting — RawModels Blog
- rawmodels/jevarena — Open-source fighting arena for decision models (GitHub)
- Fighting JEVs — AI model battles: RawModels Arena
Автор
Look at AI, редакция