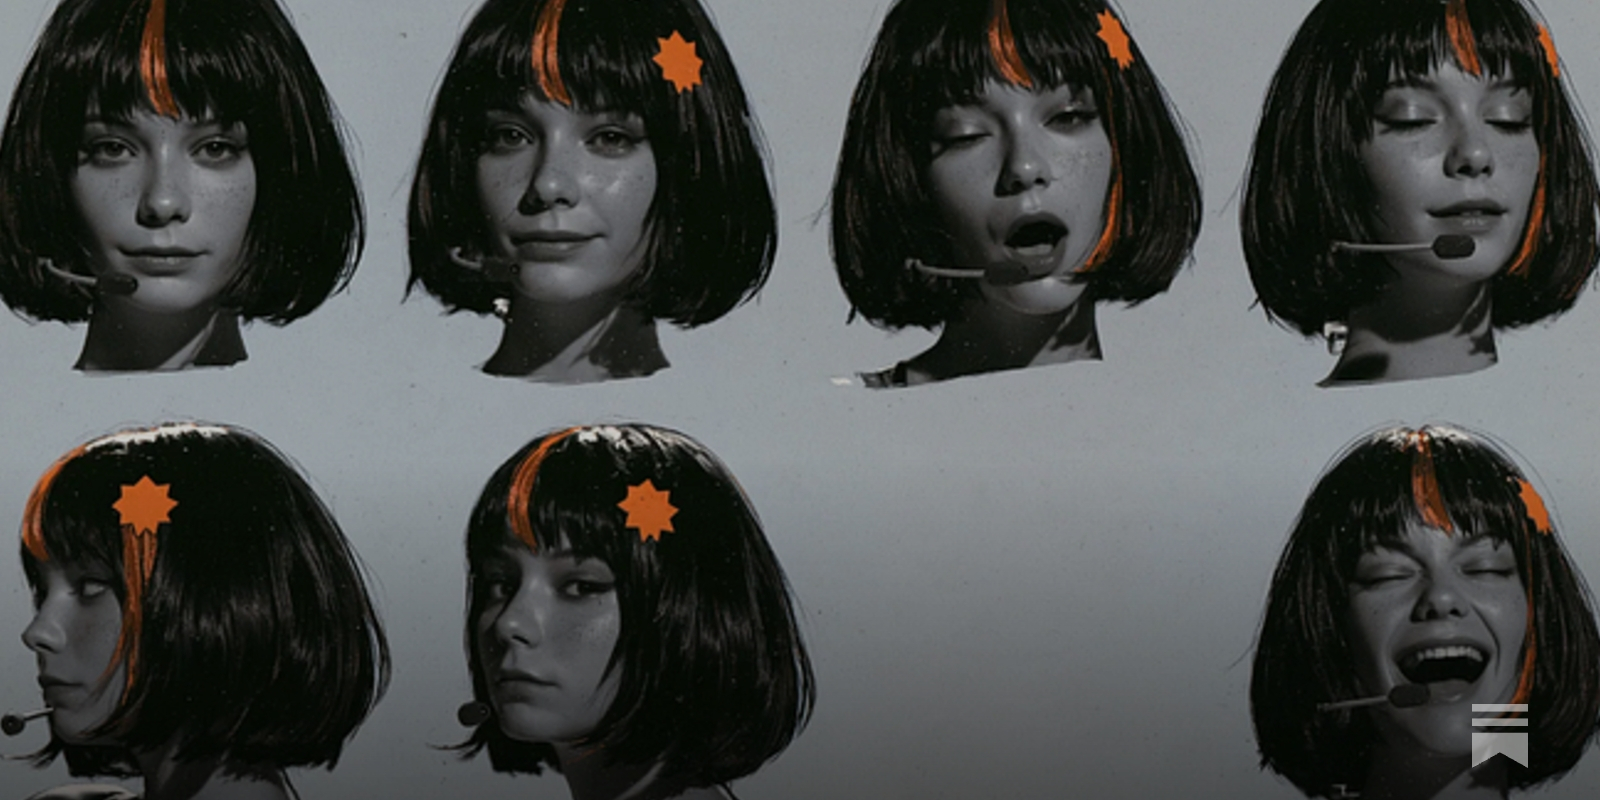
Asterisk Magazine опубликовал интервью с RJ Tevonian (@anabology), создателем музыкальных клипов в жанре «slopcore» с AI-персонажем Claudia. Главный вывод материала: в AI-видео центр тяжести смещается с генерации изображений на оркестрацию моделей — Claude Opus 5.5 работает диспетчером мульти-модельного конвейера, где музыку делает Suno, персонажа собирают в Midjourney, кадры рисует Seedance, а lip-sync берёт на себя MiniMax H3. Отдельные приёмы этого пайплайна можно попробовать уже сегодня: всё работает через публичные API и не требует собственных GPU.
Что произошло
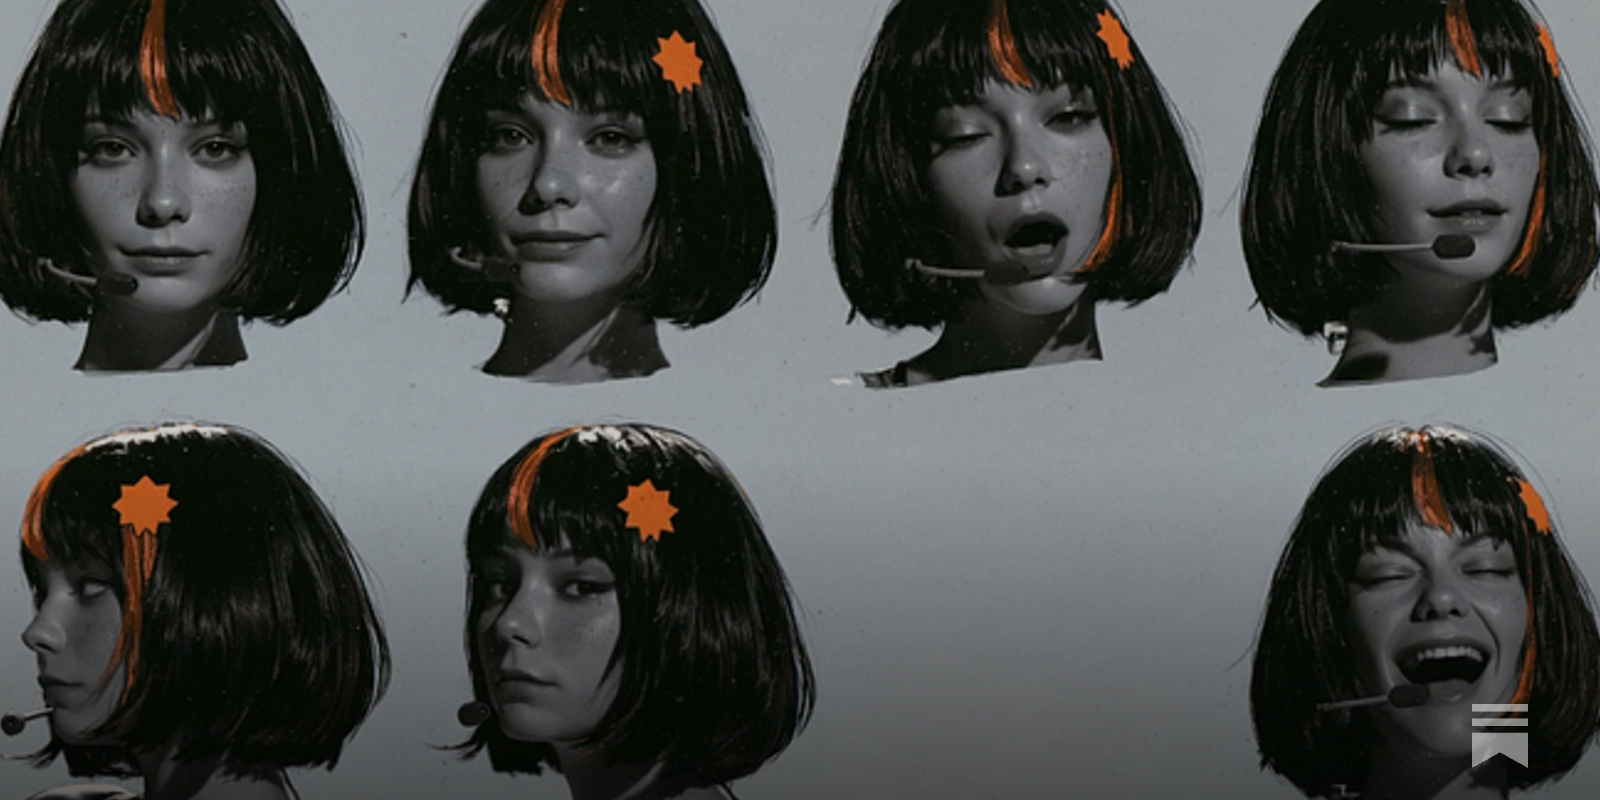
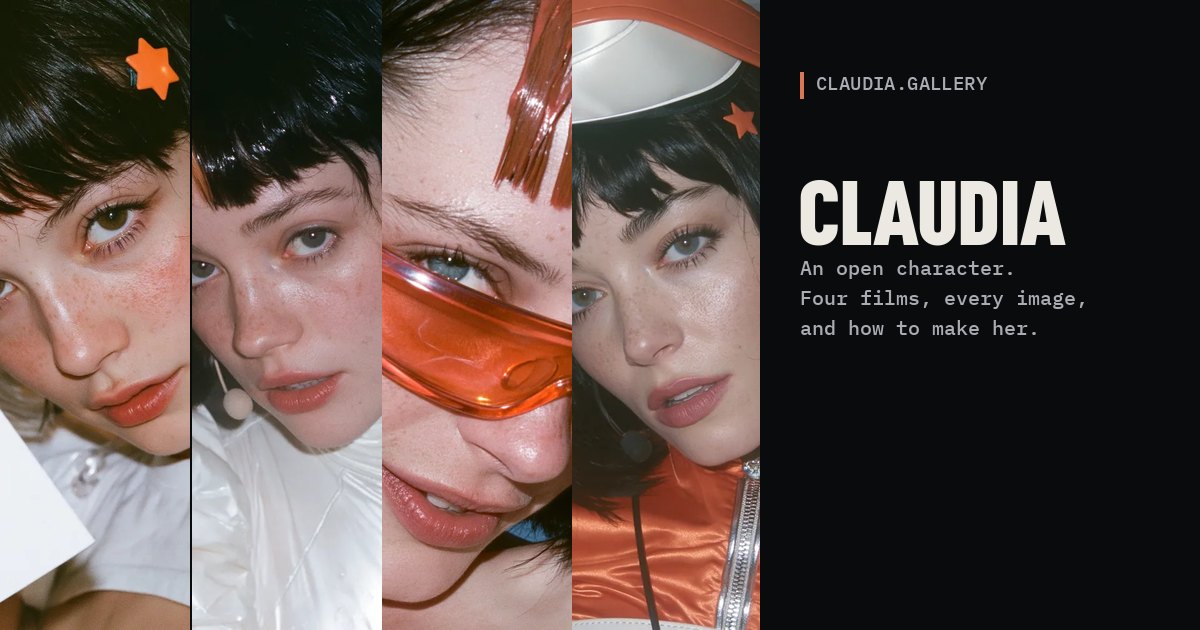
Asterisk Magazine выпустил материал Behind the scenes of those Claude slopcore music videos — интервью с RJ Tevonian, который под ником @anabology публикует клипы с AI-персонажем Claudia. В нём автор по шагам разбирает свой пайплайн. Claude Opus 5.5 работает диспетчером: пишет тексты песен, через Suno генерирует 30–40 вариантов каждого трека, из которых отбираются рабочие, составляет раскадровку и анимирует сцены на JavaScript прямо в браузере. Затем видео-модель Seedance перерисовывает кадры, придавая им освещение и текстуру. Консистентность внешности персонажа держится на внешнем состоянии: character sheets готовятся в Midjourney, точечные правки вносятся через GPT Image 2.5 Sunburst или Ideogram, а точную синхронизацию губ выполняет более дешёвая модель MiniMax H3 с последующим ремастерингом. Готовые работы автора собраны в портфолио на claudia.gallery.
Контекст
«Slopcore» — молодое направление AI-видео, чья эстетика сознательно построена на несовершенстве генераций: артефакты не скрываются, а сохраняются в духе wabi-sabi, монтаж делается быстрым и рваным, а клипы перегружены плотными культурными отсылками. Публикация вышла на фоне оживлённого обсуждения AI-видео на Hacker News, где читатели спорят, что такие работы говорят о нынешнем состоянии генеративных моделей. Технически примечателен вывод о разделении ролей: современные видео-модели сами не удерживают идентичность персонажа между сценами, поэтому консистентность обеспечивается снаружи — отдельными артефактами и пост-обработкой. Общая картина совпадает с более широким трендом: «планирование кодом» берёт на себя LLM, а синтез аудио, изображений и видео остаётся за специализированными моделями.
Почему это важно для индустрии
Для индустрии кейс — практическая демонстрация паттерна «дорогая модель-оркестратор плюс дешёвые специализированные исполнители». Claude Opus 5.5 здесь не генерирует пиксели, а пишет лирику, промпты, раскадровку и JavaScript-анимацию, координируя Suno, Midjourney, Seedance, GPT Image 2.5 Sunburst / Ideogram и MiniMax H3. Роутинг по ценовым уровням виден в чистом виде: точную подзадачу lip-sync выполняет дешёвая модель, а дорогое качество достигается ремастерингом поверх её результата. Стоимость продакшена музыкального видео от этого опускается от студийного бюджета до уровня API-счетов и времени одного оператора, причём весь конвейер идёт через публичные API без собственных GPU. Слабое место паттерна — консистентность персонажа — создаёт запрос на инструменты управления состоянием персонажа и бенчмарки долговременной идентичности. При этом бизнес-модель в кейсе не показана: техника валидирована, но рынок и защищаемое преимущество пока не продемонстрированы.
Почему это важно для пользователей
Читателям, которые делают AI-видео сами, материал выгодно отличается тем, что даёт рабочие приёмы, а не абстрактные рассуждения о будущем жанра. Портфолио на claudia.gallery позволяет сперва посмотреть результат целиком и трезво оценить уровень работ. Далее приёмы воспроизводимы руками уже сегодня: character sheets для консистентности персонажа, lip-sync на дешёвой модели с дорогим ремастерингом и JavaScript-анимация как раскадровочный каркас, причём JavaScript оказывается «комфортной зоной» Claude для кода. Всё собирается из публичных API и без GPU, однако это уровень прототипов и кастомных скриптов: готового SaaS нет, поэтому минимальный продукт придётся склеивать из сервисов самостоятельно.
Что пока неизвестно / ограничения
Это self-reported кейс одного автора, а не методология: в интервью нет ablation-экспериментов и метрик, а также чисел по стоимости, времени сборки и доле отбракованных генераций, поэтому снижение стоимости продакшена корректно считать гипотезой, а не измеренным результатом. Слова о «воспроизводимом рецепте» требуют опубликованных промптов, character sheets и параметров моделей, которых публикация раскрывает не целиком. Остаётся неизвестной и бизнес-составляющая: монетизация, рынок и защищаемое преимущество в материале не показаны. Наконец, переносимость паттерна на другие жанры и команды пока не проверена независимым воспроизведением.
Источники
- Behind the scenes of those Claude slopcore music videos — Asterisk Magazine (интервью с RJ Tevonian)
- Behind the scenes of those Claude slopcore music videos | Hacker News (обсуждение)
- Claudia · claudia.gallery (портфолио AI-видео, упомянуто в обсуждении HN)
Автор
Look at AI, редакция