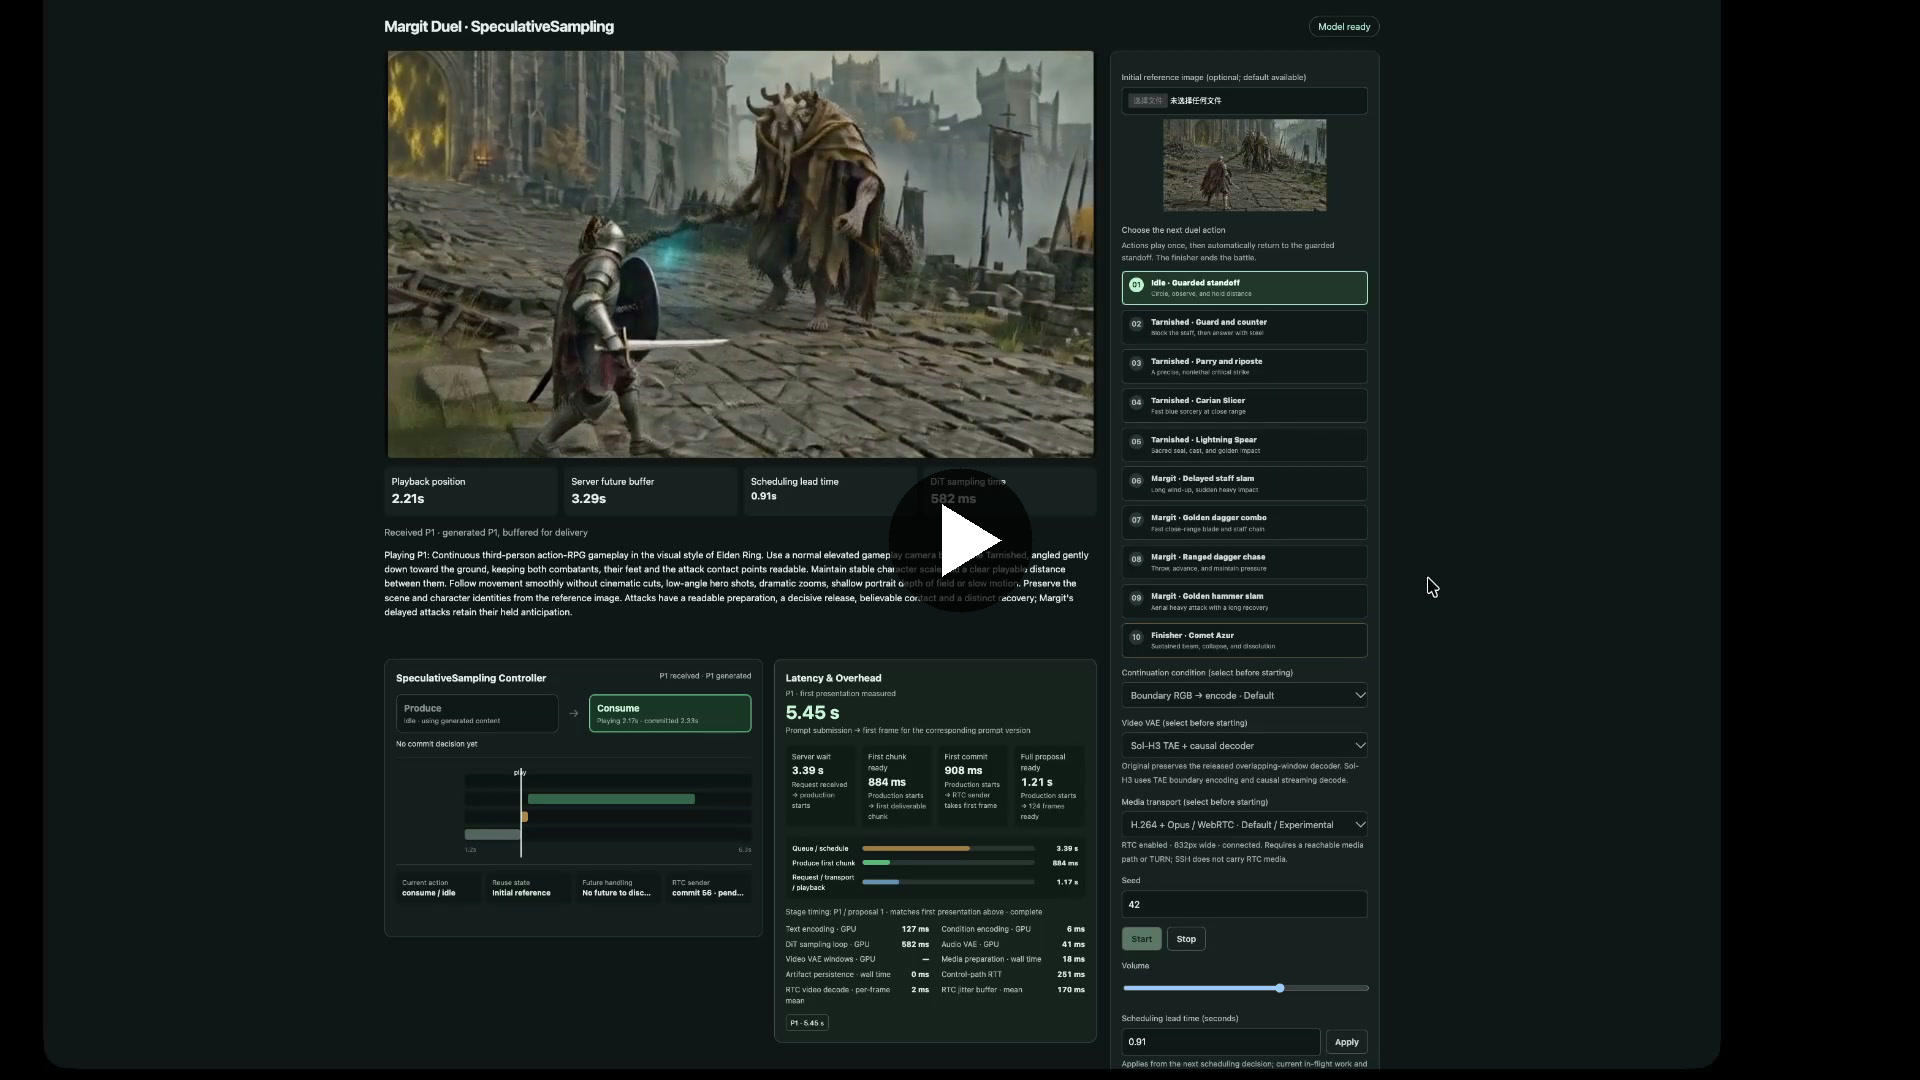
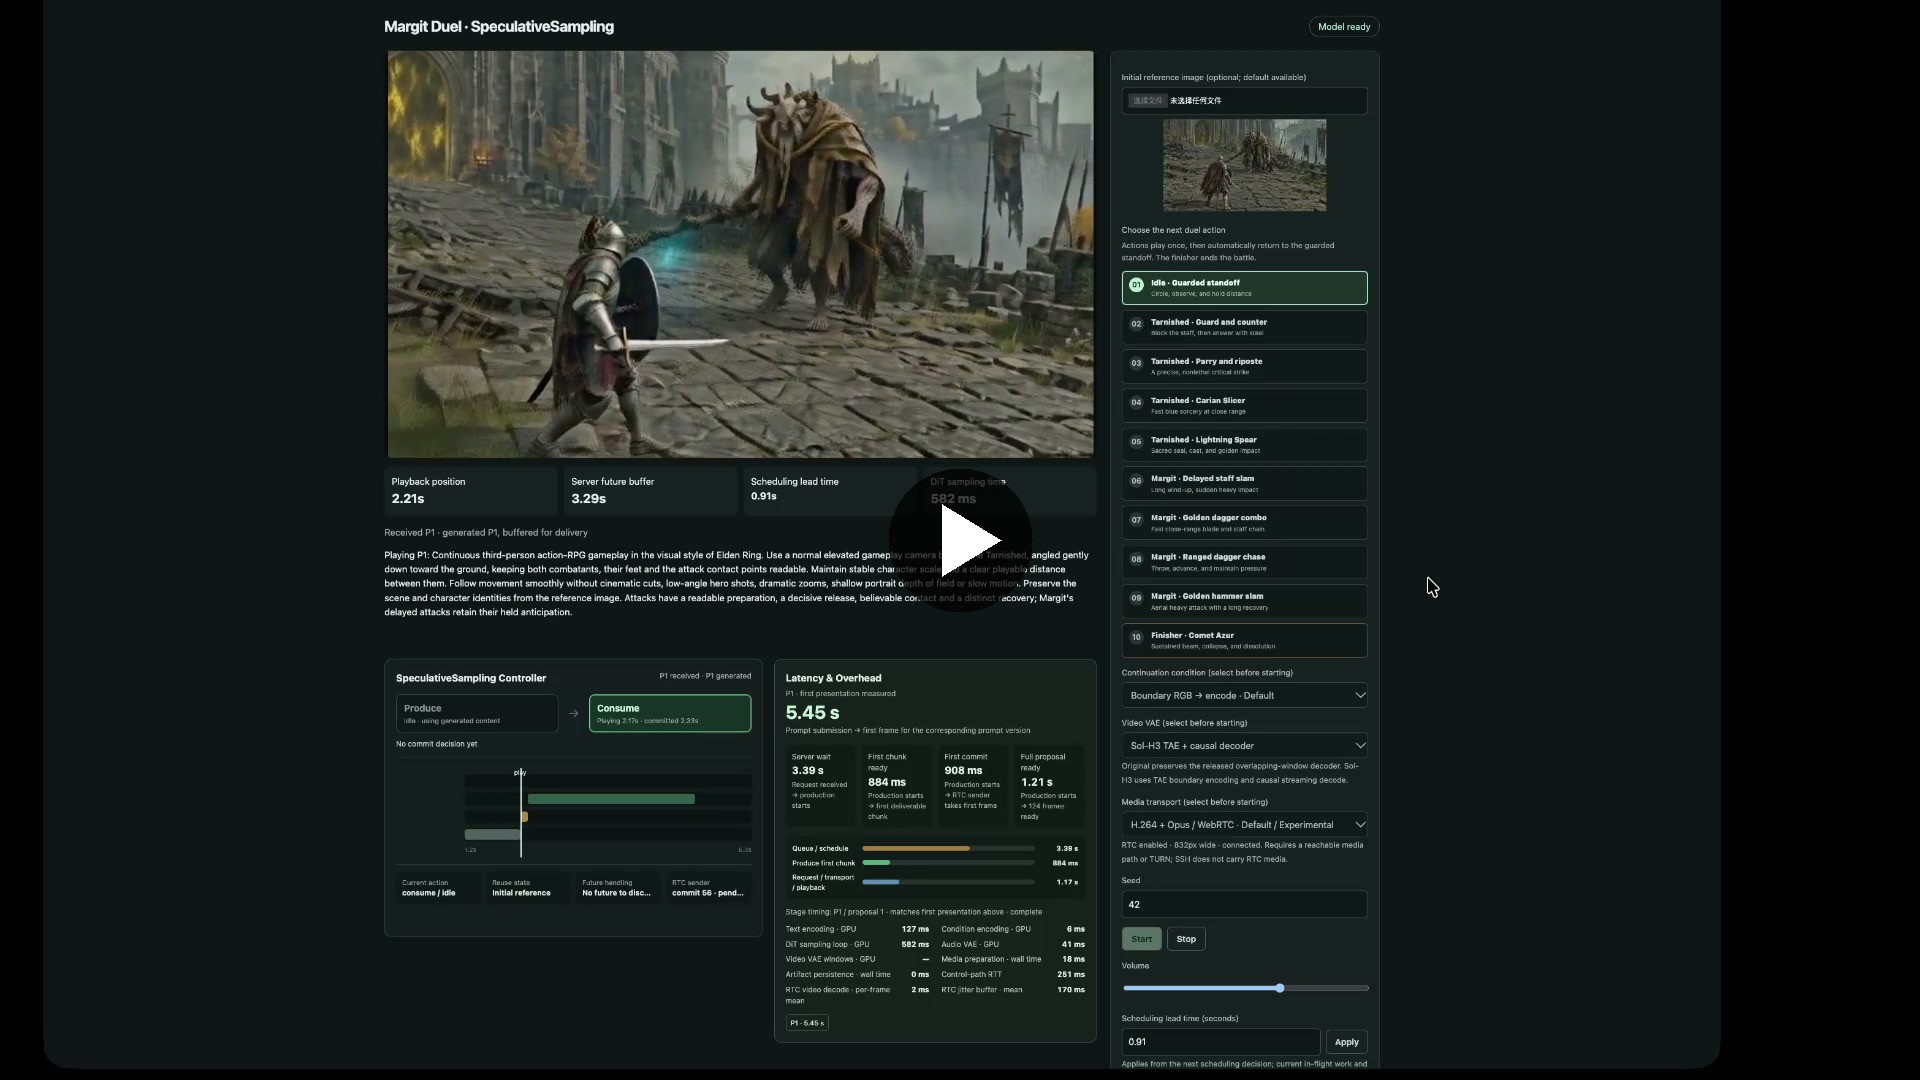
Метод Speculative Sampling превращает существующие двунаправленные видеомодели в интерактивные без какого-либо дообучения: модель заранее вычисляет крупный чанк со встроенным шумовым паддингом, предсказания кэшируются и раздаются по мере проигрывания, а при смене ввода пересчитывается только незафиксированный хвост. На валидированном стеке из восьми ускорителей NVIDIA B300 модель MiniMax H3 выдаёт первый кадр интерактивного видео примерно за 1,4 секунды. Препринт опубликован на arXiv под номером 2610.20556, код открыт на GitHub под лицензией Apache 2.0.

Что произошло
14 октября 2026 года исследователи Yubo Huang, Yuxuan Zhang, Jiaming Liu, Sirui Zhao и Enhong Chen опубликовали препринт Speculative Sampling in Interactive Video Generation (arXiv:2610.20556) и одновременно открыли код на GitHub под лицензией Apache 2.0. Метод training-free: видеомодель заранее генерирует крупный двунаправленный чанк со встроенным шумовым паддингом, после чего предсказания накапливаются в кэше и выдаются зрителю по мере проигрывания. Когда пользователь меняет условие генерации, неизменяемый префикс сохраняется, а пересчитывается только ещё не зафиксированный хвост. В валидированной конфигурации использовались стек из восьми NVIDIA B300, разрешение 832x480 при 24 FPS, чанк из 124 кадров длительностью около пяти секунд, стриминговый VAE-декод Sol-H3-VAE и доставка потока по WebRTC. Модель MiniMax H3 в этой конфигурации показала TTFF около 1,4 секунды, а в README репозитория приводится калибровочный scheduling lead 0,91 секунды для данного сетапа.
Контекст
Раньше задержка интерактивной генерации напрямую привязывалась к размеру чанка: нижняя граница ожидаемой задержки E[R+Q] >= T/2 задавалась самим чанком и заставляла выбирать между малым чанком ради отзывчивости и большим окном внимания ради качества картинки. Двунаправленным моделям для хорошего видео нужно именно большое окно, поэтому разработчикам приходилось чем-то жертвовать. Альтернативным маршрутом было пост-обучение в духе Self-Forcing, при котором модель заранее приучают к интерактивному режиму, но такой путь требует обучающего прогона. Speculative Sampling разрывает эту связку: задержка перестаёт зависеть от размера чанка, а окно внимания превращается из жёсткого ограничения в параметр настройки, который можно подбирать под конкретную задачу.
Почему это важно для индустрии
Интерактивные видеосистемы больше не обязаны жертвовать качеством ради малых чанков: существующие двунаправленные чекпоинты можно обслуживать в реальном времени без пост-обучения, то есть без доступа к обучающему пайплайну владельца модели. Инженерное внимание смещается с уменьшения чанка на ускорение сэмплирования внутри чанка, а сам метод композиционен и, судя по демо-пайплайну, складывается с few-step дистилляцией — демо уже работает на четырёхшаговом дистилированном чекпоинте. Это открывает дорогу интерактивным видео-приложениям, прежде всего играм и симуляциям, построенным на уже выпущенных чекпоинтах. Если подход подтвердится в независимых замерах, кэширование предсказаний с пересчётом хвоста может стать для интерактивного видео таким же стандартным слоем real-time инференса, каким speculative decoding стал для языковых моделей.
Почему это важно для пользователей
Повторить демо можно уже сейчас: в репозитории Yubo-Shankui/SpeculativeSampling под лицензией Apache 2.0 лежит код запуска h3_live_demo.py, чекпоинт FastVideo-FastH3-4-step-Preview-v1-Dense-DataFree доступен на Hugging Face, а для декодирования используется VAE StreamRender-H3. Главный практический порог — железо: валидированные цифры получены на стеке из восьми NVIDIA B300, без него заявленные показатели этим методом не гарантируются. Готовые сценарии дают две точки входа: свободное TI2V-взаимодействие и бой с боссом Margit из Elden Ring, а отдельный гайд обещает собрать собственную интерактивную игру примерно за пять минут. На проектной странице выложено демо-видео, по которому отзывчивость живого видео можно оценить ещё до чтения кода.
Что пока неизвестно / ограничения
Центральный тезис о том, что большое окно сохраняется без потери качества, в предоставленных материалах не подкреплён метриками: нет сравнений с малочанковыми базлайнами или пост-обучением в духе Self-Forcing — ни FVD, ни человеческих оценок, ни абляций по шумовому паддингу. Валидирован один чекпоинт, MiniMax H3, и одна конфигурация, 832x480 при 24 FPS, поэтому переносимость выводов на другие модели и разрешения не продемонстрирована. Интеграции для LTX и Wan авторы пока не рекомендуют использовать до завершения их настройки. Сегодня это self-hosted демо, а не продукт: независимых воспроизведений и замеров другими командами в материалах нет, и ожидания масштабирования метода зависят именно от такой проверки.
Источники
- Препринт Speculative Sampling in Interactive Video Generation (arXiv:2610.20556)
- Проектная страница Speculative Sampling с демо
- GitHub-репозиторий Yubo-Shankui/SpeculativeSampling
Автор
Look at AI, редакция