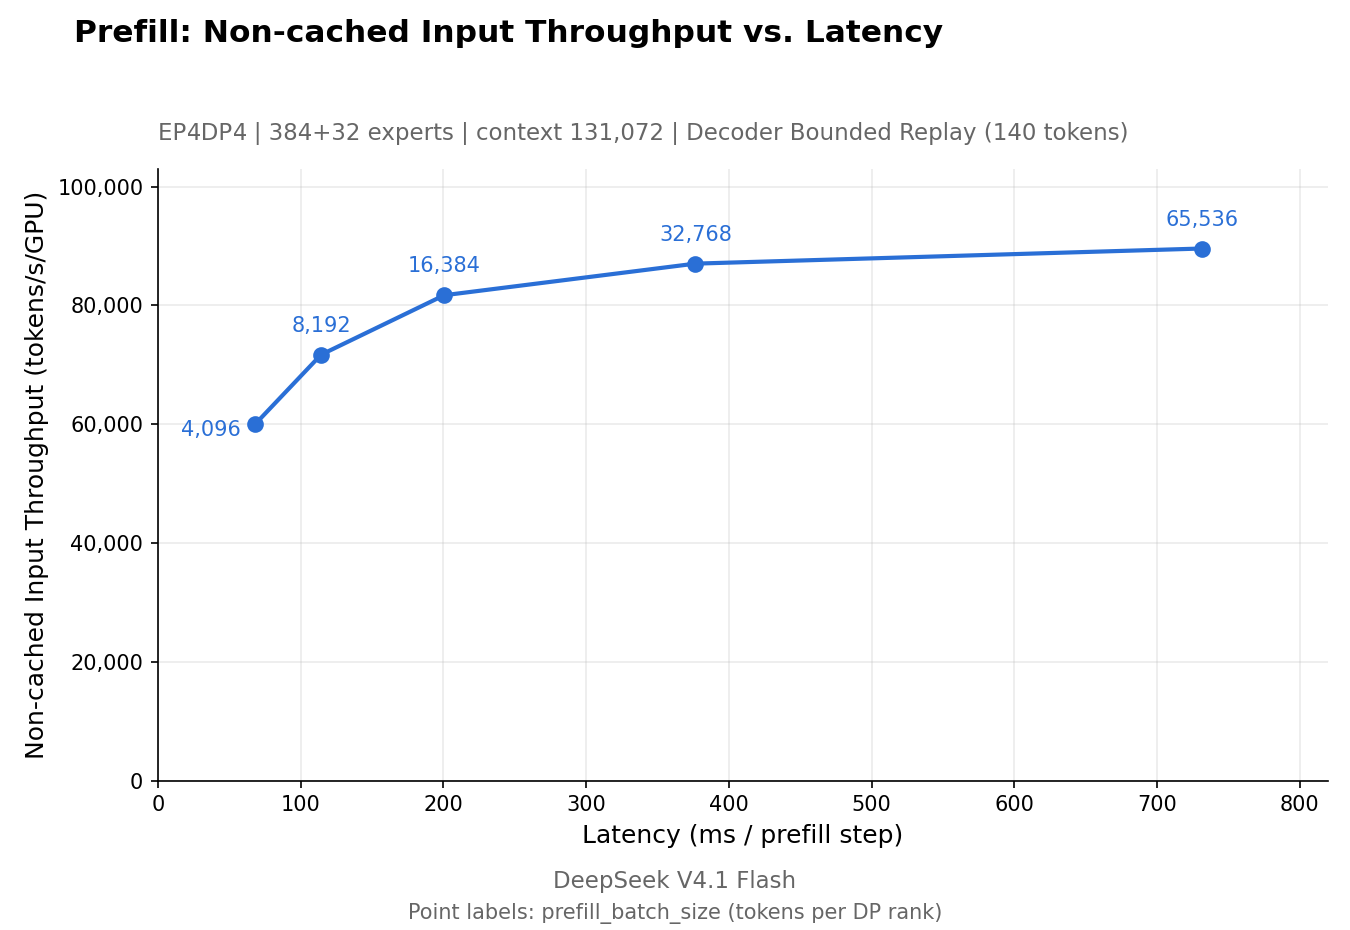
DeepSeek открыла исходный код DeepInfer — движка инференса, который работает в её продакшн-сервисах и обеспечивает работу модели DeepSeek-V4.1-Flash. Репозиторий github.com/deepseek-ai/DeepInfer опубликован 20 октября 2026 года под лицензией Apache 2.0 и поддерживает ускорители NVIDIA SM100 (Blackwell) и Huawei Ascend 950. Впервые лаборатория отдала сообществу не веса модели, а рабочий production-стек целиком: по данным компании, движок выдаёт до 155 триллионов токенов в день на кластер, время до первого токена около 400 мс и скорость генерации 230 токенов в секунду, хотя эти цифры пока не проверены независимыми бенчмарками.

Что произошло
20 октября 2026 года DeepSeek опубликовала репозиторий github.com/deepseek-ai/DeepInfer под лицензией Apache 2.0. Открыт не исследовательский прототип, а фреймворк инференса, работающий в продакшн-сервисах компании и обеспечивающий работу DeepSeek-V4.1-Flash; по умолчанию движок загружает с Hugging Face чекпоинт DeepSeek-V4.1-Flash-1017. В состав вошли оптимизированные ядра FlashMLA, DeepGEMM, DeepEP и TileKernels, схема параллелизма Attention DP и MoE EP с балансировщиком EPLB, спекулятивное декодирование DSpark, асинхронный планировщик и детерминированное сэмплирование. Поддерживаются ускорители NVIDIA SM100 (Blackwell) и Huawei Ascend 950. По собственным данным DeepSeek, фреймворк обеспечивает до 155 триллионов токенов в день на кластер, время до первого токена около 400 мс и скорость генерации 230 токенов в секунду — до 300 для кода. При этом в релиз не вошли KV-кэш, дисагрегация prefill/decode и балансировка нагрузки, а работает движок в режиме офлайн-инференса.
Контекст
Инференс — это этап, на котором уже обученная модель реально отвечает пользователям, и именно он формирует основную долю затрат на эксплуатацию крупной модели. Раньше лаборатории публиковали в основном веса, а serving-инфраструктуру держали закрытой: сторонние команды собирали свои стеки на универсальных движках вроде vLLM и SGLang и сами оптимизировали их под конкретные архитектуры. DeepInfer выделяется тем, что опубликован код, реально обслуживающий коммерческий сервис, поэтому заявления о производительности впервые переводятся из презентационной плоскости в потенциально проверяемую: одинаковый стек и веса доступны любой команде. Отдельные компоненты сообществу и раньше были известны по отдельности, поэтому научная новизна релиза умеренная: ценность в системной интеграции под архитектуры DeepSeek с миксом экспертов и MLA-стилем attention и в честно задокументированных ограничениях — это инженерный, а не исследовательский шаг.
Почему это важно для индустрии
Для отрасли это первый случай, когда DeepSeek открыла целиком production-стек инференса, а не только модель. Появляется независимая альтернатива vLLM и SGLang, заранее оптимизированная под архитектуры DeepSeek: глубокая системная интеграция вместо универсального фреймворка с ручным тюнингом. Для компаний, строящих продукты на DeepSeek-моделях, это прямой путь к снижению стоимости и энергозатрат крупномасштабного инференса, а для рынка — удар по защитным рвам провайдеров, чьё преимущество состояло именно в эффективном обслуживании моделей: порог входа для команд, самостоятельно хостящих большие MoE-модели, заметно падает. Поддержка Huawei Ascend 950 в официальном релизе наравне с NVIDIA SM100 — заметный шаг для китайской чип-экосистемы и сильный сигнал о переносимости стека за пределы одной вендорской платформы. В горизонте полугода вероятны первые независимые бенчмарки DeepInfer против vLLM и SGLang: если цифры подтвердятся хотя бы частично, движок может стать базовой точкой сравнения для DeepSeek-моделей и оказать давление на открытые serving-фреймворки в пользу глубокой оптимизации под конкретные архитектуры. Если на горизонте двух лет тренд открывать production-стеки закрепится, маржа чисто API-прокладок может сжаться, а ценность сместится к слоям памяти и RAG, оркестрации, пользовательскому интерфейсу и данным; возможна консолидация вокруг специализированных движков и рост роли не-NVIDIA ускорителей.
Почему это важно для пользователей
Разработчики могут прямо сейчас склонировать репозиторий и запустить DeepSeek-V4.1-Flash самостоятельно: потребуется Linux, Python 3.12 и либо CUDA 13 для NVIDIA SM100 (Blackwell), либо CANN 9.2 для Huawei Ascend 950, а чекпоинт DeepSeek-V4.1-Flash-1017 по умолчанию скачивается с Hugging Face. Практичный план первых шагов: зафиксировать собственный нагрузочный профиль — типичные длины контекста и уровень параллелизма запросов, затем прогнать бенчмарк против vLLM и SGLang и сопоставить свои замеры времени до первого токена и скорости генерации с цифрами DeepSeek. Отдельного изучения заслуживают спекулятивное декодирование DSpark, балансировка EPLB и детерминированное сэмплирование (batch-invariant inference): воспроизводимое независимо от состава батча поведение модели упрощает отладку, сравнение версий и аккуратные A/B-эксперименты. Тем, у кого нет подходящего железа, релиз всё равно полезен как эталон инженерных приёмов: оптимизированные ядра, асинхронный планировщик и схему параллелизма можно разбирать как учебник по высокопроизводительному инференсу.
Что пока неизвестно / ограничения
Заявленные DeepSeek показатели производительности пока не воспроизведены независимо: для их проверки нужны кластеры NVIDIA SM100 или Huawei Ascend 950, которых у большинства команд нет. Производительность под Huawei Ascend 950 с CANN 9.2 нельзя принимать на веру — требуются независимые замеры на реальных нагрузках, а не доверие к цифрам вендора. Функциональные рамки релиза уже задокументированы: поддерживаются только SM100 и Ascend 950, работает только офлайн-инференс, а KV-кэш, дисагрегация prefill/decode и балансировка нагрузки в него не вошли, так что для онлайн-сервиса с высоким параллелизмом пользователей движок в текущем виде не готов. Наконец, вывод о том, что инференс превращается в коммодити, из факта публикации репозитория технически не следует: это бизнес-гипотеза, которая потребует подтверждения независимыми бенчмарками и долгосрочной поддержкой проекта.
Источники
- DeepInfer: High-performance, large-scale inference framework for DeepSeek models (GitHub, deepseek-ai)
- DeepSeek open-sources DeepInfer, the inference engine behind its production models (Crypto Briefing)
- DeepInfer: DeepSeek open-sourced the inference framework behind V4.1-Flash (CloudNavi)
Автор
Look at AI, редакция