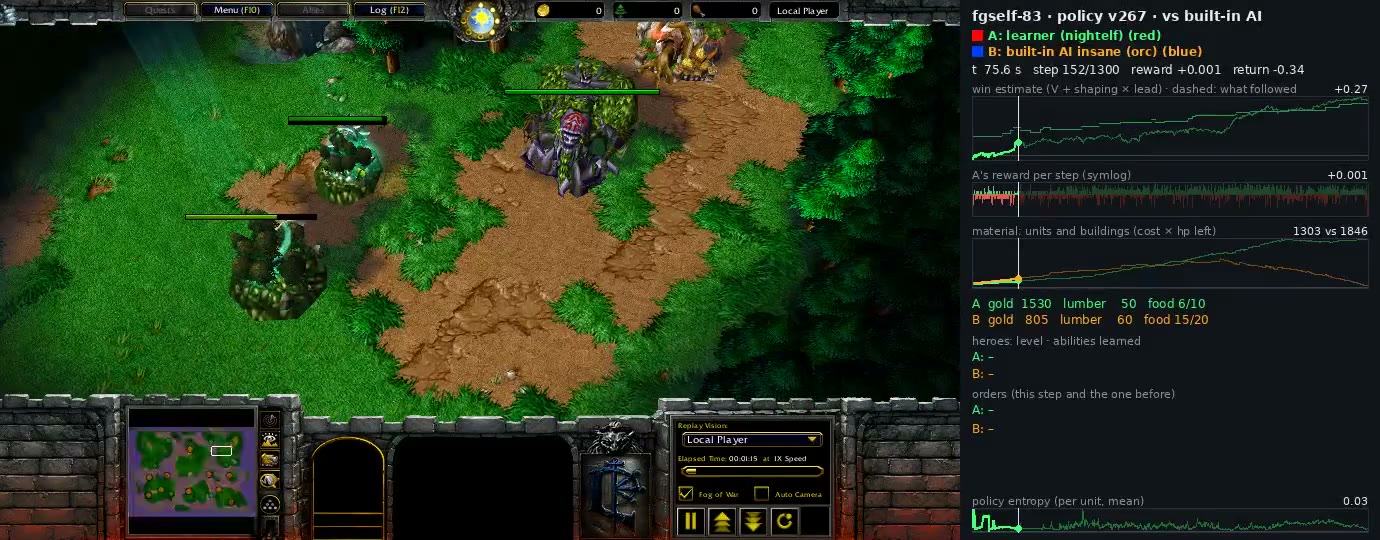
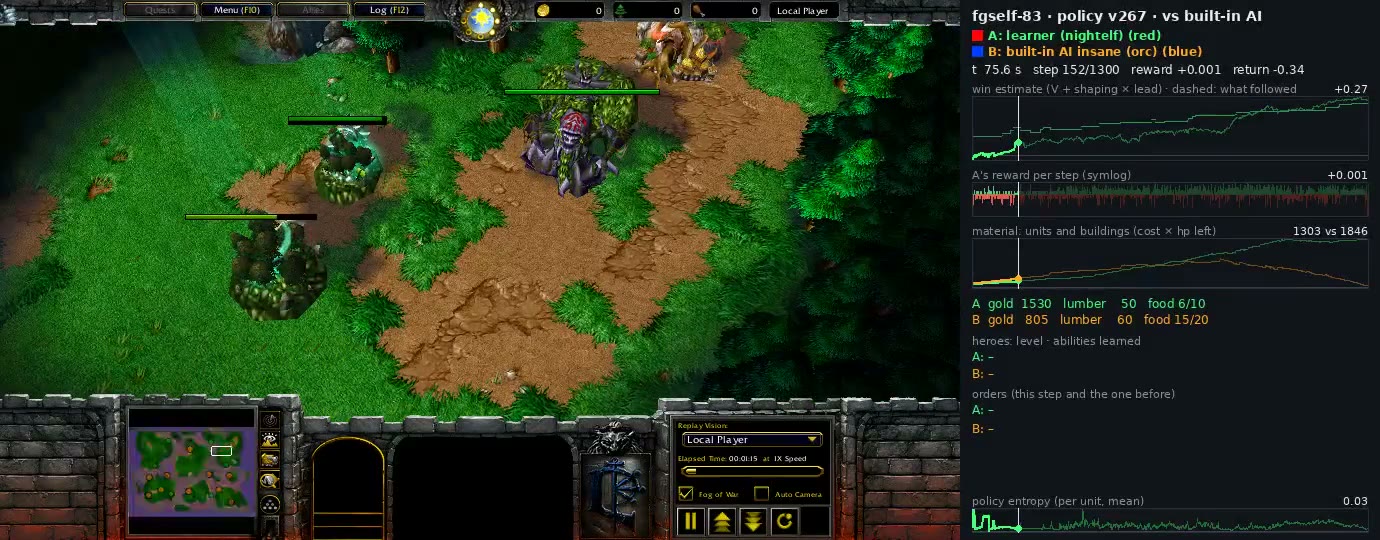
Инженер Robin Kahlow (Warlock.AI) обучил ИИ-агента играть в полную версию Warcraft III (патч 1.29) на классической карте Echo Isles против встроенного соперника уровня Insane и добился 89% побед за три недели. Обучение велось методом self-play reinforcement learning на обычном настольном ПК, а код и логи эксперимента автор выложил в открытый доступ.
Что произошло
Агента обучали прямо поверх немодифицированного 32-битного Windows-клиента Warcraft III, который запускался под Wine на Linux. Около 50 параллельных инстансов игры управлялись из Python через самописный w3shim.dll: библиотека подменяет игровые часы виртуальными, поэтому игра выполняется быстрее, чем разрешает процессор, и на каждом шаге ждёт команду агента. Нейросеть — Transformer из 5 слоёв с памятью minGRU и примерно 3,2 млн весов — за время обучения сыграла 840 000 партий, что эквивалентно примерно 11 годам геймплея, при этом за каждый час реального времени генерировалось около 730 игровых часов. Инференс занимает около 13 мс на шаг всего на четырёх CPU-ядрах, то есть обученный агент способен играть в реальном времени на обычном компьютере.
Контекст
Агенты для сложных стратегий в реальном времени до сих пор считались продуктом крупных лабораторий: AlphaStar от DeepMind в StarCraft II и OpenAI Five в Dota 2 опирались на дата-центры, API игровых движков и большие лиги обучаемых ботов. В проекте warcraftsim нет алгоритмической новизны — методика компилирует приёмы, отработанные в AlphaStar: behavioral cloning встроенного ИИ как стартовая политика, self-play лига с прошлыми версиями агента, adaptive tax для удержания win rate около 50%, credit assignment по схеме UPGO и целевой build order на входе сети. Главной удачей здесь стал harness, а не алгоритм: он превратил закрытый игровой бинарник в быструю step-based среду, пригодную для современного reinforcement learning.
Почему это важно для индустрии
Для индустрии сигнал в цене достижения: полноценный self-play RL для RTS показал рабочий результат без API игры, headless-режима и дата-центра, причём среда была быстрой, а задача — узкой. Порог входа в добротный RL-эксперимент сдвинулся с кластера к одному ПК, что важно для небольших команд и стартапов, у которых нет дата-центров. Главную продуктовую ценность представляет открытый harness: связка виртуальных часов, параллельных инстансов под Wine и Python-управления переносима на другие игры и симуляции с «чёрным ящиком» вместо окружения, включая автоматизацию и тестирование desktop-приложений без API. В ближайшие месяцы вероятны форки harness под другие legacy-среды и первые независимые прогоны, которые либо подтвердят, либо скорректируют цифры автора.
Почему это важно для пользователей
Проект полностью открыт: код, документация и лог экспериментов лежат на github.com/RobinKa/warcraftsim, поэтому любой желающий может склонировать репозиторий, запустить агента или дообучить его на своём железе с ПК уровня RTX 3090 под Linux и Wine. Внутри можно разобрать устройство harness — w3shim.dll, JASS-хук и CUDA graphs на C++, — а приём с виртуальными часами и параллельными инстансами под Wine переносим на другие legacy-приложения без доступа к чужому коду. Для тех, кто изучает reinforcement learning, это готовый учебный пример полного цикла — от среды до инференса — внутри одного репозитория.
Что пока неизвестно / ограничения
Цифры автора о win rate, скорости инференса и ускорении среды пока не прошли независимой репликации и peer-review. Соперником выступает скриптовый встроенный бот, а не сильные игроки, а проверенная ценность ограничена одной картой Echo Isles, патчем 1.29 и скромной сетью: сопоставим рецепт и инженерия, но не масштаб лиг AlphaStar-эры. Обобщение за пределы этого сценария не показано, поэтому работу стоит трактовать как доказательство возможности дешёвого self-play в узкой задаче, а не как универсальный результат для любых игр и сред.
Источники
- Блог Warlock.AI (Robin Kahlow): Beating Warcraft III's insane AI with self-play reinforcement learning on one desktop
- GitHub-репозиторий RobinKa/warcraftsim — код, документация и лог экспериментов
- Обсуждение проекта на Hacker News
Автор
Look at AI, редакция