Perplexity представила Photon — поисковый движок на Rust, который находит и ранжирует веб-страницы до того, как языковая модель соберёт по ним ответ, и выпустила на его основе режим Fast Search в Search API. Быстрый режим обходится в пять раз дешевле стандартного веб-поиска и отвечает почти так же качественно: на агентных бенчмарках разница с обычным режимом измеряется долями процента, хотя внутренние метрики релевантности немного просели. Включается он одним параметром API, поэтому удешевить поисковый шаг в собственном агенте можно уже сейчас.

Что произошло
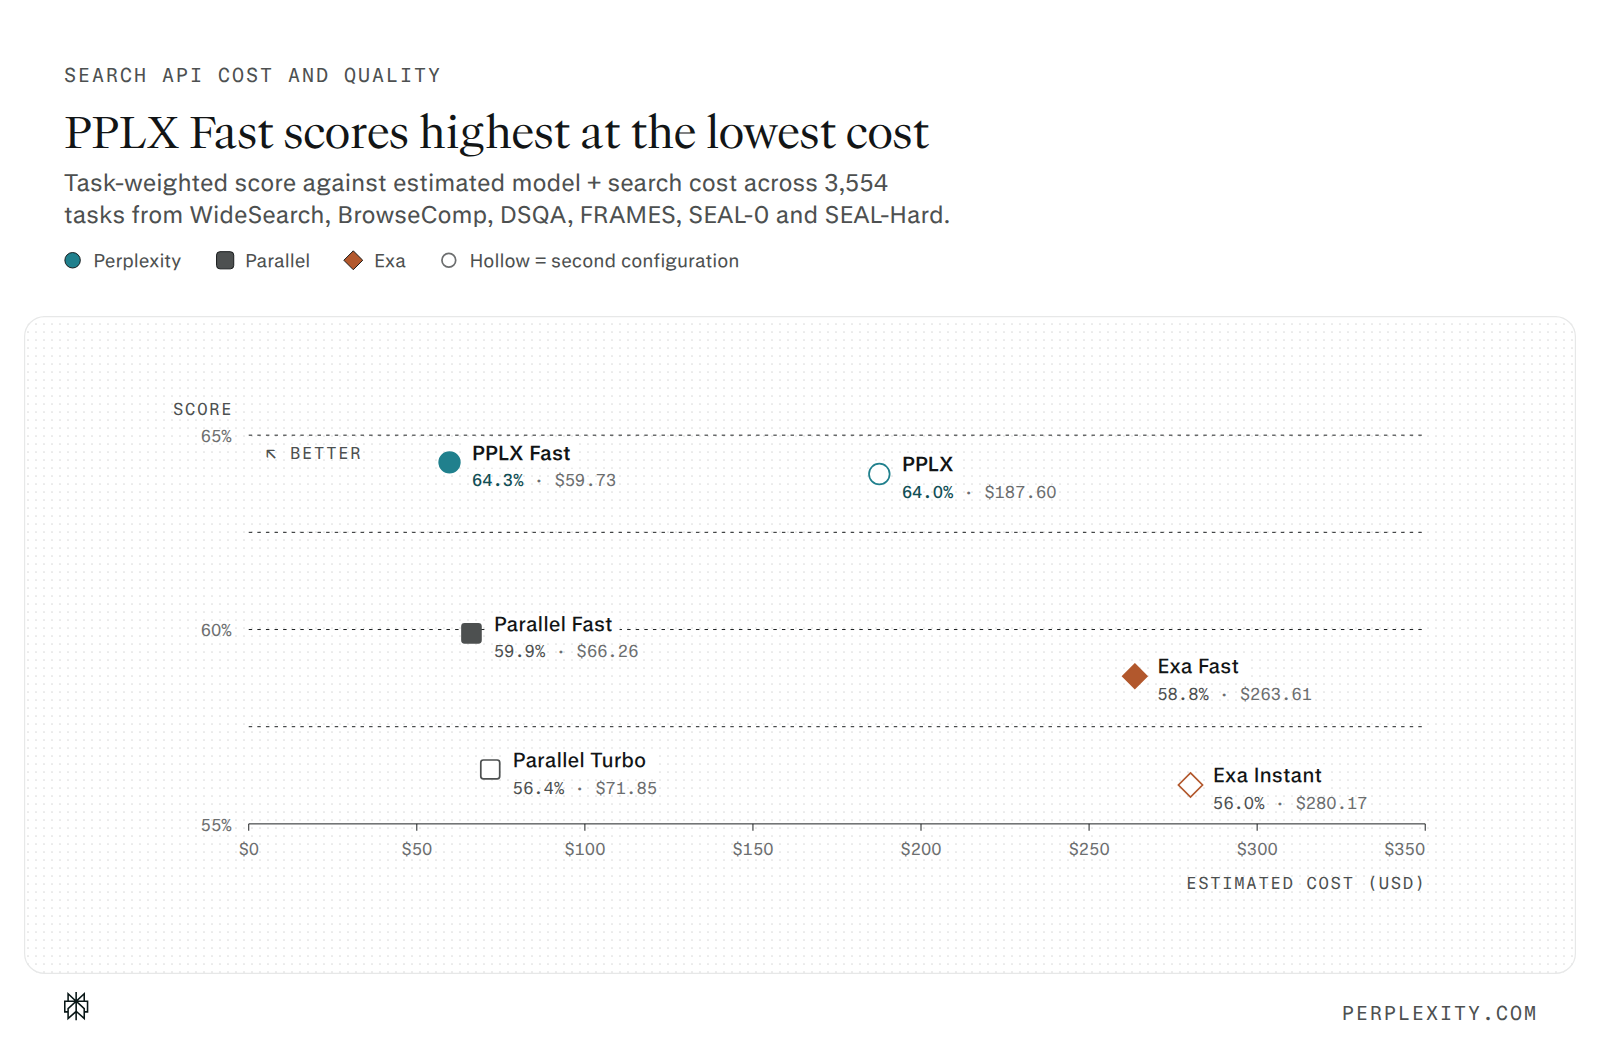
Perplexity сообщила о создании Photon — нового поискового движка на Rust, который подбирает и ранжирует веб-страницы на этапе, предшествующем генерации ответа языковой моделью. На его основе в Search API открыт режим Fast Search: он включается значением search_type: "fast" и стоит $1.00 за 1000 запросов против $5.00 за стандартный веб-поиск. По данным компании, 95% результатов возвращается за 230 мс или быстрее при медиане 160 мс. На шести агентных бенчмарках — WideSearch, BrowseComp, DSQA, FRAMES, SEAL-0 и SEAL-Hard — быстрый режим набрал 64,3% против 64,0% у стандартного при оценочной стоимости $59,73 против $187,60. Одновременно Perplexity опубликовала внутренние тесты релевантности, где показатели снизились: DCG опустился с 2,45 до 2,21, а доля запросов, для которых ответ нашёлся среди отобранных страниц, — с 59,6% до 56,7%.
Контекст
Photon примечателен не научной новизной, а инженерной сборкой: Perplexity упаковала классический арсенал информационного поиска — инвертированный индекс со сжатием Elias-Fano, двухэтапное ранжирование, WAND-обход, асинхронное чтение, кэш CLOCK и сборку индекса через MapReduce — в дешёвый и быстрый режим публичного API. Индекс движка хранит примерно в 2,5 раза больше данных на документ, но требует примерно на 20% меньше серверов, а задержка 99-го перцентиля внутри Photon, по опубликованным цифрам, снизилась примерно с 800 до 65 мс. Для понимания события важно, что все эти механизмы — стандартный инструментарий классического IR, который теперь снова работает как базовый слой LLM-систем. К фону относится и редкая для продуктовых релизов практика прозрачности: вместе с бенчмарками компания выложила внутренние метрики релевантности с ухудшением.
Почему это важно для индустрии
Для индустрии главный эффект касается экономики retrieval-слоя. Заявленное ценообразование переводит веб-retrieval из числа главных стоимостных статей агентного пайплайна в дешёвую инфраструктуру и заметно опускает порог входа для стартапов с поисковыми агентами. Объявленные задержки позволяют прогонять в интерактивных циклах агента больше поисковых шагов без потери отзывчивости. Анонс задаёт и конкурентный ориентир: если цифры подтвердятся в реальных пайплайнах, другим поисковым API придётся отвечать ценой и латентностью, а деление на режимы «быстро и дёшево» и «максимально качественно» может стать типовым интерфейсом отрасли. Вероятный рабочий паттерн — двухуровневый retrieval, где fast обслуживает горячий путь и fan-out, а обычный веб-поиск остаётся за глубокими research-сценариями, с классификатором, выбирающим режим по сложности запроса. В горизонте двух лет retrieval-слой движется к коммодитизации: конкуренция смещается к свежести индекса, покрытию данных и качеству ранжирования под конкретные агентные сценарии, а ценность уходит выше — к доменному ранжированию, памяти агента, оркестрации и продуктовому слою.
Почему это важно для пользователей
Тем, кто строит агентов на Perplexity Search API, быстрый режим уже доступен: достаточно передать параметр search_type: "fast"; в Python SDK версий 0.43.4 и 0.43.5 он задаётся через extra_body, а max_results принимает значения от 1 до 20. Горячий путь агента можно перевести на fast уже сегодня и снизить расходы на поисковые вызовы, оставив обычный веб-поиск для сложных вопросов, где важна максимальная релевантность выдачи. Разумный первый шаг — прогнать оба режима в shadow-тесте или A/B-эксперименте на собственном трафике: сверить релевантность на выборке реальных запросов и замерить фактическую экономию, а не полагаться только на цифры из анонса.
Что пока неизвестно / ограничения
Разница в 64,3% против 64,0% на шести бенчмарках невелика и может укладываться в границы, которые способен дать обычный шум измерений. В опубликованных материалах нет числа прогонов, доверительных интервалов и разбивки результатов по каждому из шести агентных бенчмарков, поэтому неизвестно, где именно fast-режим выигрывает, а где проигрывает. Все ключевые цифры приведены самим вендором: независимой репродукции пока нет, и раскрытие внутренних метрик с ухудшением, само по себе хороший сигнал прозрачности, её не заменяет. Не раскрыто и то, на каких типах запросов и доменах просадка DCG и покрытия запросов ответом проявляется сильнее.
Источники
- Introducing Fast Search in the Perplexity Search API — Perplexity API Platform Forum
- Fast Search — Perplexity Search API Documentation
Автор
Look at AI, редакция