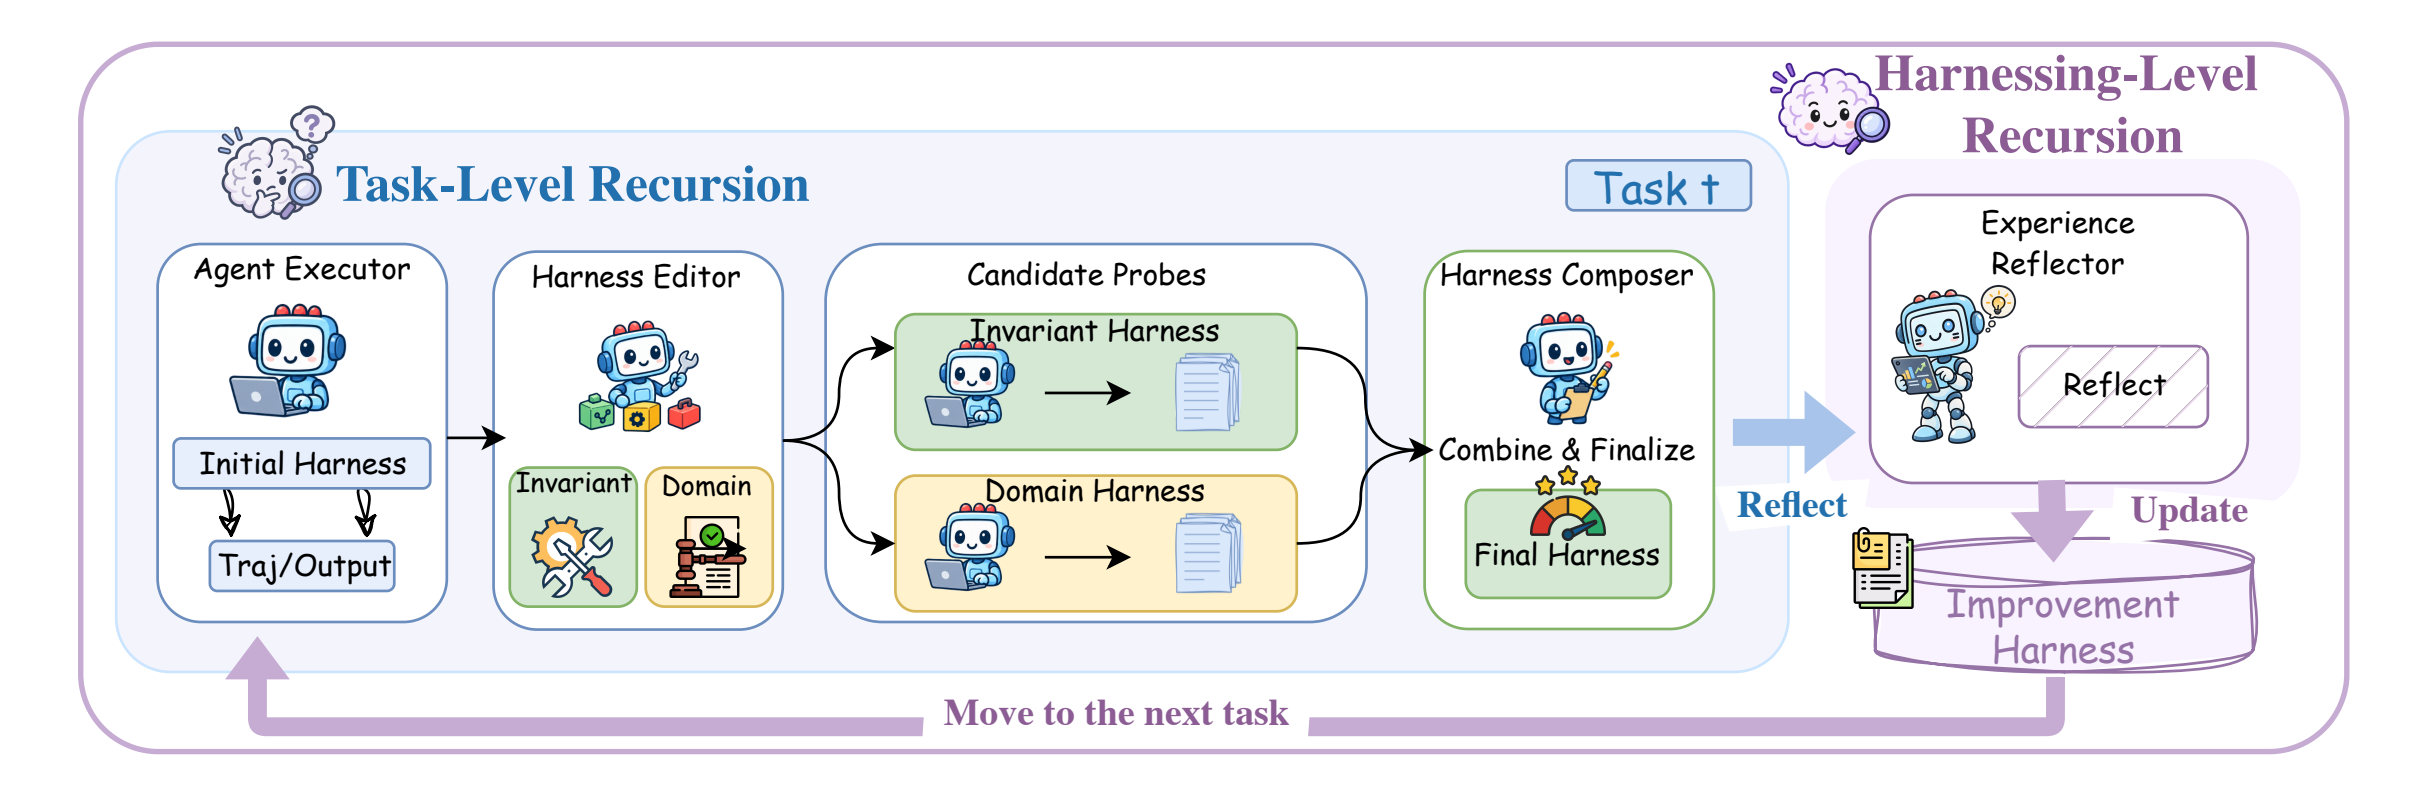
Google Research открыла Harness² — фреймворк, который рекурсивно улучшает окружение ИИ-агента: от системного промпта и guardrails до памяти, tool guidance, субагентов, skills, скриптов и плагинов. Веса модели при этом не трогаются: механизм Propose–Probe–Compose подбирает правки по контрастам поведения запусков и не требует заранее известного правильного ответа или внешнего проверяющего. В опубликованных тестах с Gemini 3.5 Flash и GLM-5 один шаг оптимизации дал заметные приросты на бенчмарках WorkBuddy-Bench, JobBench и LAB. Проект распространяется под Apache 2.0, запускается локально без API-ключей, а код и документация размещены на GitHub.


Что произошло
Google Research выложила фреймворк Harness² в открытый доступ на GitHub в репозитории google-research/harness2. Он оптимизирует восемь компонентов окружения агента: системный промпт, guardrails, память, tool guidance, субагентов, skills, скрипты и плагины. Цикл Propose–Probe–Compose устроен так: система предлагает правки конфигурации, пробует несколько вариантов на одной и той же задаче и собирает улучшенную конфигурацию, сопоставляя, как вели себя разные запуски. Второй уровень рекурсии сохраняет принятую конфигурацию и подтверждённые запусками выводы для будущих задач. Поддерживаются параллельная и последовательная рекурсия, а также исполнители OpenCode и Codex. В тестах с Gemini 3.5 Flash и GLM-5 один шаг улучшения дал до 11,5 балла на WorkBuddy-Bench, 4,5 балла на JobBench и 11,8 п.п. по partial pass rate на LAB; дополнительные итерации повышали результат.
Контекст
Под «harness» подразумевается всё, что окружает модель и определяет, как агент работает на задаче: системный промпт, guardrails, память, tool guidance, субагенты, skills, скрипты и плагины. Исторически качество агентов поднимали обучением и масштабированием самих моделей либо ручной настройкой этих элементов; Harness² превращает окружение в автоматически настраиваемый артефакт и рассматривает «умение агента» как отдельную от «умения модели» ось улучшений. Принципиально, что метод не требует заранее известного правильного ответа: вместо сверки с эталоном система фиксирует улучшение на уровне наблюдаемого поведения и собирает конфигурацию из поведенческих контрастов запусков. Статья с описанием подхода опубликована на arXiv (arXiv:2610.14224), а бенчмарки JobBench, LAB и WorkBuddy-Bench, на которых отчитываются авторы, задокументированы в материалах проекта.
Почему это важно для индустрии
Для индустрии главный вывод: производительность агента можно заметно поднять, оптимизируя не веса модели, а её окружение, и это дешевле дообучения. Метод воспроизводим и оформлен плагинно, поэтому встраивается в существующие агентные пайплайны без модификации модели; снижается стоимость адаптации под новые профессиональные сферы — офис, web, код, юриспруденцию. Если подход подтвердится у сторонних команд, преимущество вроде «мы хорошо настроили промпты и инструменты» обесценится, ведь окружение сможет настраиваться автоматически, а защищаемым активом станет не конфигурация, а поток реальных задач и накопленные, подтверждённые запусками выводы, которые сохраняет второй уровень рекурсии. Для команд, работающих с закрытыми моделями без доступа к весам, автотюнинг окружения может стать основным способом адаптации. Прогноз на перспективу: подбор harness-конфигурации способен стать штатным этапом жизненного цикла агентных систем — аналогом CI для промптов и eval-прогонов, с реестром конфигураций, автоматическими прогонами и откатом регрессий.
Почему это важно для пользователей
Фреймворк можно поставить и проверить на своём оборудовании: запуск описан для Linux с Python 3.12 и менеджером uv, демо работает без API-ключей, поэтому стоимость эксперимента почти нулевая. Практический сценарий — склонировать репозиторий google-research/harness2, прогнать его на собственных типовых задачах и сравнить результат с текущей конфигурацией агента; интеграции с OpenCode и Codex позволяют делать это на уже знакомых исполнителях. Материалы проекта включают видео-обзор, документацию по бенчмаркам и статью arXiv:2610.14224 для глубокого знакомства. Это конкретный работающий пример того, как «агент сам настраивает свою рабочую среду», а не рассуждение об этой идее. Важная оговорка для практики: для юридической, финансовой и safety-critical работы результаты таких улучшений нужно дополнительно проверять независимо.
Что пока неизвестно / ограничения
Цифры вида «до 11,5 балла» описывают лучший случай, а не среднее по задачам: распределение приростов, разброс между повторными запусками и доверительные интервалы в открытых материалах не раскрыты, поэтому реальный эффект может быть заметно ниже максимума. Приросты измерены на собственных бенчмарках авторов и пока не подтверждены независимыми репликациями; ключевой открытый вопрос — переносится ли подобранная конфигурация на задачи, не участвовавшие в оптимизации. Для production-использования нет опубликованных данных о latency и стоимости probe-запусков, поэтому встраивать фреймворк в рабочие пайплайны сейчас рано. Авторы сами подчёркивают, что контрастное улучшение не гарантирует фактической корректности результата: сигнал в этом методе слабый и опирается на поведение запусков, а не на сверку с эталоном.
Источники
- google-research/harness2 (GitHub)
- Harness^2: Recursive Agent Harnessing for an Open World (arXiv:2610.14224)
- Google Research Harness²: Recursive AI Agent Improvement (Data Studios)
Автор
Look at AI, редакция