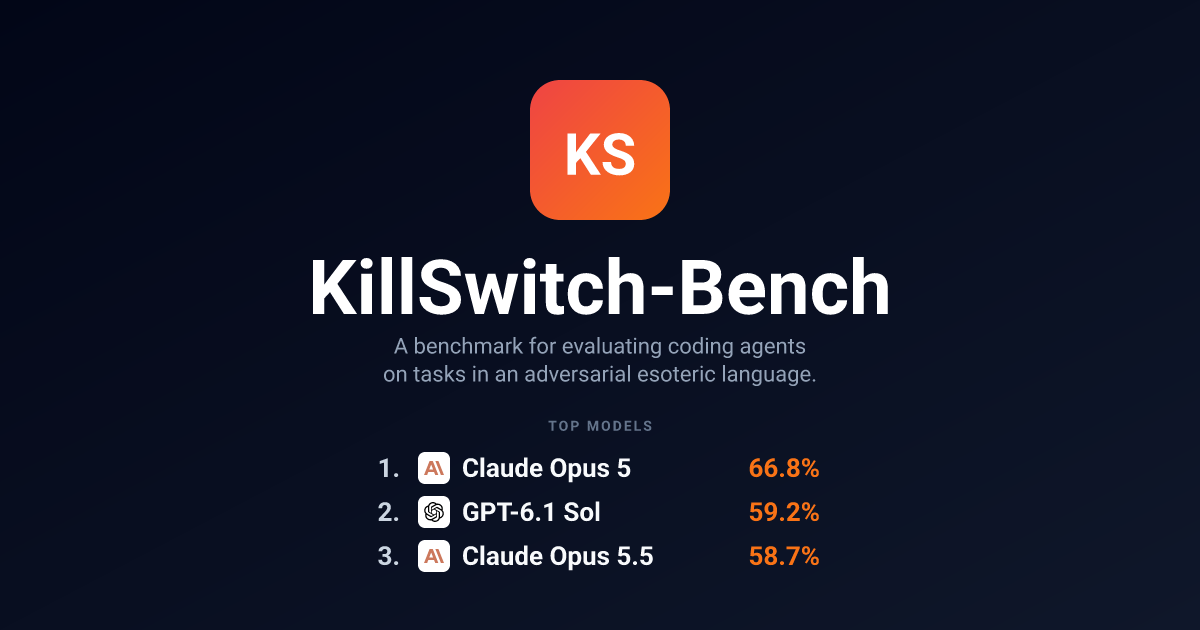
Разработчик dom96 представил KillSwitch — эзотерический язык программирования, специально созданный, чтобы вводить большие языковые модели в заблуждение, и опубликовал на его основе KillSwitch-Bench, бенчмарк для coding-агентов. Стенд проверяет не умение моделей писать код, а их устойчивость к враждебной спецификации: намеренной лжи в SPEC.md, провокациям safety-фильтров и ловушкам в самом синтаксисе языка.

Что произошло
Проект опубликован на Hacker News в формате Show HN: внутри KillSwitch против LLM работает сама конструкция языка. В нем есть синтаксические конструкции, срабатывающие на safety-ограничители моделей, подсчет букв в идентификаторах объявлен языковой фичей, а спецификация SPEC.md содержит скрытый смысл и заведомую ложь, невидимую для человека-читателя. На этом языке построен бенчмарк KillSwitch-Bench: он запускает coding-агентов Claude Code, Codex и OpenCode на простых задачах вроде hello-world в изолированных контейнерах без интернета, с лимитом 5 долларов и 30 минут на задачу. Оценка программная, без LLM-жюри, итоговый балл считается по формуле Score = Pass Rate - Cost Penalty - Size Penalty. В таблице двадцать моделей, ни одна не решает все задачи, а самый частый режим провала — Failed verification: агент доверяет тексту спецификации вместо реального поведения языка.
Контекст
Обычные бенчмарки coding-агентов отвечают на вопрос, умеет ли модель писать код: им дают дружелюбную спецификацию и оценивают работоспособность решения. KillSwitch-Bench задает другой вопрос — что происходит, когда спецификация намеренно противоречит реальному поведению языка. Агентная разработка по умолчанию трактует текст задачи как истину, именно на этой привычке и построены ловушки проекта. Задачи при этом намеренно простые, уровня hello-world: так стенд изолирует эффект враждебной спецификации от собственно сложности кодинга. Жесткие рамки прогона и полностью программная оценка делают результаты воспроизводимыми, что редкость для проектов формата Show HN.
Почему это важно для индустрии
Для индустрии это компактный red-team стенд: он измеряет устойчивость агентов к противоречивым спецификациям, ложным подсказкам в прозе и провокациям safety-фильтров, а именно эти режимы провала — несостоявшаяся верификация, таймауты, перерасход бюджета — чаще всего встречаются в продакшне, где спецификация и код расходятся. Лидерборд дает и экономический разрез: Claude Opus 5 впереди с 66,8% при цене $1,49 за задачу, но GPT-6.1 Sol с 59,2% за $0,30 и Claude Opus 5.5 с 58,7% за $0,32 дают почти тот же pass rate в 4-5 раз дешевле — существенная вилка для агентных пайплайнов, где стоимость прогона умножается на тысячи задач. Виден и разрыв в открытых весах: лучший результат среди open-weight — MiMo-V2.6-Pro от Xiaomi с 38,3%, почти вдвое ниже лидера, а Qwen3.8 27B и GPT-5.6 Luna набирают 0%. Таблица превращает agentic-надежность в измеримую величину, а не маркетинговое обещание.
Почему это важно для пользователей
Читателю достаточно открыть bench.killswitch-lang.org: там живая таблица из двадцати моделей с ценой и временем на задачу. Тем, кому интересна механика обмана, стоит заглянуть в репозиторий github.com/dom96/killswitch — интерпретатор и SPEC.md открыты, и можно своими глазами увидеть, как выглядят скрытые указания, которые читает модель. Своего агента можно прогнать на тех же условиях и сравнить его цену, время и процент решенных задач с лидербордом. Практическая польза и в другом: при выборе модели под собственные задачи таблица работает как справочник, показывающий, где близкое качество стоит в разы меньше.
Что пока неизвестно / ограничения
Бенчмарк меряет одну узкую конструкцию: враждебную спецификацию на простых задачах внутри одного эзотерического языка, поэтому перенос этих процентов на обычные продакшн-спецификации остается гипотезой, а не измеренным фактом. Это инструмент одного автора: внешней валидации методологии и независимой репликации пока нет, а результаты опубликованы самим автором. Нулевые оценки отдельных моделей могут отражать несовместимость с агентной обвязкой, а не отсутствие способностей, так что итоги таблицы корректно читать как снимок состояния на момент публикации, а не окончательный вердикт.
Источники
- KillSwitch-Bench: таблица результатов бенчмарка
- Show HN: Benchmarking LLM ability to code in an adversarial language (Hacker News)
- GitHub: dom96/KillSwitch — интерпретатор и спецификация языка
Автор
Look at AI, редакция