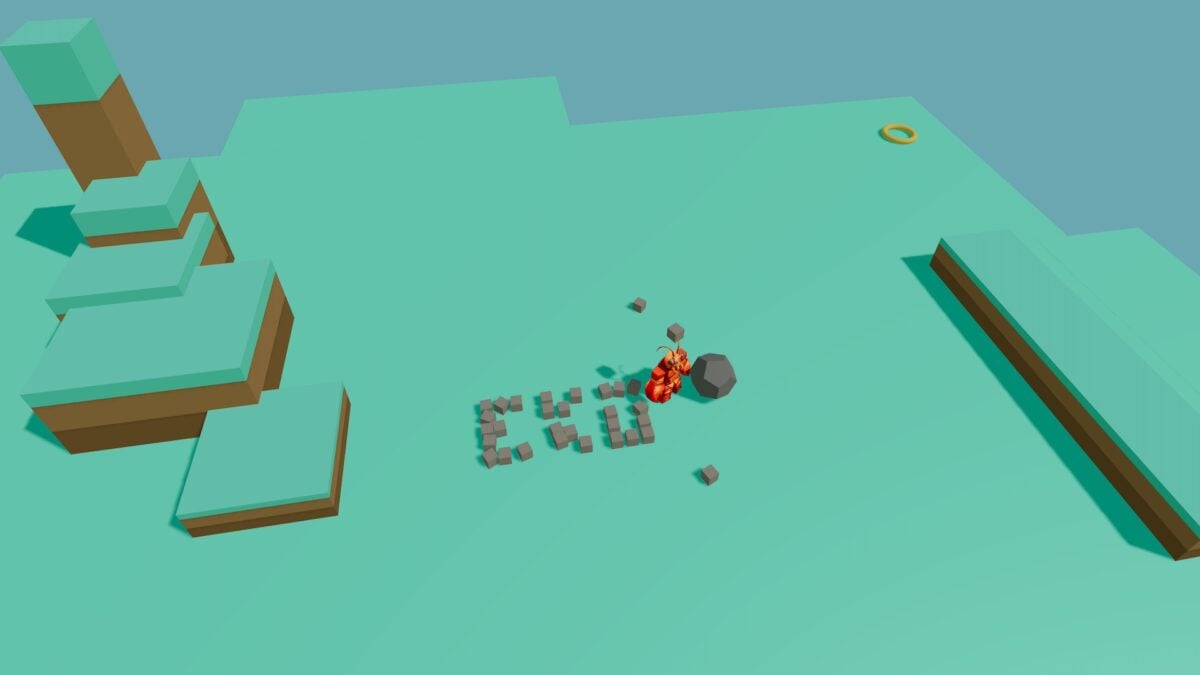
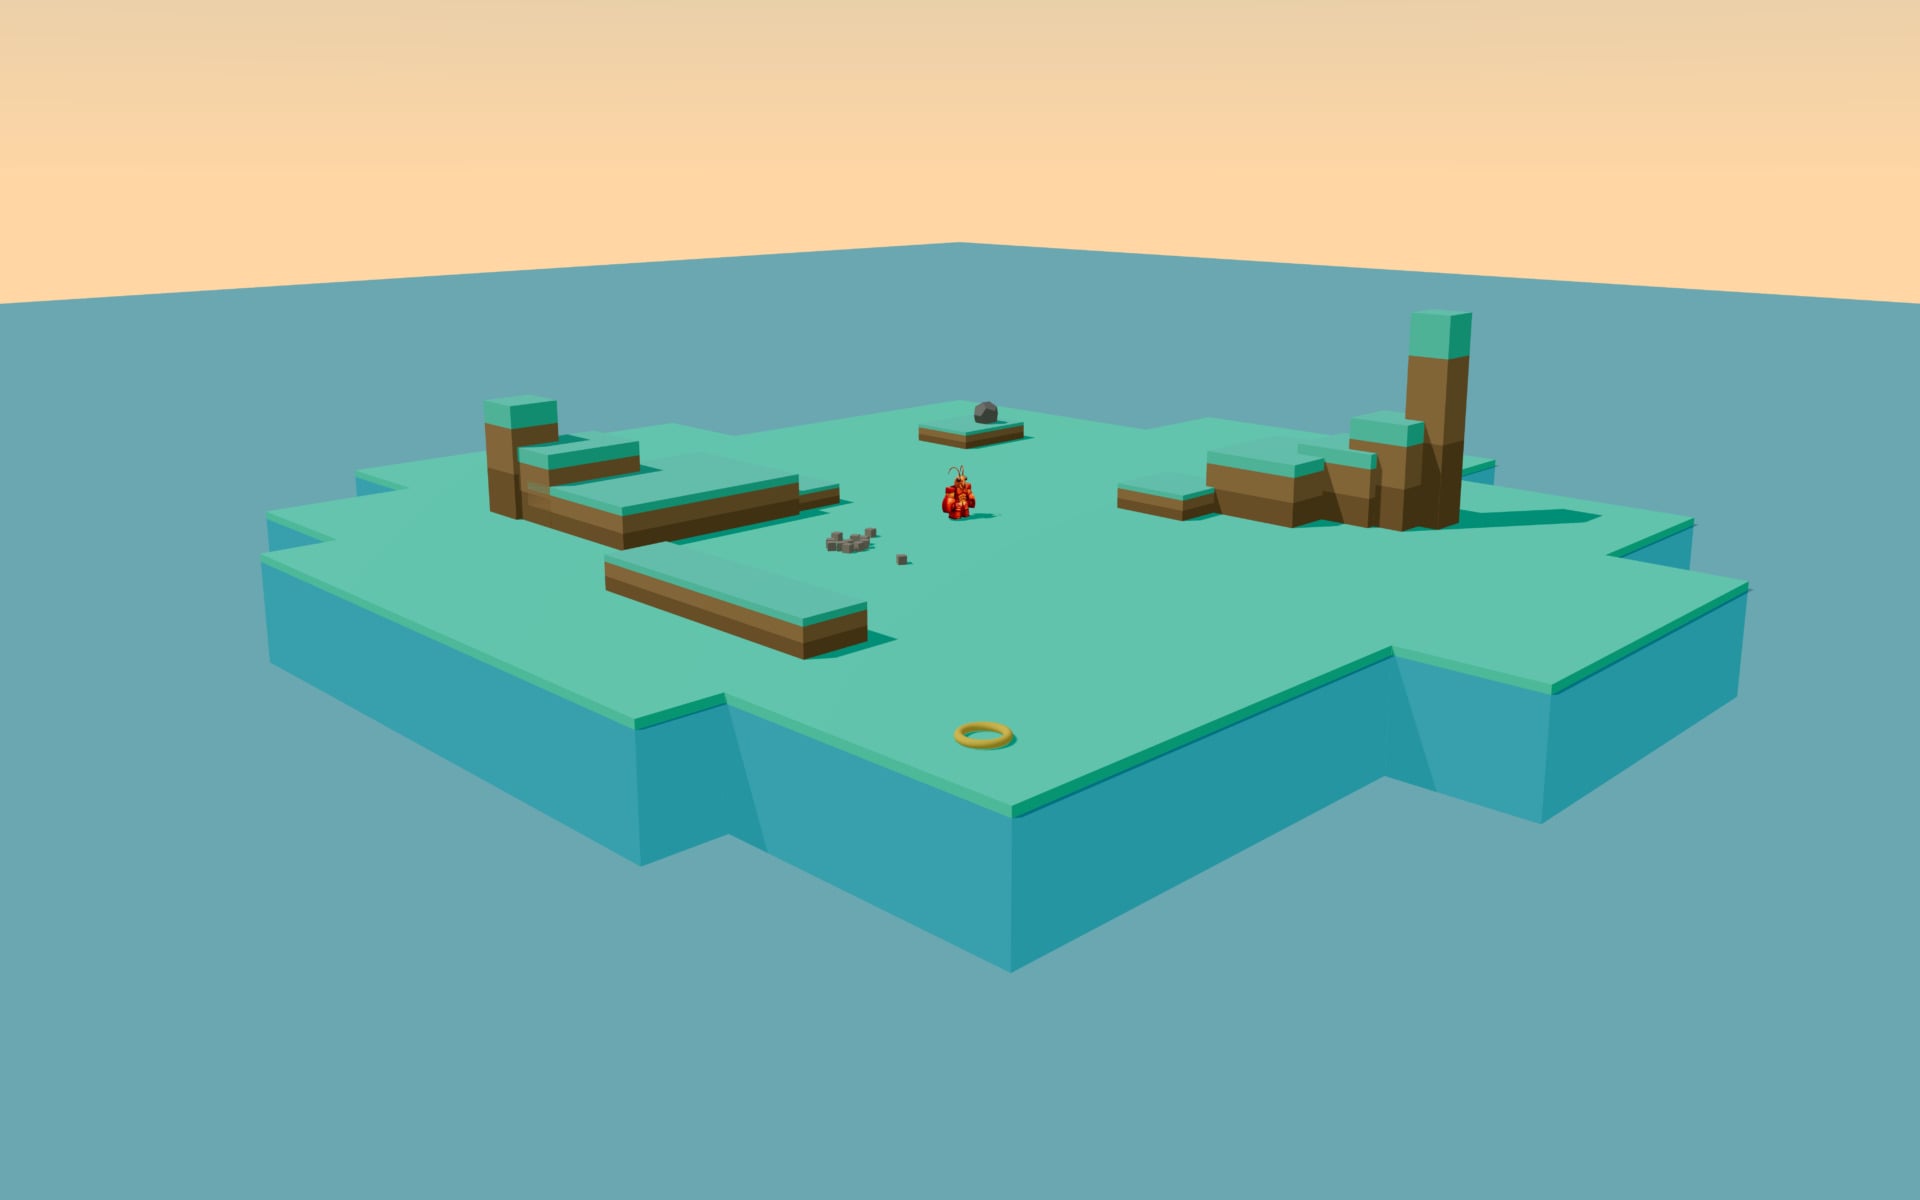
Команда MIT CSAIL подключила LLM-агента-кодера как «разум» к виртуальному телу и высадила его на цифровой остров — без задач, наград и предписанной активности. Оставленный сам по себе агент не простаивал: он спонтанно порождал структурированную, повторяющуюся с вариациями активность, похожую на игру, и накапливал знания о мире. В статье «Is this machine playing?» авторы проверяют, соответствует ли такое поведение классическим критериям игры, и обсуждают, может ли игра стать режимом развития машин.
Что произошло
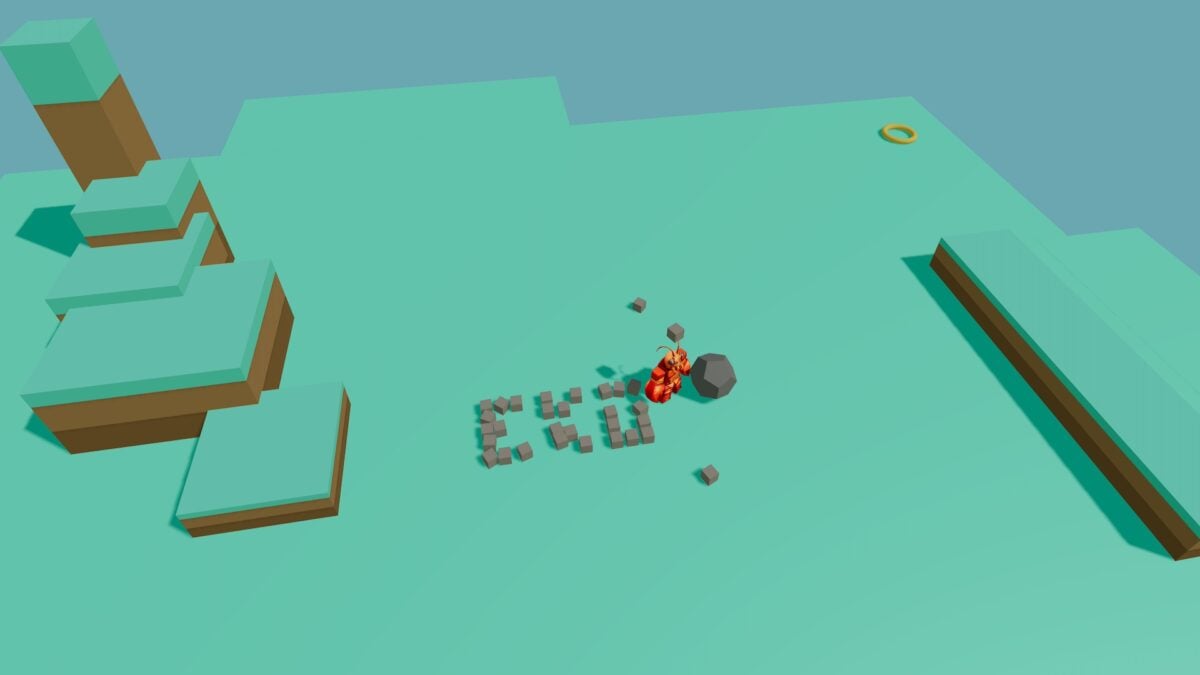
Статья «Is this machine playing?» (arXiv:2610.07130) опубликована 5 октября 2026 года. Её авторы — Нэтан Клус, Антонио Норелли, Даниэль Дурбин, Джейкоб Андреас, Даниэла Рус и Филлип Изола из MIT CSAIL. Схема эксперимента лаконична: LLM-агента-кодера подключили как «разум» к виртуальному телу, высадили его на цифровой остров и выдали минимальную инструкцию — без задач, наград и предписанной активности. В 30-часовых сессиях 13 агентов с прозвищем Eko взбирались на холмы, складывали блоки в башни, рисовали мандалы, возводили монумент в духе Стоунхенджа, строили храмы и играли в боулинг и баскетбол. Помимо декоративных построек агенты проводили собственные эксперименты по физике мира: в частности, они обнаружили, что блок, брошенный в прыжке, летит дальше. Об исследовании 15 октября 2026 года рассказал Gizmodo в статье Вэбба Райта.
Контекст
Привычный способ создания агентов — задача и награда: человек формулирует цель, система получает подкрепление за её выполнение, а прогресс измеряется метриками. Эксперимент MIT CSAIL устраивает противоположное: из петли убирают и цель, и награду, оставляя агенту только богатую и безопасную среду, в которой исследование ничего не ломает. Теоретическим референсом служит классическое представление об игре как о поведении, которое структурировано, воспроизводится с вариациями и мотивировано само по себе, а не внешним стимулом; именно на соответствие этим критериям проверялись действия агентов. Существенно и то, кто авторы: Джейкоб Андреас, Даниэла Рус и Филлип Изола — известные исследователи MIT CSAIL, поэтому работу корректно читать как аккуратный exploratory-эксперимент сильной группы, а не как заявление о прорыве в возможностях моделей. Авторы выдвигают гипотезу, что игра могла бы стать ещё одним режимом развития машин — не заменой обучения на задачах и reinforcement learning, а дополнением к ним.
Почему это важно для индустрии
Для отрасли здесь эмпирический сигнал, а не готовая технология: агент, помещённый в безопасную среду без целей и наград, сам находит закономерности мира, которые разработчики не закладывали, то есть ведёт себя как ненадзорный сборщик модели мира. Из этого намечается направление развития агентных пайплайнов: сессии свободного исследования в песочнице как отдельная стадия рядом с обучением на задачах и RL, которая пополняла бы память и модель мира агента перед рабочими задачами. Такой сдвиг реален только в двухлетнем горизонте и только при подтверждении повторяемости и появлении количественных метрик. Продуктозрелого в работе сейчас нет: в источниках нет API, цен и замеров задержки, поэтому интегрировать нечего. Реалистичная первая реакция компаний — дешёвый внутренний пилот по мотивам статьи: LLM-агент с телом в простой доступной симуляции, логирование траекторий и живая демонстрация поведения; лицензия CC BY 4.0 упрощает переизложение метода. Немедленный эффект — дискуссионный: это референс-эксперимент для разговоров о «спонтанном» поведении агентов, а ближайшие полгода, вероятно, принесут репликации в открытых средах, шаблоны exploration-песочниц в агент-фреймворках и первые eval-харнессы для свободного поведения агентов.
Почему это важно для пользователей
Для читателя это не сервис, который можно подключить, а материал, который стоит прочитать. Статья занимает 13 страниц и распространяется по лицензии CC BY 4.0, так что её можно бесплатно открыть на arXiv и увидеть своими глазами, что делает ИИ, оставленный «один» на 30 часов. Кому нужен быстрый пересказ — подойдёт материал Gizmodo за 15 октября. Практическая ценность в другом: это конкретный пример того, как далеко зашли embodied-агенты, и готовая рамка для размышлений о том, что вообще значит «игра» для машины. Такая рамка пригодится и для трезвой оценки будущих заявлений о «самостоятельности» и «любопытстве» агентов: работу стоит читать в оригинале, а не ограничиваться пересказами.
Что пока неизвестно / ограничения
Работа остаётся единичным exploratory-экспериментом: 13 агентов, 30-часовые сессии, одна самодельная среда, без бейзлайнов и количественных метрик, поэтому тезис о том, что игра может стать режимом развития машин, — гипотеза, а не подтверждение. Неясно, насколько формализованы классические критерии игры, по которым оценивалось поведение, и применялись ли они независимо несколькими оценщиками. Среда и стек агента не раскрыты, доступ к коду или API не подтверждён, значит воспроизвести setup по открытым материалам непросто. Независимой инженерной критики пока тоже нет: обсуждение на Hacker News на момент подготовки материала пусто (1 балл, 0 комментариев). Обобщения дальше одного эксперимента — например, превращение наблюдения за агентом в готовый UX-паттерн — корректнее считать спекуляцией.
Источники
- Is this machine playing? — Nathan Cloos, Antonio Norelli, Daniel Durbin, Jacob Andreas, Daniela Rus, Phillip Isola (MIT CSAIL), arXiv:2610.07130
- Researchers Stranded an AI Agent on a Virtual Island. Things Got Very Weird. — Gizmodo, Webb Wright
- Hacker News — тред Researchers Stranded an AI Agent on a Virtual Island
Автор
Look at AI, редакция