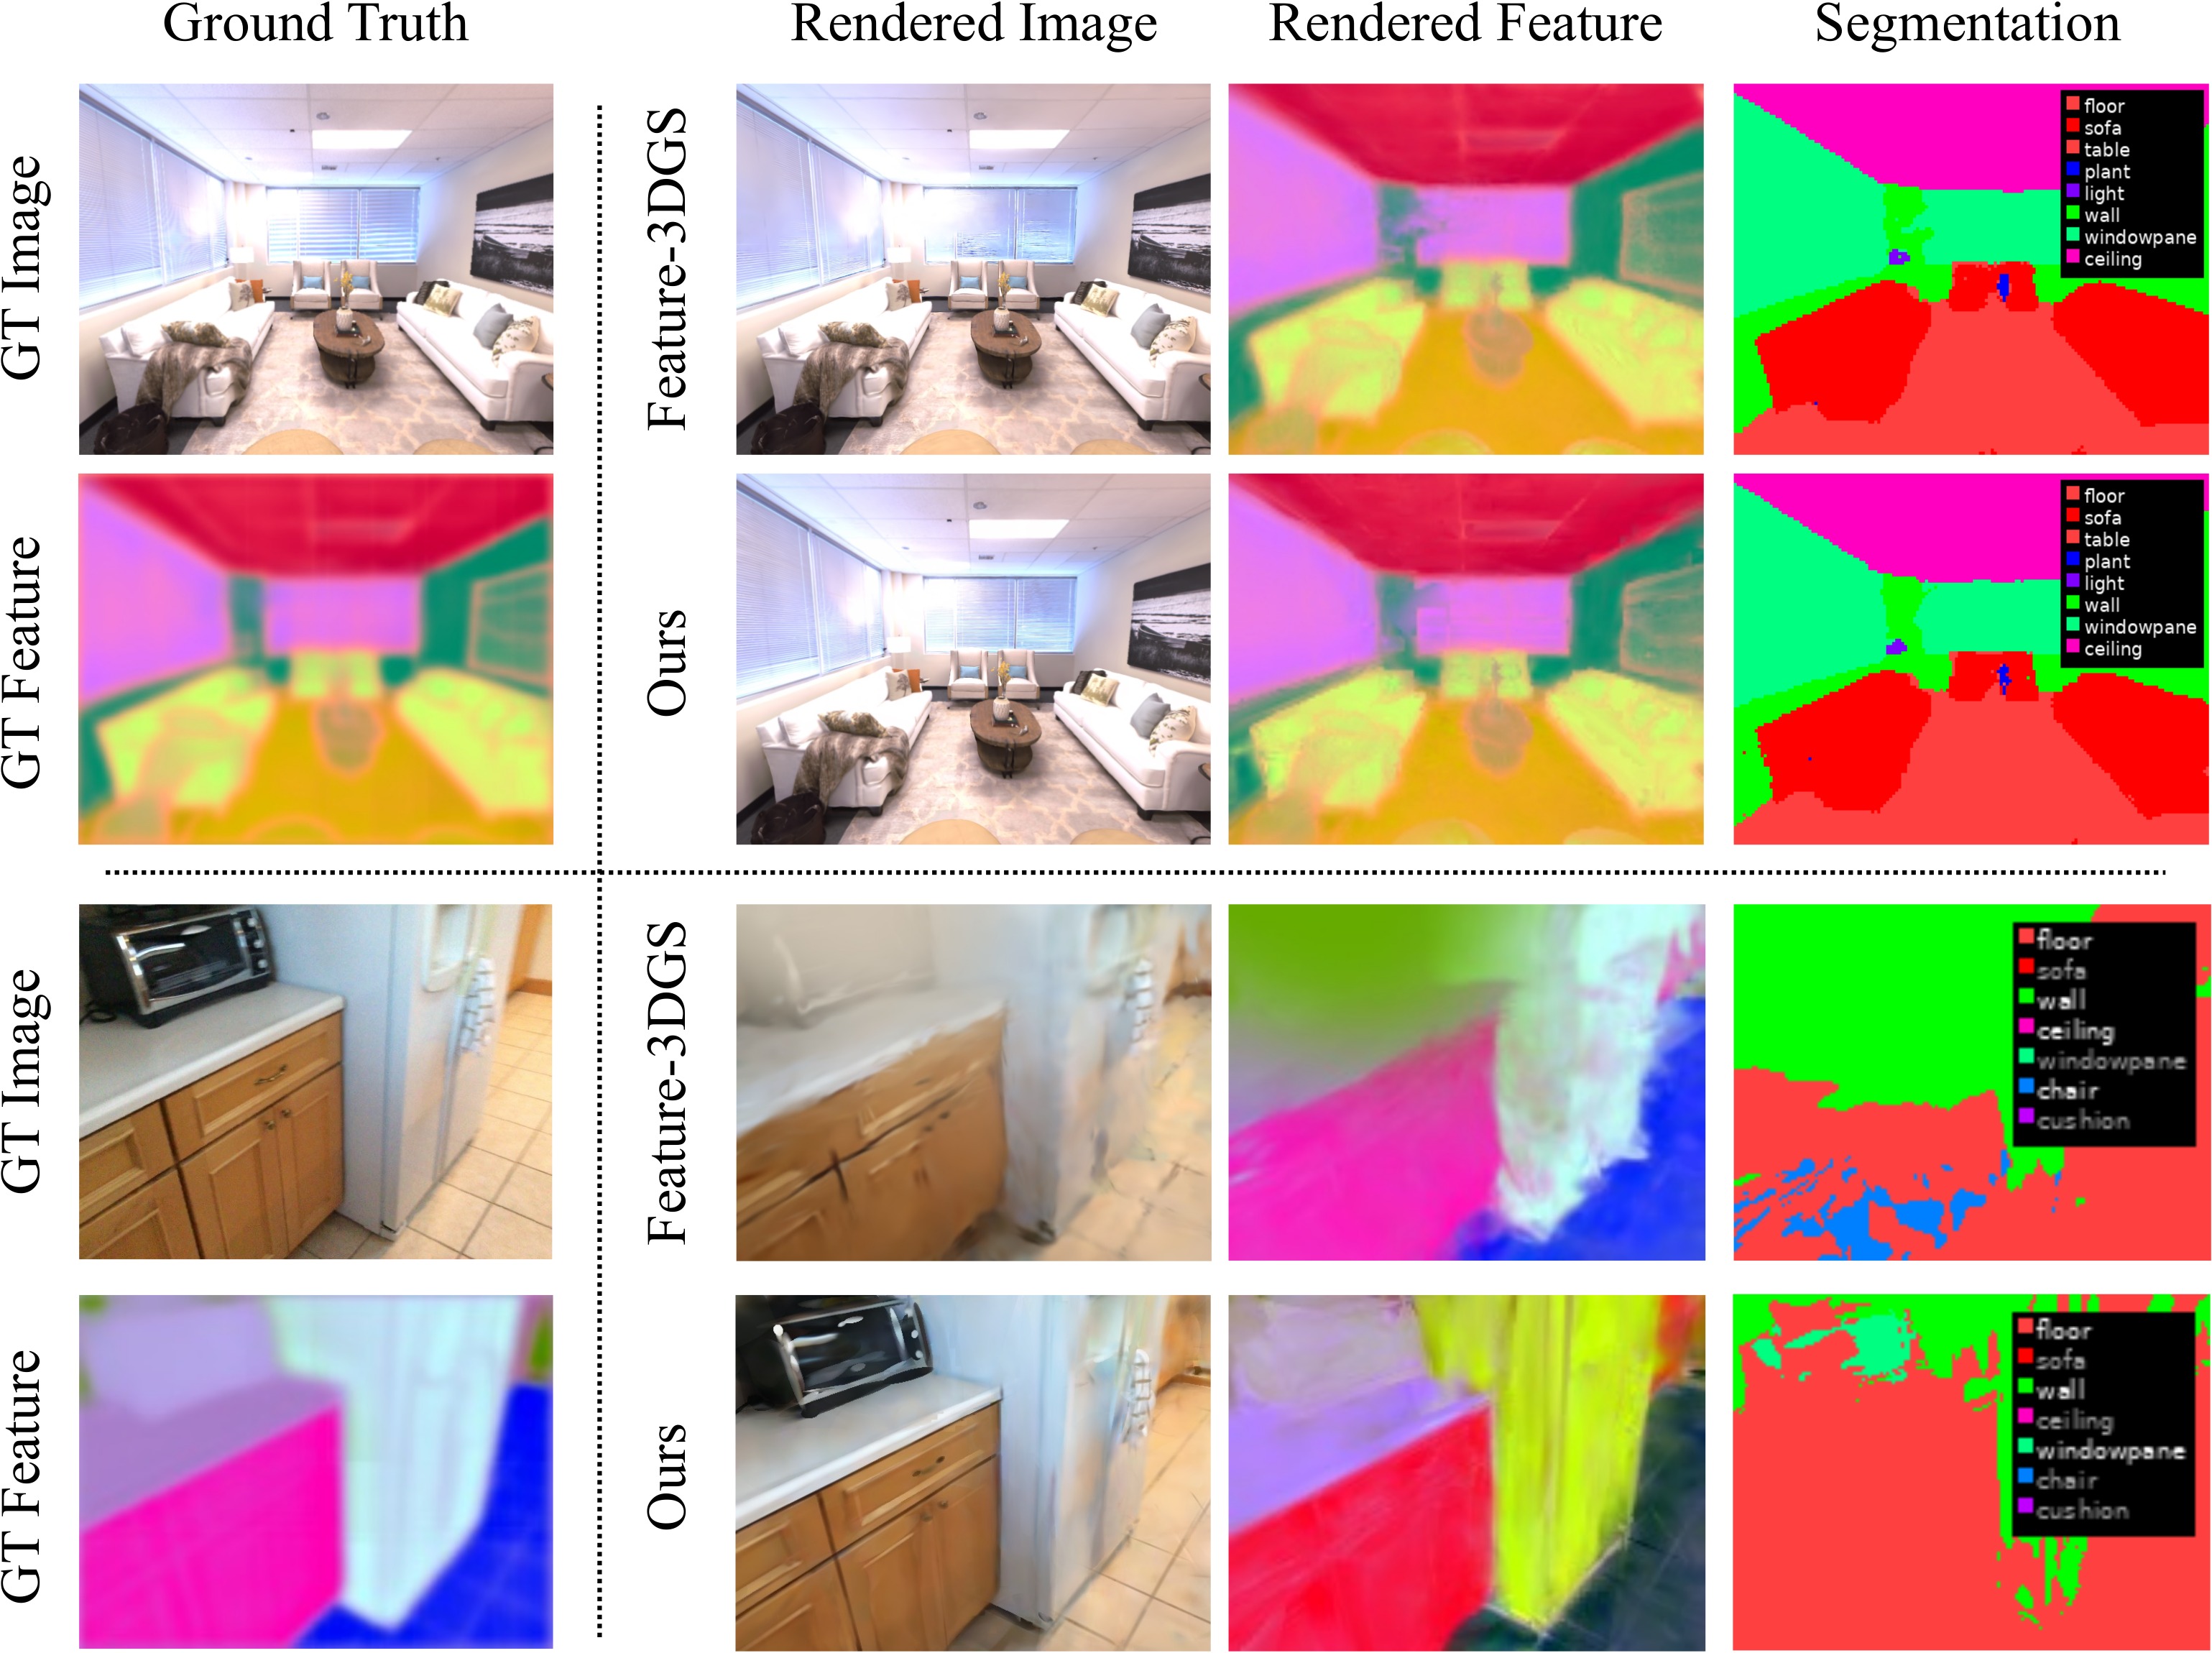
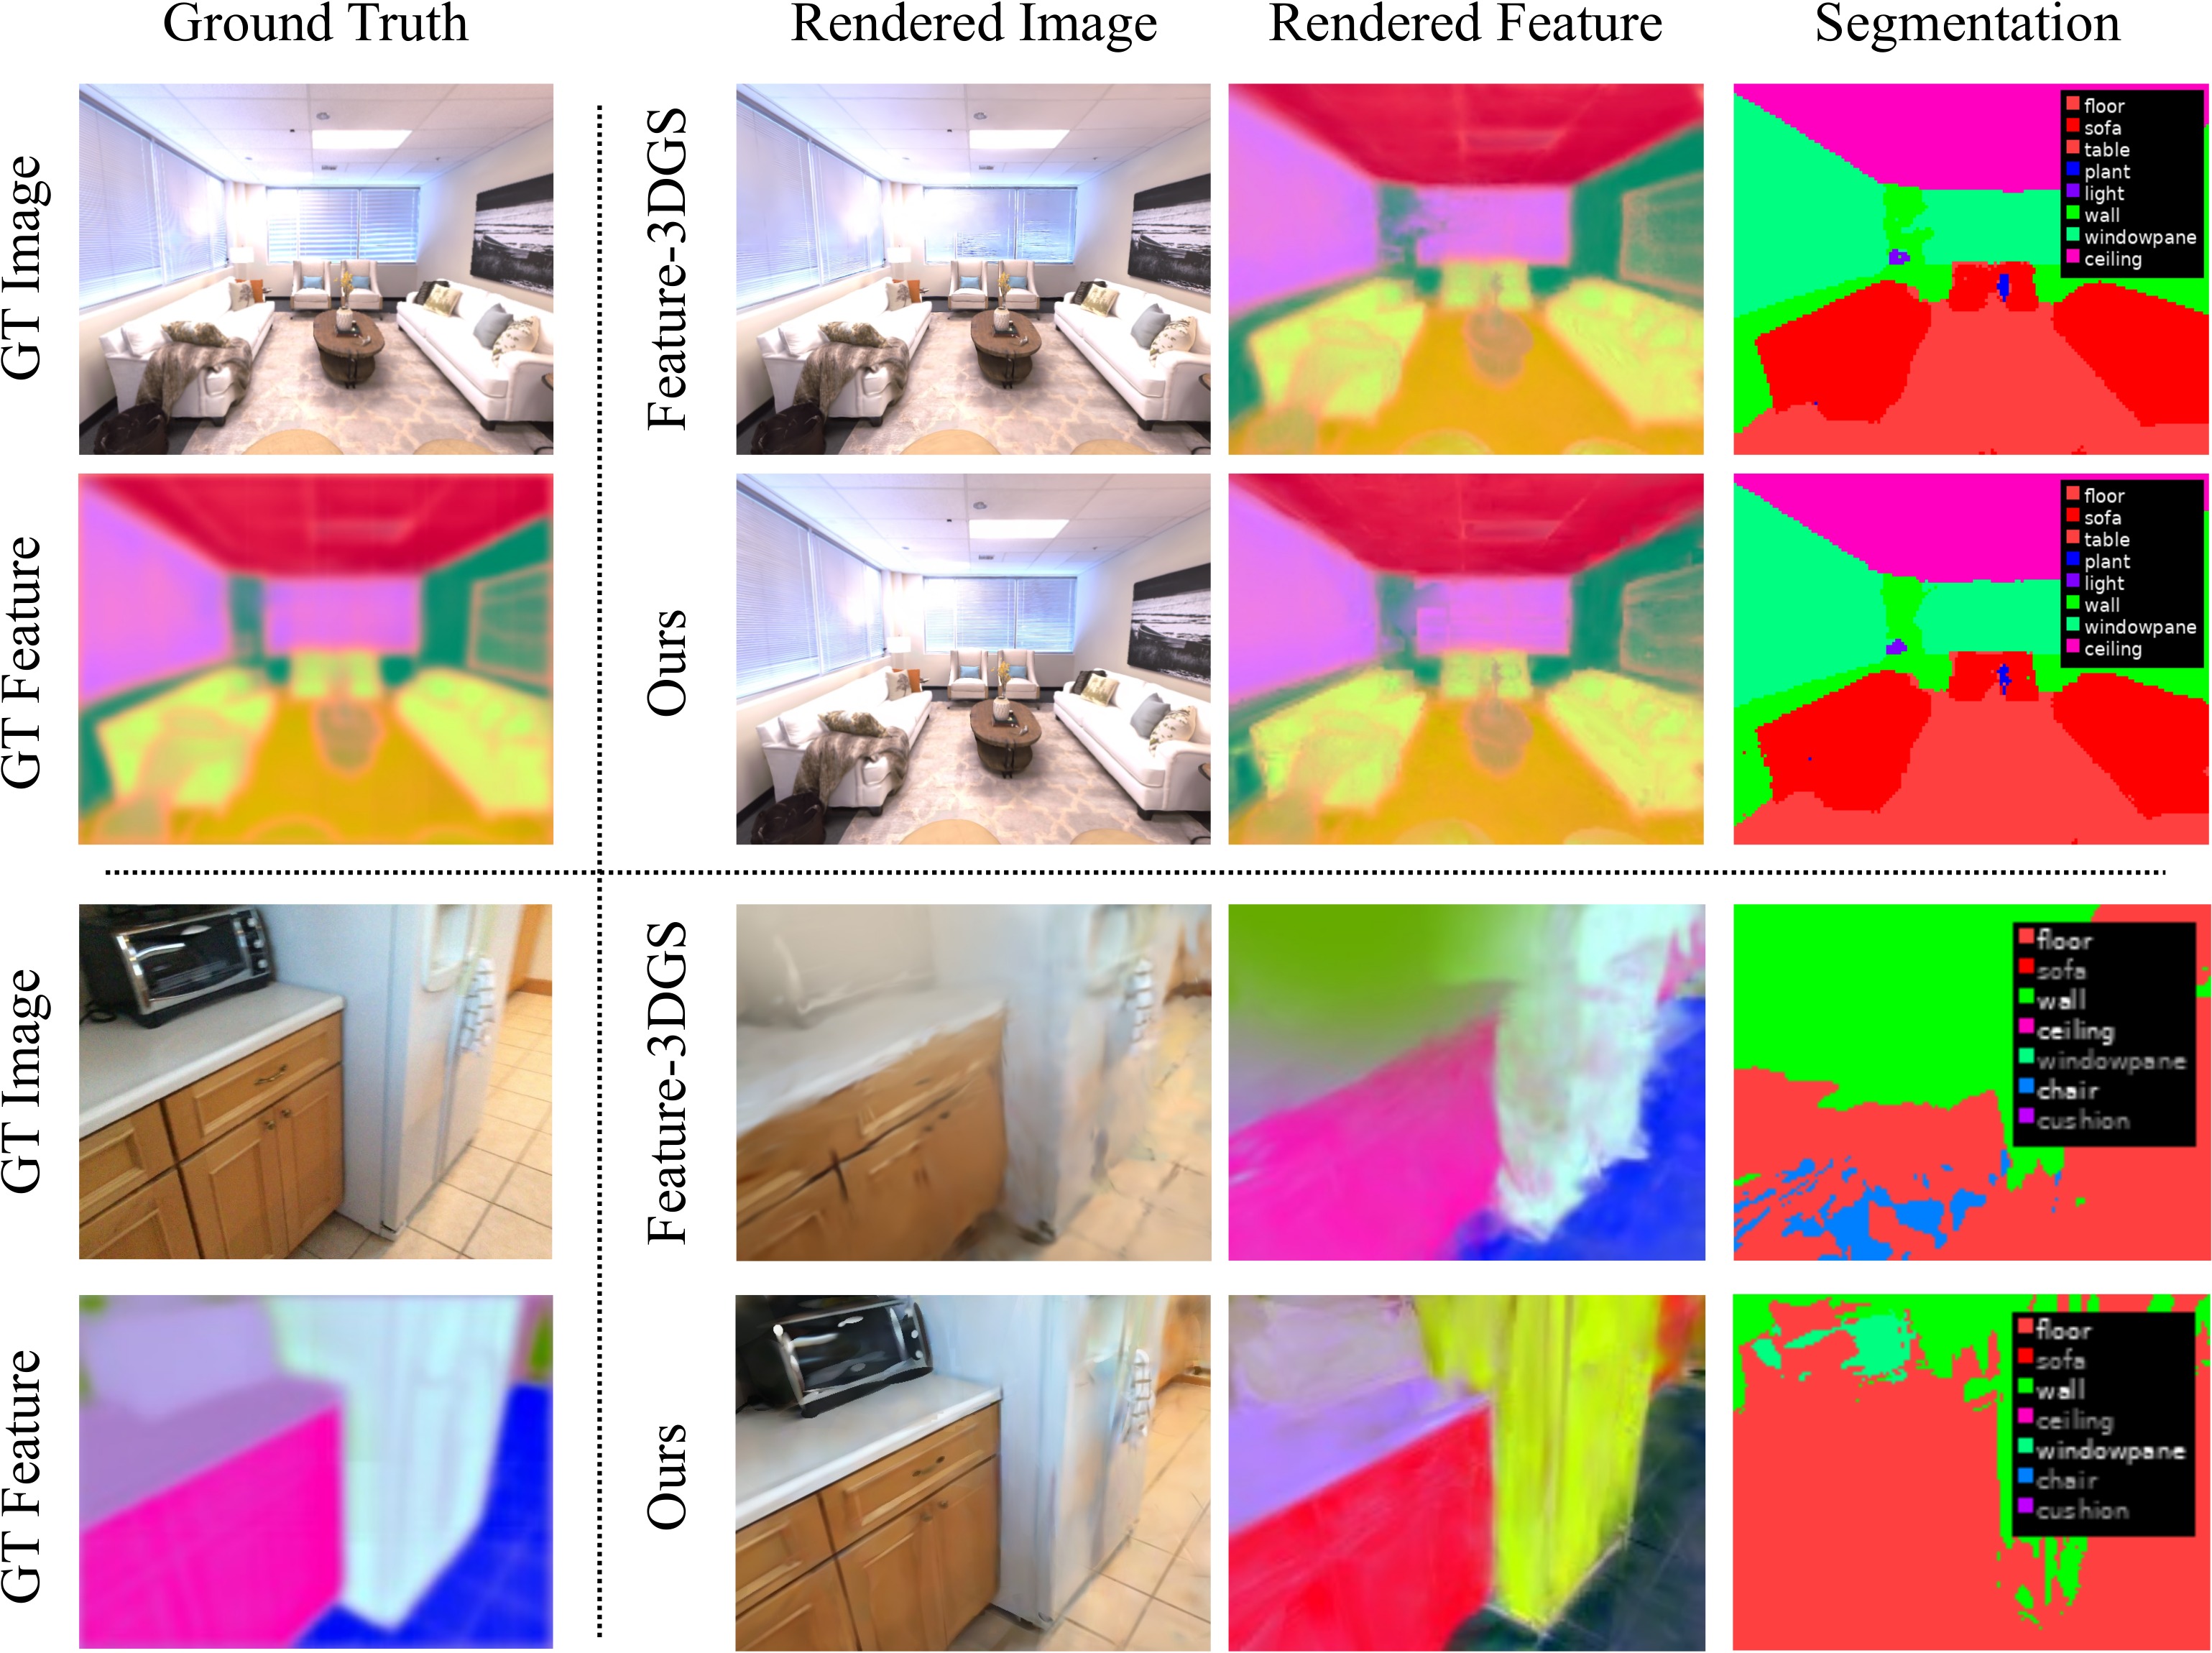
Метод представления 3D-сцен MLP Splatting (Object-Centric Neural Fields) принят на конференцию ECCV 2026. Его примитивы — независимые компактные MLP, которые при супервизии только по RGB сами ложатся на объекты и их части, поэтому сцену можно редактировать напрямую: сдвигать объекты и менять их цвет без отдельного этапа сегментации. По качеству рендера метод сравним с Feature-3DGS на Replica и выигрывает на ScanNet, при этом примитивов в 63 раза меньше, а память ниже в 6 раз. Код открыт под лицензией MIT.

Что произошло
Препринт MLP Splatting: Object-Centric Neural Fields появился на arXiv 2 июня 2026 года под номером 2606.03877, а 13 октября 2026 года camera-ready версия была принята на ECCV 2026. За работой стоит группа из Кембриджа: Shinjeong Kim, Yuzhou Cheng, Xin Kong, Paul H. J. Kelly и Andrew J. Davison. Каждый примитив сцены здесь — независимый компактный MLP с локальной поддержкой, взвешенный анизотропной гауссианой: он предсказывает радиантность и непрозрачность, а итоговое изображение собирается разреженным объемным композитингом по пересечениям луча с примитивами. Опциональная дистилляция 512D-признаков LSeg добавляет open-vocabulary сегментацию и удаление объектов. Числа по качеству: на Replica PSNR 36.25 против 36.18 у Feature-3DGS, на ScanNet 25.35 против 23.32.
Контекст
Стандартный 3D Gaussian Splatting оперирует миллионами гауссиан, которые не привязаны к объектам, поэтому любое объектное действие — выделить, передвинуть, перекрасить или удалить — требует отдельного сегментационного или группирующего модуля поверх представления. MLP Splatting меняет саму единицу работы со сценой: вместо миллиона мелких частиц — сотни семантических примитивов, и эта привязка «примитив—объект» возникает эмерджентно из RGB-супервизии, а не навязывается внешним редактором. Важно различать два результата работы: интерактивное редактирование следует из самой архитектуры, тогда как open-vocabulary сегментация и удаление объектов — это отдельный, опциональный механизм через дистилляцию признаков LSeg.
Почему это важно для индустрии
Для тех, кто строит 3D-инструменты, главный эффект — структурное упрощение пайплайна: этап сегментации или группировки исчезает как отдельный модуль, потому что объектная структура уже закодирована в представлении. Экономика тоже другая: в 63 раза меньше примитивов, в 6 раз меньше памяти и в 2 раза более быстрый рендер относительно Feature-3DGS удешевляют инфраструктурный слой интерактивных приложений, семантического редактирования сцен и робототехники, где важна готовая структура сцены и память. Открытая реализация под MIT с tile-based CUDA и конфигами Replica и ScanNet делает воспроизведение реальным и дает командам готовый бейзлайн по object-centric представлениям, с которым можно сравнивать собственные пайплайны.
Почему это важно для пользователей
Код выложен в репозиторий kxhit/mlp-splatting под лицензией MIT: это tile-based CUDA с конфигами Replica и ScanNet, требования зафиксированы — GPU с compute capability 8.0+ (например, Ampere и новее), Python 3.10+ и torch>=2.10.0. Можно потренировать модель на сценах Replica и ScanNet, повторить авторские цифры и сравнить их со своим текущим 3DGS-пайплайном на собственных данных. Объект выбирается парой-тройкой примитивов, после чего его можно двигать SE(3)-сдвигом или перекрашивать; на странице проекта есть интерактивная демо с language-guided сегментацией и удалением объектов, а препринт доступен на arXiv — фактически за дни можно собрать прототип редактора сцен без собственной исследовательской разработки.
Что пока неизвестно / ограничения
Все цифры эффективности относительные: они посчитаны только против одного базлайна Feature-3DGS и только на индор-датасетах Replica и ScanNet, поэтому подавать их как готовую расчетную экономику для продуктовых решений преждевременно. Разрыв на Replica (36.25 против 36.18) находится в пределах погрешности, и для честного сравнения нужны дисперсии и равнокачественные замеры. Устойчивость эмерджентной группировки по разным инициализациям и числу примитивов пока не аблирована, и вне Replica и ScanNet метод независимо не перепроверен. Пары «в 63 раза—в 6 раз—в 2 раза» не сопровождаются абсолютными метриками латентности и памяти, серверного API нет, а CUDA-пайплайн усложняет перенос на другое железо и другие стеки. Open-vocabulary сегментация зависит от опционального модуля LSeg и не является следствием основной архитектуры.
Источники
- MLP Splatting: Object-Centric Neural Fields — официальная страница проекта
- kxhit/mlp-splatting — официальный кодовый репозиторий (MIT, ECCV 2026)
- MLP Splatting: Object-Centric Neural Fields (arXiv:2606.03877, ECCV 2026)
Автор
Look at AI, редакция