История работы с кодовыми агентами оказывается не расходным материалом, а датасетом: разработчик Nebius Ibragim Badertdinov опубликовал открытый скилл evals-from-sessions, который собирает из прошлых сессий в Claude Code, Codex и Pi приватные eval-задачи с автоматической проверкой. На собственном корпусе задач такой замер показал, что сетапы с одинаковой результативностью различаются в цене вдвое — и что выбор агента разумнее делать по своим данным, а не по публичным бенчмаркам.
Что произошло
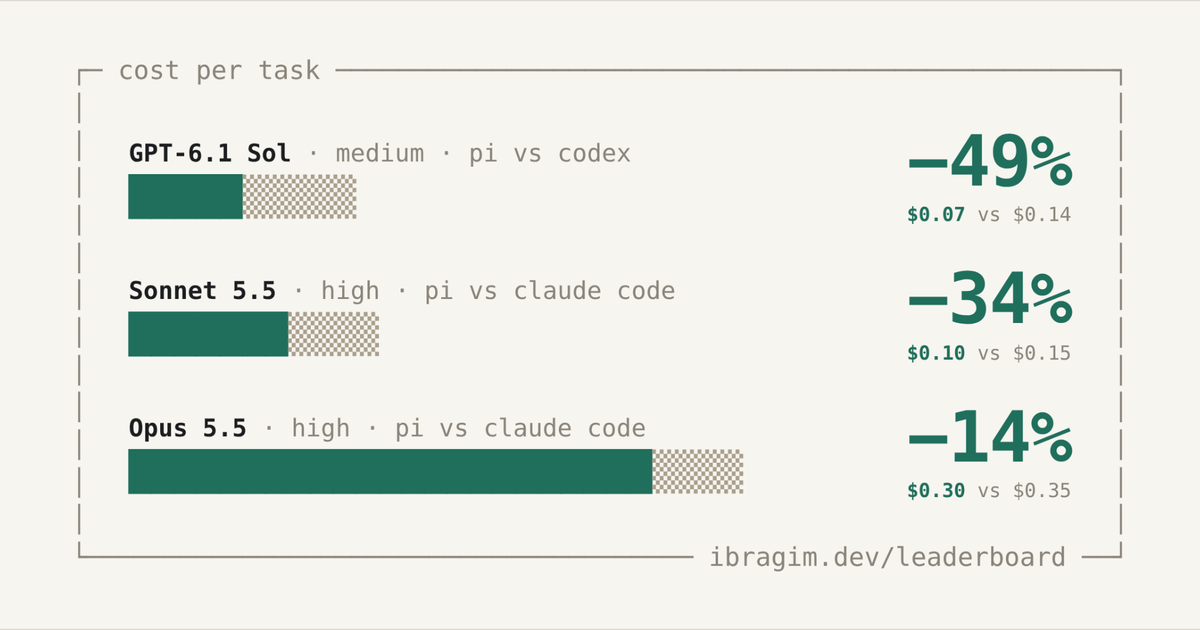
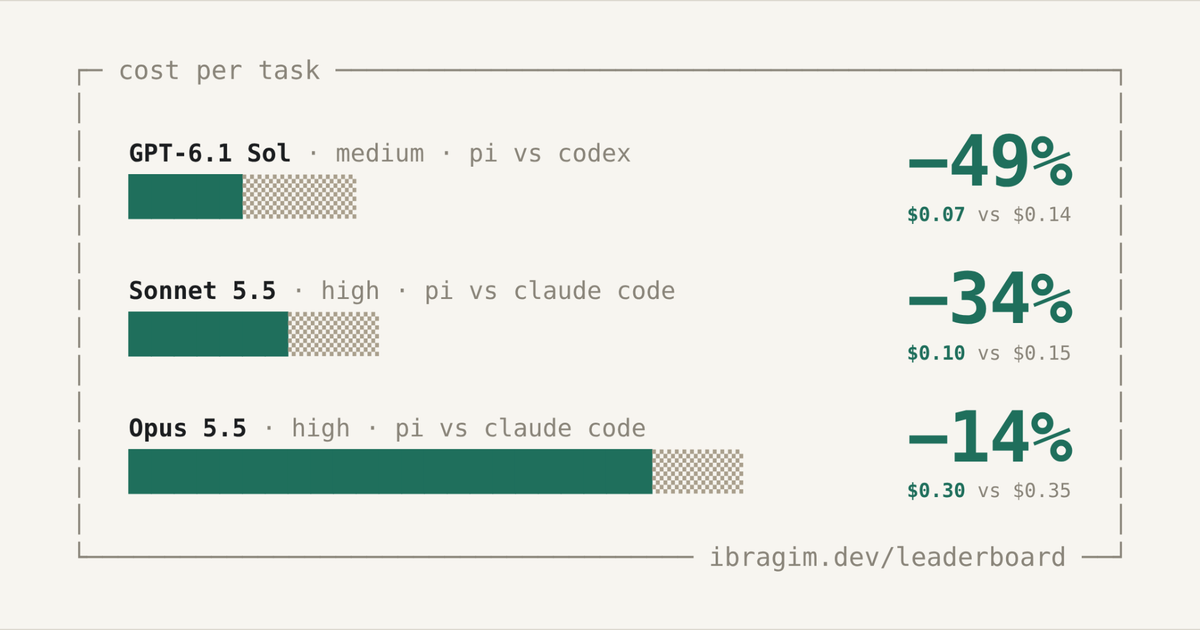
Разработчик Ibragim Badertdinov, известный по работе над RL-средами и датасетом SWE-rebench в Nebius, опубликовал гайд и агентский скилл evals-from-sessions под лицензией MIT. Скилл принимает экспорты сессий из Claude Code, Codex и Pi и превращает их в приватные eval-задачи с автоматической проверкой в формате Harbor-фреймворка; ставится он одной командой npx skills add ibragim-bad/evals-from-sessions или как плагин для тех же трёх агентов. На корпусе из примерно 1270 собственных сессий автор собрал 10 задач и прогнал на них разные сетапы по три раза каждый: лёгкий CLI-агент Pi на модели GPT-6.1 Sol с настройкой medium решил все задачи в среднем за $0.070, тогда как на Codex в среднем уходило $0.138. Безопасность и корректность встроены в сам конвейер: экспорты сканируются через gitleaks, верификатор закрывается от путей обмана, а каждая задача перед попаданием в набор проходит ревью человека.
Контекст
Публичные бенчмарки построены на чужих проектах и дают слабое представление о том, как модель и агент поведут себя на конкретном стеке и стиле работы команды, поэтому переносить их выводы на свои задачи сложно. Ответом стала идея hill climbing на внутренних бенчмарках, которую публично продвигал Satya Nadella, а в экосистеме Claude Code уже появились команды build-eval и hillclimb для сборки собственных замеров. Оставшийся барьер — стоимость ручного написания задач, на которую у большинства команд нет ресурса; подход evals-from-sessions закрывает именно этот пробел, автогенерируя задачи из уже проделанной работы. Инженерная культура автора видна в конструкции конвейера: приватность экспортов проверяется сканером gitleaks, верификатор изолируется от потенциального обмана, а финальное ревью человеком оставляет контроль качества набора за ответственным человеком, а не за автоматикой.
Почему это важно для индустрии
Для индустрии главный сдвиг в том, что сравнение моделей, скиллов и MCP-серверов становится измеримым на собственных задачах команды — по цене и времени решения, а не по чужим проектам из публичных бенчмарков. В кейсе автора это сразу конвертировалось в деньги: сетап с лёгким CLI-агентом Pi на GPT-6.1 Sol в режиме medium обходился вдвое дешевле Codex при том же качестве на его задачах, а приватный eval-корпус превращается в актив, на котором можно холл-клаймбить и проверять обновления моделей и новые скиллы на одних и тех же задачах. Если паттерн приживётся, конвейер «экспорт сессий, eval-задачи, лидерборд сетапов» ожидаемо появится как нативная функция агентских продуктов и как отдельные сервисы приватного бенчмаркинга, а приватные evals станут обычной гигиеной команд, работающих с кодовыми агентами.
Почему это важно для пользователей
Пользоваться этим можно уже сегодня: скилл ставится командой npx skills add ibragim-bad/evals-from-sessions или как плагин для Claude Code, Codex и Pi, лицензия MIT, а гайд и публичный лидерборд автора помогают понять ожидаемый результат. Практичный маршрут на первый заход — прогнать свою историю сессий через сбор задач и за один вечер получить первую версию личного замера, заодно проверив, не решит ли более дешёвая модель или другой агент ваши задачи с тем же качеством: автор именно так нашёл сетап вдвое дешевле и стал тратить на токены вдвое меньше. Ожидания стоит калибровать заранее: с дюжины задач строгого вердикта по моделям не выйдет, но набора достаточно, чтобы поймать грубые перекосы цены и качества между сетапами и отсечь явно избыточно дорогие варианты.
Что пока неизвестно / ограничения
Выводы автора валидны для его 10 задач, а не для моделей в целом — он сам оговаривает, что показал лучший сетап для своих задач, а не рейтинг моделей, и три прогона на небольшом приватном корпусе не дают корректного статистического сравнения. Конверсия из сессий в задачи меньше одного процента: из примерно 1270 сессий получилось 10 задач, каждая после ревью человека, поэтому реальная стоимость проекта скрыта не в установке, а в фильтрации и проверке, а у команд с меньшей историей набор будет ещё меньше. В предприятии пилот требует разрешения security-команды, поскольку экспорты сессий могут содержать проприетарные данные, и сканирование gitleaks не заменяет внутренних политик безопасности.
Источники
- Как я собрал evals из своих задач и стал тратить на токены вдвое меньше — гайд автора на Teletype
- ibragim-bad/evals-from-sessions — официальный репозиторий скилла на GitHub (лицензия MIT)
- Лидерборд сетапов автора — ibragim.dev
Автор
Look at AI, редакция