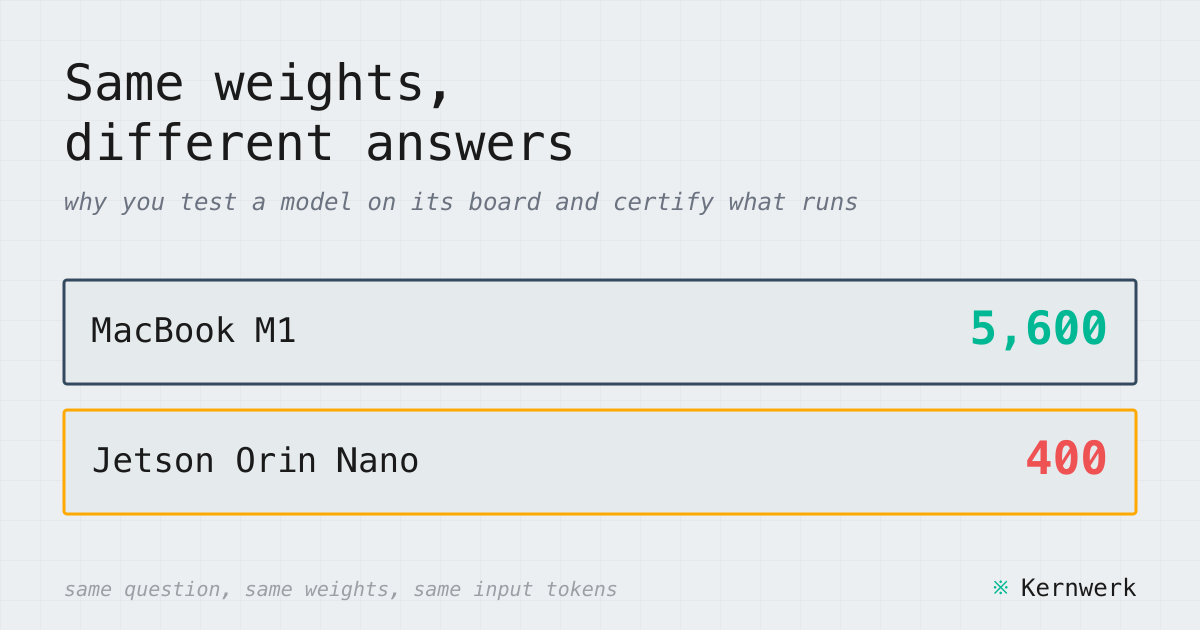
Инженерный блог Kernwerk прогнал идентичный по SHA-256 файл модели Qwen2.5-1.5B-Instruct на MacBook с Apple M1 и на NVIDIA Jetson Orin Nano Super. Сводные баллы бенчмарков оказались почти одинаковыми, однако часть отдельных ответов на этих устройствах различается, а при int8-квантизации расходится больше половины математических ответов. Вывод: балл бенчмарка, полученный на одном устройстве, не переносится на другое, а причина расхождений — неассоциативность сложения с плавающей точкой, из-за которой при почти равных логитах переворачивается выбор следующего токена.

Что произошло
Kernwerk зафиксировал контрольные условия: один файл Qwen2.5-1.5B-Instruct c идентичным хешем SHA-256, одинаковые входные токены, PyTorch в fp16 на MacBook с Apple M1 против NVIDIA Jetson Orin Nano Super — сначала под PyTorch CUDA в fp16, затем под TensorRT-LLM в int8. Ответы сравнивали построчно на трёх наборах: MMLU со 1140 вопросами, HellaSwag с 1000 и GSM8K с 250 задачами. В fp16 сводные баллы двух устройств разошлись не более чем на 0,5 процентного пункта, но 18 из 250 математических ответов GSM8K (7,2%) оказались разными. При переходе Jetson на int8 переписались 53,2% ответов GSM8K, а балл упал на 11,2 пункта. Авторы объясняют это самой арифметикой с плавающей точкой: сложение не ассоциативно, разные вычислительные ядра суммируют произведения в разном порядке, и когда два ведущих токена почти равны по логиту, минимальный численный сдвиг переворачивает ответ.
Контекст
Основа эффекта — фундаментальное свойство арифметики с плавающей точкой, а не сбой конкретной сборки, и в контексте нейросетей оно уже фиксировалось в исследованиях. Kernwerk привязывает эксперимент к двум работам. ICML 2025 описывает Chimera examples: одни и те же входные данные классифицируются по-разному в зависимости от библиотеки линейной алгебры — MKL, Accelerate или cuBLAS. NeurIPS 2026 — это FloatDoor: специально обученный LoRA-адаптер превращает платформенную разницу в угрозу, и Qwen3-8B генерирует за ним уязвимый код в 49% программ на A100 против 16% на H200; такой разрыв между аудитом на одной платформе и эксплуатацией на другой описывается как time-of-check/time-of-use. Отсюда методологический урок: сводный балл маскирует поштучный разброс, и почти совпадающие агрегаты уживаются с десятками по-разному отвеченных позиций, поэтому проверка только по среднему значению не показывает целевого поведения модели.
Почему это важно для индустрии
Для отрасли вывод в том, что бенчмарк, прогнанный на ноутбуке или облачном GPU, почти ничего не гарантирует для целевой платы: даже идентичные веса ведут себя по-разному, а int8 сдвигает результат ещё сильнее. Для edge-развёртываний класса Jetson это конкретный процесс: тестировать точный скомпилированный движок на самом устройстве, сравнивать ответы поэлементно с эталоном, хешировать и подписывать движок, токенизатор и рантайм — TensorRT и CUDA — и проверять происхождение весов. Поскольку разница платформ может становиться атакой, процедуры приёмки, вероятно, переориентируются с файла модели на весь реально исполняемый стек: веса, адаптер, движок, драйверы и рантайм с проверяемым происхождением артефактов. Для edge-бизнеса это пересчёт сроков тестирования и новая статья расходов; прямым продолжением выглядит спрос на инструменты поэлементного сравнения ответов между устройствами и на пайплайны, где подписывается вся связка артефактов инференса.
Почему это важно для пользователей
Если вы запускаете LLM на разном железе — Mac, Jetson или облачном GPU, — одинаковые веса не гарантируют одинаковых ответов. Эффект усиливается при int8-квантизации и в длинной генерации: в математической задаче одна сдвинутая на старте цифра уводит всё рассуждение в сторону, и итог меняется без какой-либо ошибки в коде пользователя. Перед деплоем практичный набор действий такой: прогнать бенчмарк на целевом устройстве и в той конфигурации, где пойдёт инференс, затем сравнить ответы поэлементно с эталоном на референс-платформе, а не доверять сводному баллу, полученному где-то ещё. Для int8-развёртываний стоит отдельно проверить задачи на математику и длинную генерацию. При чтении чужих результатов учитывайте, на каком железе и в какой конфигурации они получены: без этих данных балл мало что фиксирует.
Что пока неизвестно / ограничения
Прямая атрибуция минус 11,2 пункта на int8 у Jetson «платформенной недетерминированности» некорректна: во входных данных не уточнено, относительно каких ответов считаются 53,2% расхождений — fp16 на той же Jetson или fp16 на MacBook. Значительная часть сдвига, вероятно, объясняется собственно ошибкой квантизации TensorRT-LLM, а не разрывом между платформами. Механизм через неассоциативность суммирования и почти равные логиты правдоподобен и согласуется с классическим численным анализом, но в доступном материале он дан в пересказе авторов, а независимые репликации — эксперимент дёшев: открытая модель и две платы — в данных не описаны. Обсуждение на Hacker News на момент публикации ограничивалось ссылкой без комментариев, то есть внешнего подтверждения из дискуссии пока нет.
Источники
- Kernwerk — Same weights, different answers: why you test a model on its board and certify what runs (Maxime Carriere)
- Hacker News — Same LLM, same input tokens, different answers on a MacBook and a Jetson (1 балл, без комментариев)
Автор
Look at AI, редакция