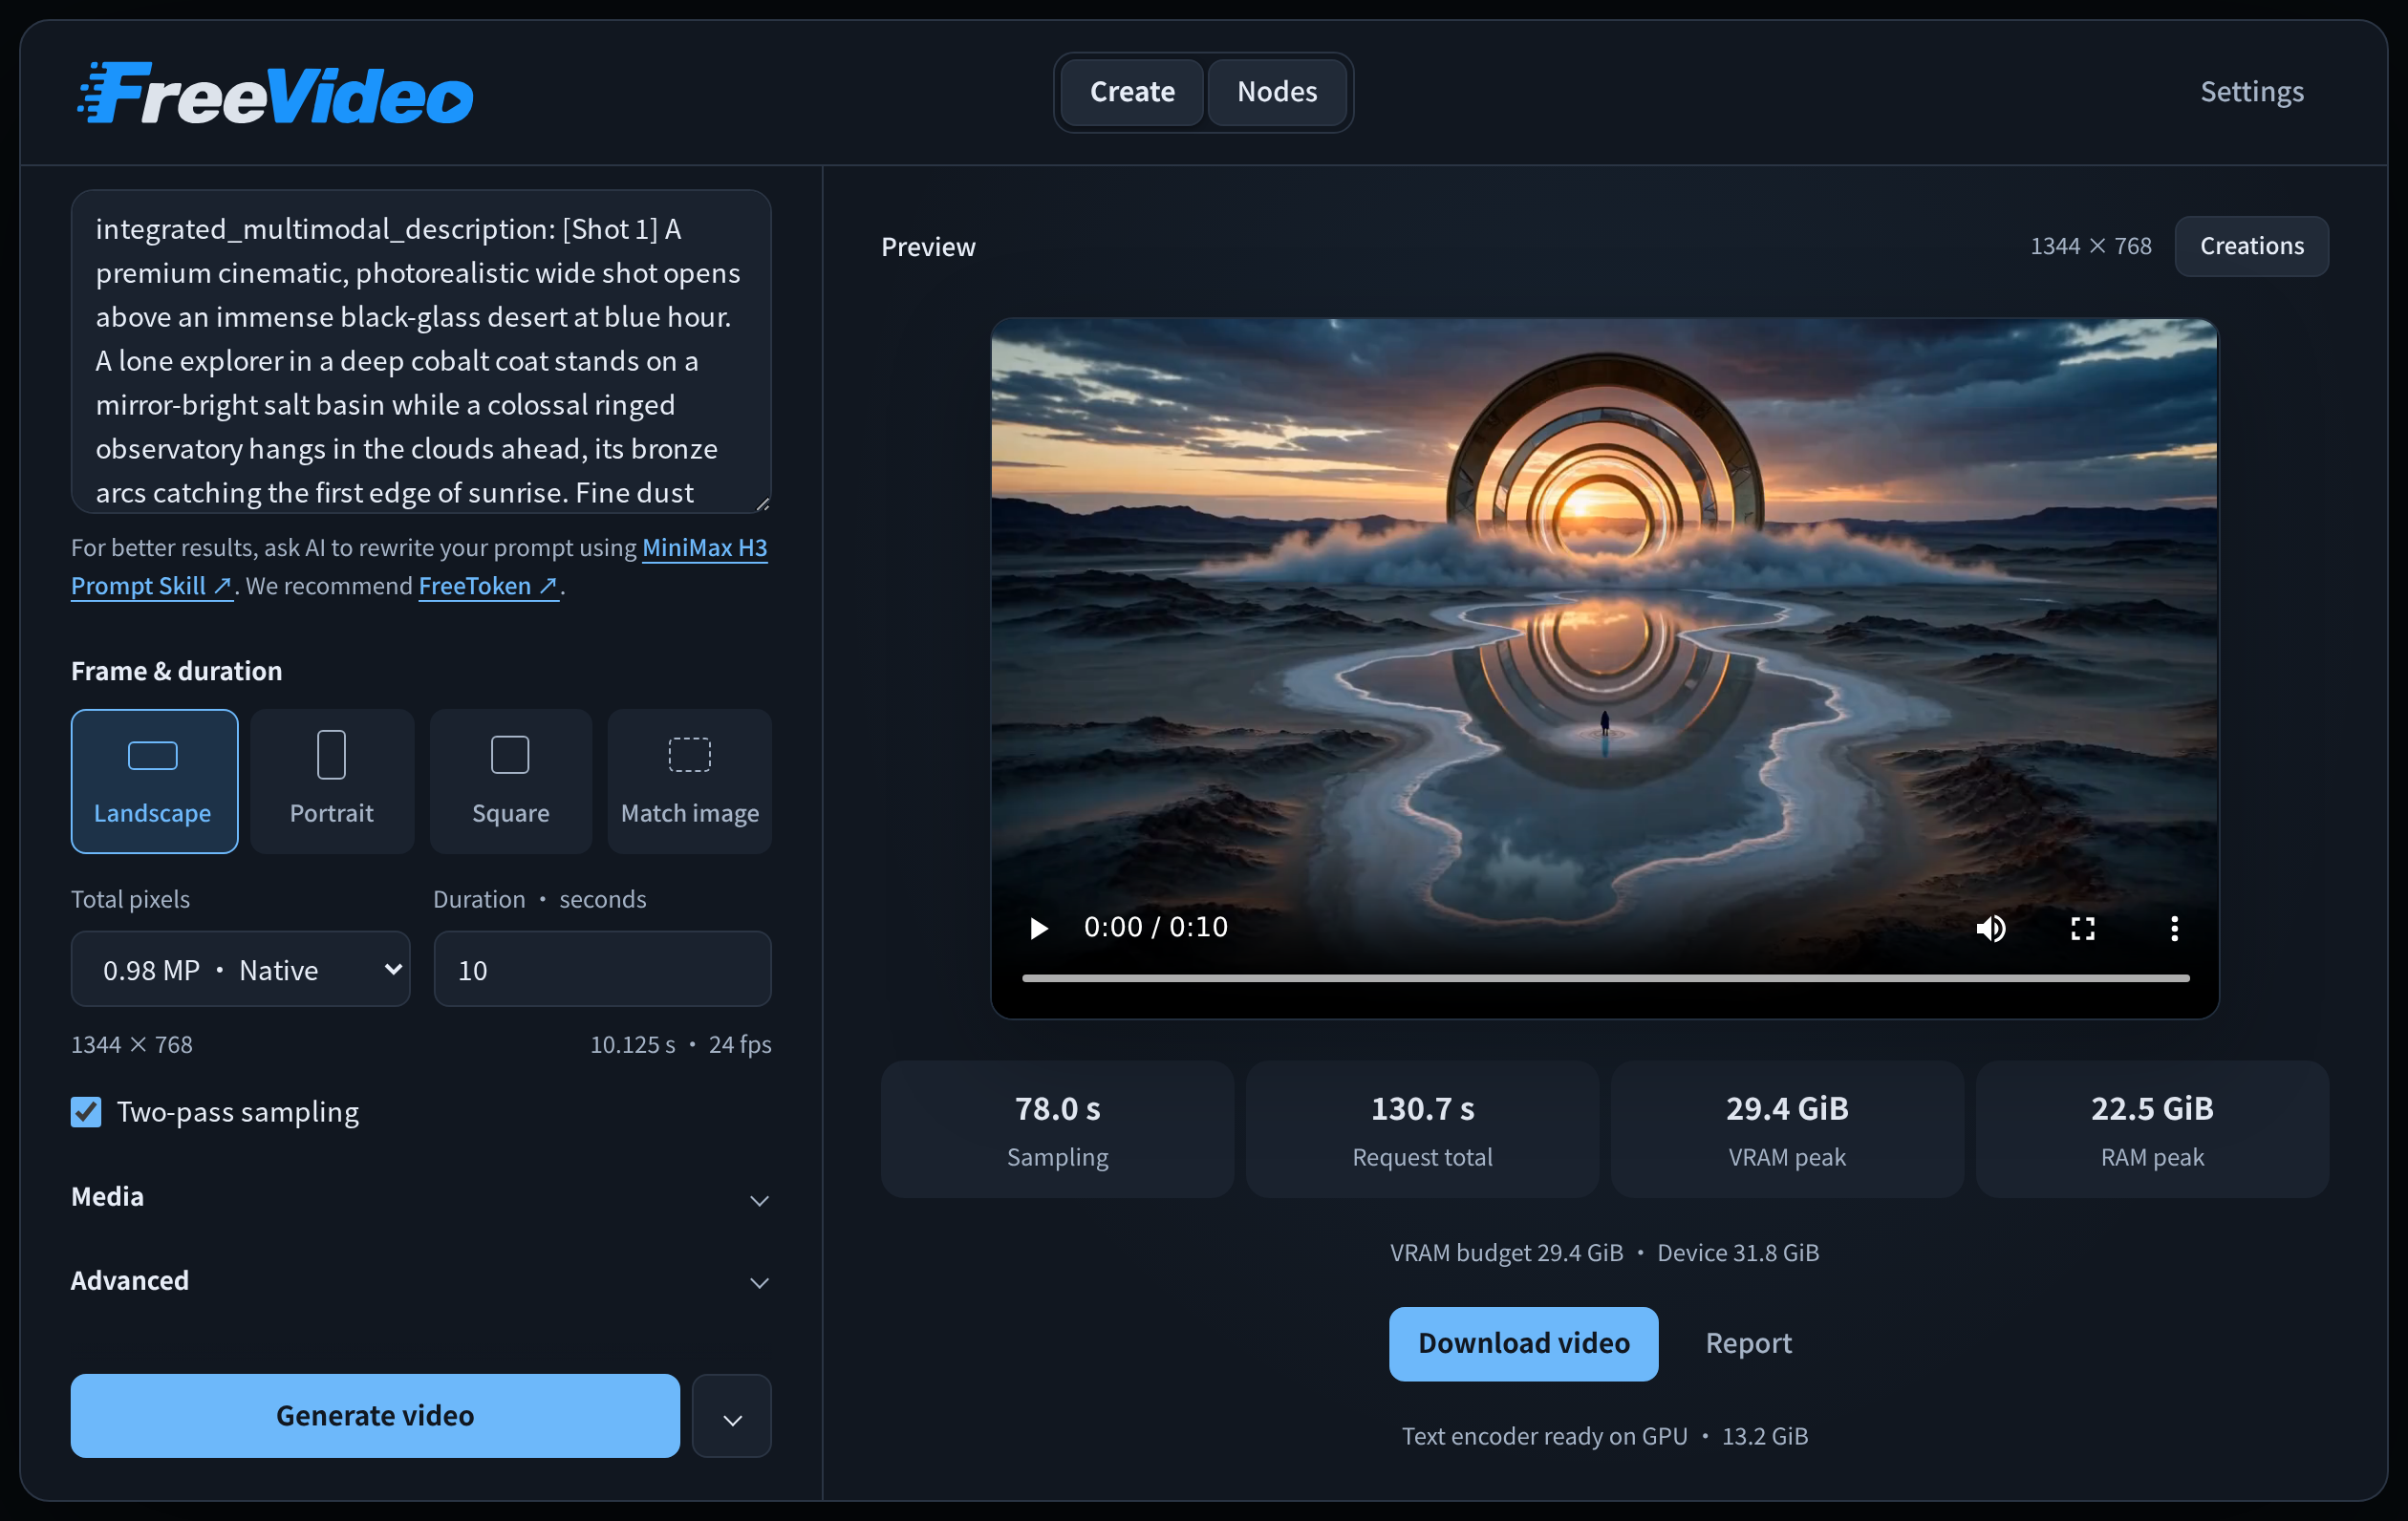
Открытый проект FreeVideo от организации FlashML-org выпустил версию v0.4.4: локальный движок и плагин для ComfyUI, которые генерируют видео моделью MiniMax H3 на домашнем железе при 8 ГБ VRAM и 16 ГБ RAM. В основе лежит модель VDN-H3 с гибридным вниманием Video DeltaNet. Такой запуск смещает порог входа в качественную видеогенерацию с серверных ускорителей на потребительские видеокарты, хотя минимум в 8 ГБ VRAM пока подтверждён только одиночным community-замером.
Что произошло
Проект появился на GitHub 2 октября 2026 года под организацией FlashML-org и за неполные две недели прошёл путь от v0.2.0 до v0.4.4, накопив около 1,9 тыс. звёзд. FreeVideo работает в двух форматах: как локальный движок и как плагин для ComfyUI; лаунчеры покрывают Windows, Linux и macOS, включая режим оффлайн-установки без доступа в сеть. Генерацию выполняет 8-шаговая модель VDN-H3, веса которой опубликованы под именем OpenVDN/vdn-minimax-h3. Планировщик исполнения делит 50 трансформер-блоков весом около 432,5 МБ каждый между VRAM, закреплённой памятью хоста и диском и подбирает арифметику под карту: int8 для GeForce и RTX 30-й серии, FP8 для старших ускорителей. Серверные замеры в документации показывают потенциал архитектуры: 14,4 секунды видео в разрешении 768p за 9 секунд на кластере из восьми NVIDIA B200 и ускорение плотного H3-DiT на одной B200 с 13,95 до 5,34 минуты.
Контекст
Гибридное внимание Video DeltaNet описано в статье arXiv:2609.20744, опубликованной 17 сентября 2026 года: точный softmax-attention считается внутри окна соседних кадров, а двунаправленная линейная память удерживает дальний контекст сцены. Авторы сразу выложили код, веса и SGLang-cookbook, поэтому подход перестал быть только публикацией и стал воспроизводимым инженерным стандартом. Плотный DiT-блок с квадратичным вниманием плохо масштабируется на длинное видео, и гибридная схема снимает именно это ограничение: связные ролики длительностью свыше минуты уже заявлены в релизе v0.4.0. Важно, что FreeVideo сам не является моделью, а представляет собой слой исполнения: он перебирает ядра внимания по цепочке SageAttention 2, затем PyTorch flash, cuDNN и FlashAttention 2/4 и адаптирует их под доступную память. Разбиение весов между VRAM, закреплённой памятью хоста и диском в видеосегменте выглядит новинкой, но для локальных LLM-серверов это давно рутинный приём, на который инженеры могут опираться.
Почему это важно для индустрии
Для индустрии смена касается прежде всего экономики: качественная видеогенерация перестаёт требовать аренды ускорителей уровня B200 и H200, и себестоимость ролика внутри локального пайплайна радикально отличается от облачной. Облачные генераторы по подписке теряют монополию на доступность серверного железа и получают ценового конкурента в лице локальных пайплайнов, если community воспроизведёт заявленные конфигурации. Продукты в таких условиях проектируются вокруг очередей, батчей и агентных сценариев: видео становится ночной пакетной работой, а не интерактивной генерацией по клику. При сохранении темпа релизов от v0.2.0 до v0.4.4 стоит ожидать подтверждённых замеров на 8-гигабайтных конфигурациях, дальнейшего ускорения attention-ядер и роста LoRA-экосистемы вокруг VDN-H3, а сам шаблон «гибридное внимание плюс оффлоад весов между VRAM, RAM и диском» при оформлении планировщика как переиспользуемого компонента рискует повториться для следующих медиамоделей. Сдерживающий фактор для бизнеса — MiniMax H3 Community License с территориальными и acceptable-use ограничениями: коммерческие сценарии нужно сверять с её условиями, а не считать веса полностью свободными.
Почему это важно для пользователей
Попробовать можно в день выхода: лаунчер FreeVideo.exe сам разворачивает ComfyUI, окружение и модели, поддерживает существующие папки моделей, а движок понимает LoRA, задание первого и последнего кадра и референсы по изображению, видео и аудио. Замеры из docs/execution-planning.md для 10-секундного ролика в разрешении 1344×768 в режиме two-pass дают около 122 секунд на RTX 5090 и 486–558 секунд на конфигурациях с 16 ГБ VRAM: на практике это около двух минут ожидания при 32 ГБ VRAM и от восьми до десяти минут при 16 ГБ. Владельцам пожилых карт есть смысл смотреть на историю релизов: в v0.3.0 появился int8-режим, ускоривший RTX 3090 примерно в 2,3 раза. Реалистичный рабочий сценарий сегодня — офлайн-генерация, где минуты ожидания на ролик не ломают процесс.
Что пока неизвестно / ограничения
Главный открытый вопрос — доказательность минимума в 8 ГБ VRAM. Он опирается на одиночный community-замер в 603 секунды из issue #22, снятый без контролируемого протокола, и на сетку capacity, полученную на серверной H200 с искусственно урезанными лимитами памяти: цифра 13,8 секунды на шаг соответствует эмуляции 8 и 16 ГБ, а не работе на настоящей домашней карте. Полного end-to-end замера на реальной 8-гигабайтной карте в официальной документации нет, поэтому до независимого воспроизведения 8 ГБ корректнее считать гипотезой, а не подтверждённым результатом. Качество изображения в int8-режиме на старых видеокартах независимыми замерами пока не проверено, а поддержка macOS остаётся в статусе preview.
Источники
- GitHub — FlashML-org/FreeVideo: локальный движок и плагин ComfyUI для MiniMax H3 (README, релизы v0.2.0–v0.4.4)
- Документация FreeVideo — план исполнения docs/execution-planning.md с замерами (H200 capacity grid, Windows end-to-end)
- VideoDeltaNet (VDN) on MiniMax H3 — официальный сайт проекта
- Video DeltaNet on MiniMax H3 — статья arXiv:2609.20744
Автор
Look at AI, редакция