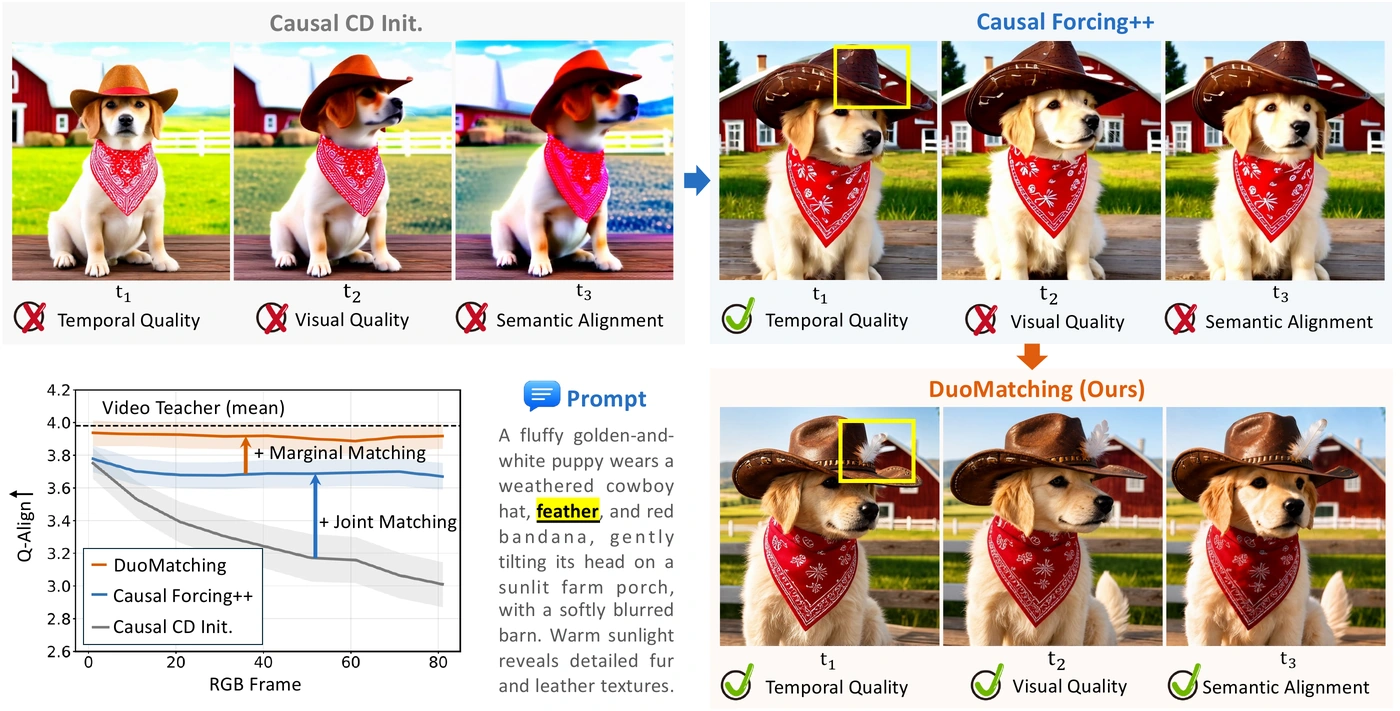
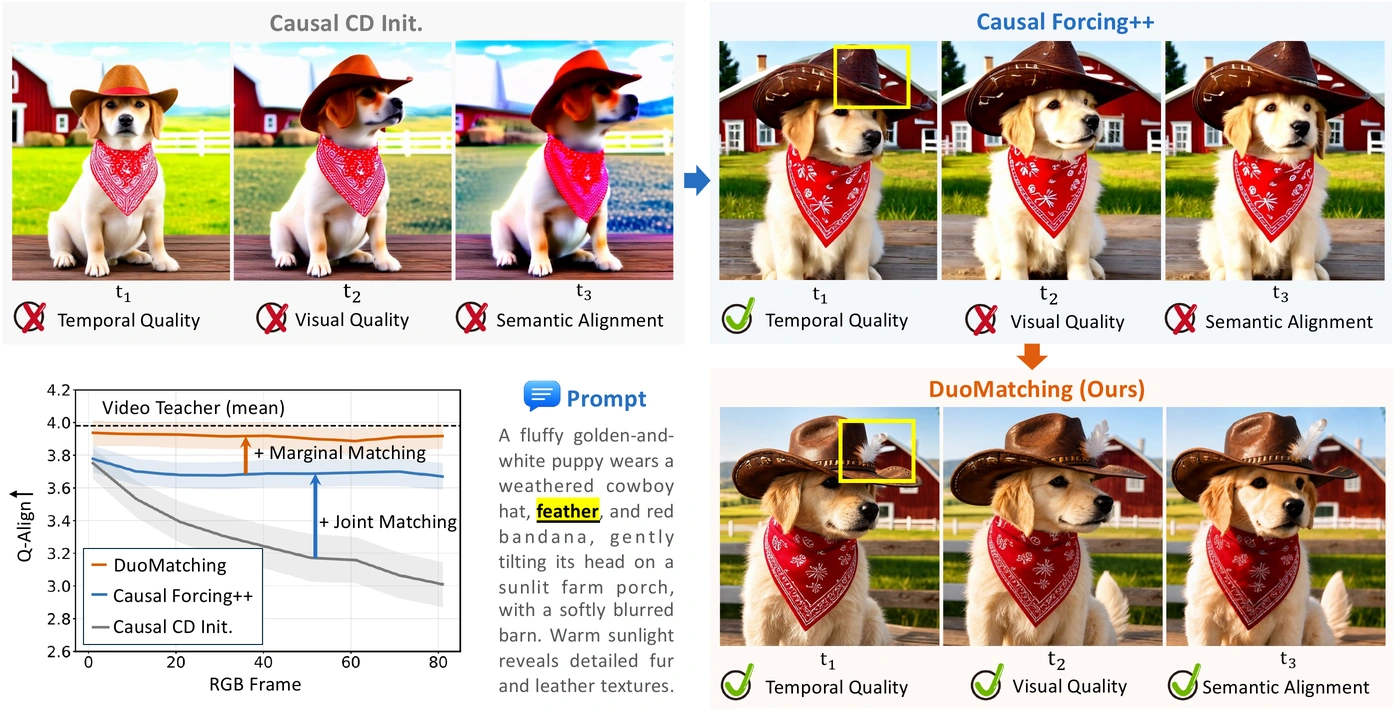
ByteDance совместно с MMLab CUHK и HKUST опубликовала препринт DuoMatching (arXiv 2610.03543, 2 октября 2026) — метод дистилляции диффузионных моделей для few-step потоковой генерации видео. Поверх стандартного joint distribution matching у видео-учителя Wan2.1-T2V-14B метод вводит покадровый маргинальный матчинг у картинковой модели Qwen-Image и перебрасывает в видеостудента визуальные и семантические приоры. В человеческих оценках авторов DuoMatching выигрывал у всех бейслайнов при равном числе шагов, причём прирост качества достигается на этапе дистилляции, без дополнительных затрат на инференсе. Код под Apache-2.0 и чекпоинт уже опубликованы, так что двухшаговую генерацию можно запустить на собственной CUDA-карте.
Что произошло
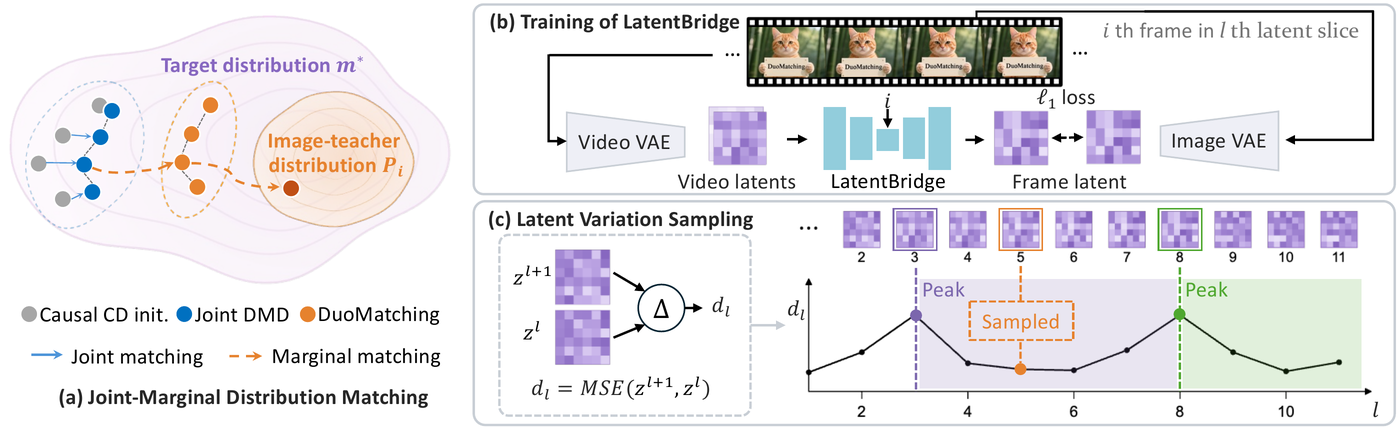
2 октября 2026 года появилась статья DuoMatching от команды ByteDance и исследователей MMLab при CUHK и HKUST. Схема обучения двустороння: студент учится у видео-учителя Wan2.1-T2V-14B через joint distribution matching, а параллельно выполняется помаргинальный кадровый матчинг у картинковой модели Qwen-Image, который переносит визуальные и семантические приоры статичных кадров. За работоспособность переноса отвечают два новых компонента: модуль LatentBridge устраняет рассогласование сжатых видео-латентов и image-латентов, а Latent Variation Sampling распределяет кадровую супервизию по разным временным сегментам, снижая её избыточность. По авторским human eval DuoMatching выигрывал более 80% предпочтений против Causal Forcing++, One-Forcing, Reward Forcing и CausVid при равном числе шагов, улучшая качество кадров, композицию и семантику и почти не жертвуя динамикой движения. Репозиторий выложен под лицензией Apache-2.0, чекпоинт JohnZhan/DuoMatching опубликован на HuggingFace.
Контекст
DuoMatching продолжает линейку few-step дистилляции видео-диффузии, которую в последние годы развивают Causal Forcing, Self Forcing и CausVid. Общая задача направления — сократить десятки шагов диффузионного инференса до единиц, чтобы видеогенерация стала потоковой и дешёвой. У joint-DMD-подходов известна слабость: при автогрессивных роллаутах теряются визуальное качество и семантика кадра, и для её закрытия в схему введена кадровая супервизия у сильной картинной модели. Методологически важен способ достижения качества: DuoMatching растит его на этапе дистилляции, а не через reward-модель или большее число шагов на инференсе, поэтому его противостояние линии Reward Forcing построено не на объёме супервизии, а на другом приёме. Перенос приоров через явный маргинальный матчинг с мостом латентов выглядит как обобщаемый приём мультимодальной дистилляции, а не трюк, привязанный только к связке Wan2.1 и Qwen-Image.
Почему это важно для индустрии
Для индустрии ключевой эффект — экономика генерации: дистилляция до двух шагов без оверхеда на инференсе приближает streaming-видео к реальному времени, а связка joint+marginal может стать новым шаблоном для few-step видео-моделей. Это шаг к коммодитизации базовой видеогенерации: ценность смещается из «мы умеем генерировать» в доменную специализацию, интеграцию в продукт и качество пайплайнов. Открытый чекпоинт, дистиллированный из Wan2.1-T2V-14B, делает потоковую генерацию практичной для продуктов уже сейчас — интерактивное превью и видео как шаг автоматизации можно собирать на собственном инференсе, не дожидаясь чужого API. Если авторские цифры подтвердятся независимыми репликациями, бейслайны Causal Forcing++, One-Forcing, Reward Forcing и CausVid начнут сравнивать с DuoMatching-вариантами, а двухшаговые дистилляты могут стать дефолтной точкой старта для команд видеосервисов. В перспективе тот же приём с мостом латентов применим к переносу приоров в другие модальности, от аудио до 3D.
Почему это важно для пользователей
Всё открыто, поэтому проверить заявки метода можно без участия авторов. Практичный маршрут: склонировать репозиторий github.com/JohnZhan2023/DuoMatching со стеком Python 3.10, PyTorch 2.6, CUDA и FlashAttention или FlexAttention, скачать чекпоинт JohnZhan/DuoMatching с HuggingFace и запустить двухшаговую генерацию через inference.py на своей карте. Без установки — посмотреть около сорока парных видео-сравнений и анимацию метода на проектной странице и составить впечатление за несколько минут. Тем, кому нужен нестандартный сценарий, доступно полное обучение по VidProM-промптам на восьми GPU — вариант адаптации модели под свою доменную задачу. Разумный скоуп на старте — прототип и демо: проверка на собственных промптах и своём железе до любых продуктовых решений.
Что пока неизвестно / ограничения
Цифра «более 80% предпочтений» — это авторский human eval из препринта, а не независимая валидация; без раскрытого протокола с числом оценщиков, режимом слепого или открытого сравнения и распределением промптов её корректно воспринимать только как оценку авторов. В открытых материалах нет метрик latency и VRAM под конкретное железо, поэтому тезис о генерации, близкой к реальному времени, пока не проверить числами. Ожидания, что связка joint+marginal станет дефолтом few-step дистилляции, а перенос приоров с мостом латентов распространится на другие модальности, остаются интерпретациями и требуют независимых проверок.
Источники
- DuoMatching: Joint-Marginal Distribution Matching for Few-Step Video Generation (arXiv:2610.03543)
- Проектная страница DuoMatching (ByteDance, MMLab CUHK, HKUST) — парные сравнения и анимация метода
- GitHub JohnZhan2023/DuoMatching — код под Apache-2.0, чекпоинт и инструкции по запуску inference.py
Автор
Look at AI, редакция