OpenAI вечером 2 октября обнулила usage-лимиты на всех платных тарифах ChatGPT в порядке извинения за неудачный запуск флагманской модели GPT-6.1 Sol: из-за наплыва запросов у новинки в первые дни упала скорость обработки. Компания утверждает, что производительность уже вернулась к штатной, но независимых замеров, которые подтверждали бы это, пока нет.
Что произошло
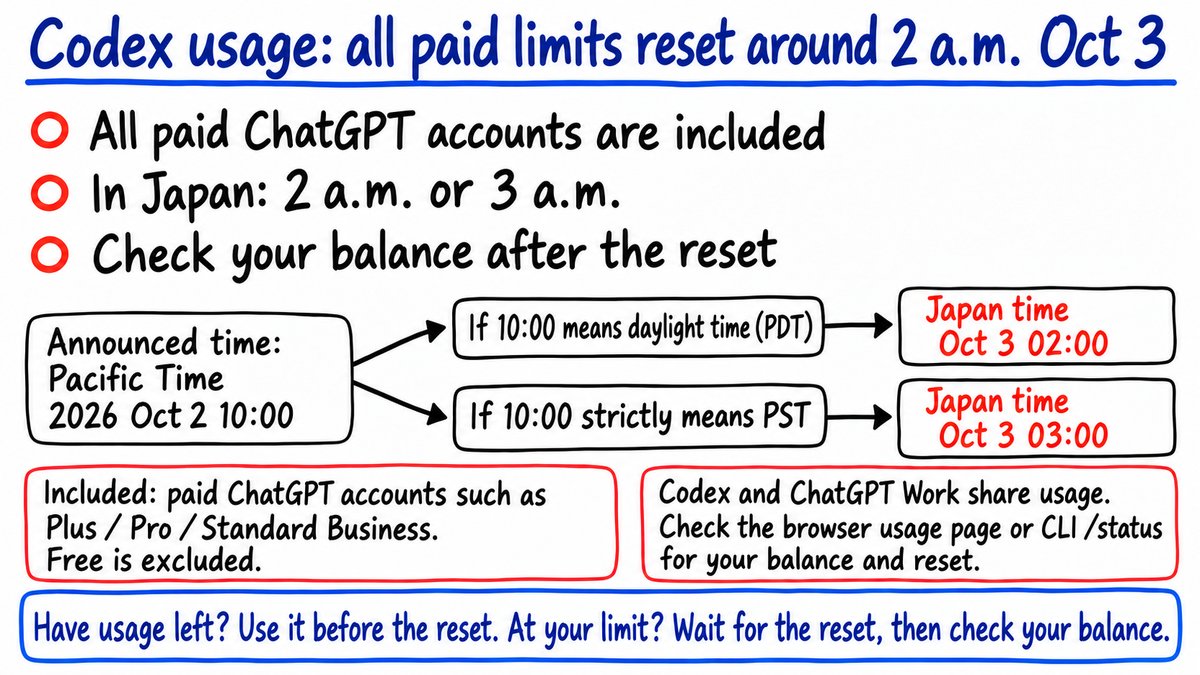
Сброс анонсировал руководитель Codex в OpenAI Тибо Соттио (Thibault Sottiaux) в своём аккаунте X (@thsottiaux): в 20:00 по Москве, что соответствует 10:00 по тихоокеанскому времени 2 октября, счётчики usage-лимитов обнуляются на Plus, Pro, Business, а также в ChatGPT Work и Codex, а бесплатный тариф жест не затрагивает. Соттио прямо связал шаг с неудачным стартом модели GPT-6.1 Sol, выпущенной 29 сентября 2026 года: в первые два дня после релиза из-за резкого наплыва запросов скорость обработки падала ниже ожидаемой. К моменту объявления, по словам Соттио, скорость вернулась к штатной.
Контекст
Для OpenAI это повторяющаяся практика, а не разовый жест: платные лимиты компания уже обнуляла 11 и 29 августа и 26 сентября 2026 года. Usage-лимиты устроены как счётчики сообщений с 5-часовым окном восстановления, и обнуление возвращает подписчику полный тарифный запас запросов. Предыдущие компенсационные сбросы также следовали за нагрузочными инцидентами на свежих релизах, когда наплыв обращений к новой старшей модели просаживал скорость ниже ожидаемой.
Почему это важно для индустрии
Повторяемость сбросов показывает, что узкое место флагманских запусков OpenAI находится в инференс-ёмкости и стабильности сервиса, а не в качестве модели: компенсация квотами становится встроенным элементом релизного цикла и инструментом удержания платной аудитории, пока свежий релиз не дотягивает до заявленной скорости. Для команд, строящих продукты на ChatGPT Work и Codex, сброс — это всплеск бесплатной ёмкости с заранее известным моментом старта, который можно использовать для отложенных задач и пакетных прогонов. Опора, однако, на жест доброй воли, а не на контракт: публичных SLA и обязательных компенсаций у OpenAI нет, поэтому выстраивать на таких окнах жёсткие зависимости рискованно. Если шаблон «запуск флагмана, затем просадка скорости, затем компенсационный сброс» сохранится, командам придётся учитывать даты релизов в графиках дежурств и планировании нагрузки, а давление в пользу открытой телеметрии инференса и формализованных SLA вырастет.
Почему это важно для пользователей
После 20:00 по Москве 2 октября подписчики всех платных тарифов получили обнулённые счётчики: накопившиеся отложенные задачи в ChatGPT Work и Codex можно дозапустить без покупки кредитов, а докупать лимит накануне сброса не имело смысла. Остаток сообщений проверяется на странице chatgpt.com/codex/settings/usage или командой /status в Codex CLI. Ориентир по объёму: лимиты GPT-6.1 Sol на Plus и стандартных тарифах Business составляют от 15 до 160 сообщений в 5-часовом окне. Реальную скорость модели в своих сценариях лучше проверить собственными замерами, не опираясь только на заявления разработчика.
Что пока неизвестно / ограничения
Заявление о восстановлении штатной скорости GPT-6.1 Sol пока подтверждено только словами руководителя Codex: независимых замеров, перцентилей латентности, доли ошибок или статистики очередей в открытом доступе нет, методика не опубликована. Вывод о том, что раздача квот закрепилась в релизном цикле OpenAI, опирается на четыре случая за два месяца — выборка небольшая, и неизвестно, сколько запусков прошло без сбросов и как распределялась нагрузка по дням. Неясно и то, будет ли OpenAI заранее анонсировать будущие компенсационные окна: пока механика остаётся жестом доброй воли без публичных SLA.
Источники
- Thibault Sottiaux (@thsottiaux) on X: usage limits reset for all paid ChatGPT accounts
- ChatGPTの“利用制限”リセットへ 有料ユーザー向け — ITmedia AI+
- Codex: Usage Reset Time Announced by Tibo for All Paid Plans — SmartScope
Автор
Look at AI, редакция