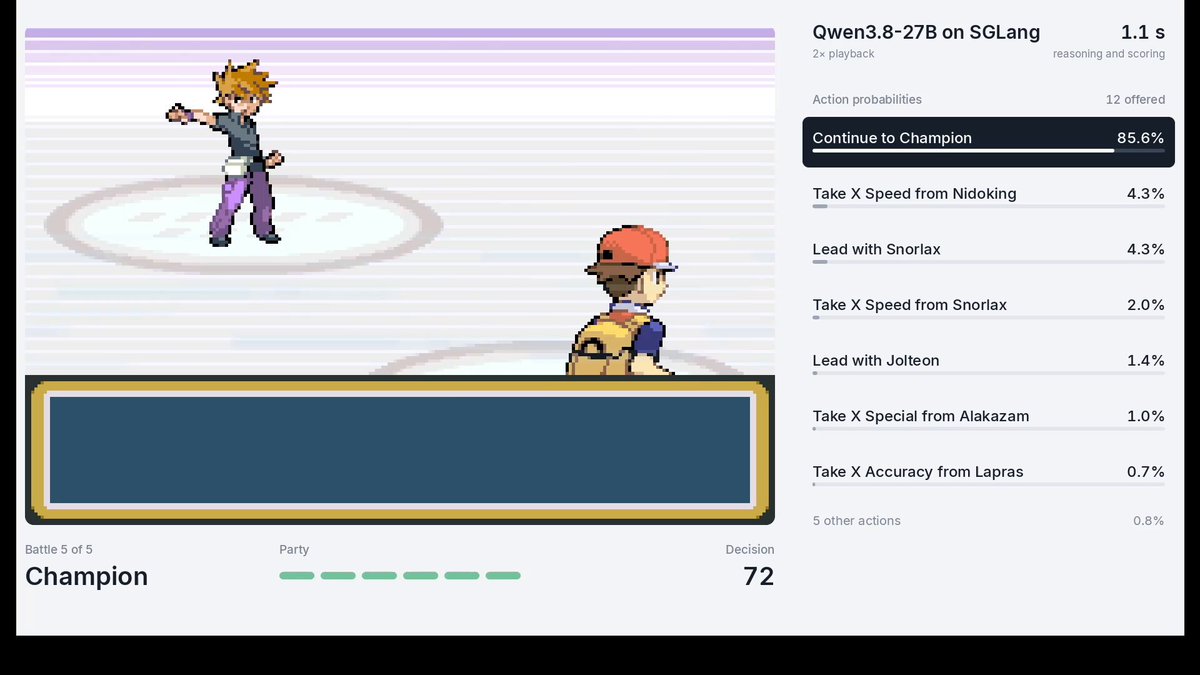
В открытом движке инференса SGLang появились эндпоинты /v1/decisions и /v1/systemone: обычная чат-модель отвечает в них не текстом, а вероятностями — выбором из вариантов, оценкой по шкале или ответом «да/нет». Правки были приняты в репозиторий 24 и 25 сентября 2026 года, до ближайшего стабильного релиза функция доступна в nightly-сборках. Фактически любой уже развёрнутый на SGLang сервер можно использовать как вероятностный классификатор без отдельной классификационной модели, хотя значения в ответах пока не откалиброваны, поэтому пороги решений придётся настраивать на собственной размеченной выборке.

Что произошло
Правка PR #40992 с эндпоинтом /v1/decisions создана в репозитории SGLang 24 сентября 2026 года. На следующий день, 25 сентября, в ветку main влит PR #41208 (коммит 16d1c93b) с маршрутом /v1/systemone, совместимым с API TypeSafe; до ближайшего релиза обе функции доступны только в nightly-сборках. Механика устроена так: движок рендерит вопрос через chat-шаблон модели с выключенным блоком «мышления», проставляет однотокенные метки и по лог-вероятностям следующего токена считает софтмакс с учётом temperature. Набор меток зависит от формата задачи: буквы A–Z для выбора из 2–26 вариантов, двухбуквенные AA/AB и далее до 255 вариантов в System One, цифры 0–9 для шкалы из 2–10 уровней и пара yes/no для вопроса «да/нет». Вместе с распределением в ответе хранится label_mass — доля вероятностной массы, пришедшаяся на метки. Работу связки показали и на живом примере: в опубликованном 30 сентября 2026 года видео модель Qwen3.8-27B проходит Pokémon FireRed, принимая решения через /v1/decisions быстрее 100 миллисекунд.
Контекст
Сам по себе приём известен давно: классификация по софтмаксу лог-вероятностей следующего токена с однотокенными метками — стандартный метод verbalizer-промптинга из исследований больших языковых моделей. Раньше его приходилось собирать вручную поверх обычной генерации: сгенерировать строку, распарсить ответ, следить, чтобы метка укладывалась в один токен, и подавлять блок рассуждений. Новизна здесь инжиниринговая: пайплайн вероятностной классификации впервые вынесен на уровень инференс-сервера рядом с уже существующими /v1/score и /v1/rerank. Показательна и внешняя совместимость: маршрут /v1/systemone повторяет API сервиса System One компании TypeSafe AI с проприетарной моделью Jev, то есть SGLang позиционируется как открытая замена закрытого интерфейса. Наконец, подход построен как stateless-классификация: обрабатывается один вход без истории диалога, поэтому любое состояние, подобное игровому прогрессу в демо с Pokémon FireRed, нужно целиком сериализовать в единственный промпт.
Почему это важно для индустрии
Для индустрии это изменение самой оптики: инференс-движки больше не конкурируют только скоростью генерации. SGLang забирает на уровень сервера нетривиальную часть работы — рендеринг промпта через chat-шаблон, гарантию однотокенности метки и подавление блока рассуждений, — которую раньше каждая команда собирала своими силами. Возникает новый класс эндпоинтов, где модель отдаёт не строку, а распределение вероятностей: классификация, маршрутизация, скоринг и guardrails по состоянию приложения выполняются синхронным запросом за миллисекунды, без отдельных классификационных чекпойнтов и без парсинга свободного текста. Совместимость с System One API TypeSafe AI превращает любой SGLang-сервер в открытую замену проприетарного API Jev, что удешевляет перенос уже написанных клиентов. Поскольку приём с однотокенными метками тривиально воспроизводим, логично ожидать аналогичных «решающих» эндпоинтов у других движков, включая vLLM; тогда конкуренция сместится к стандартизации формата API и инструментам калибровки, а LLM-классификация как отдельная платная фича начнёт коммодитизироваться.
Почему это важно для пользователей
Читателю, который уже обслуживает модели через SGLang, ничего дополнительно развёртывать не нужно: достаточно nightly-сборки и запроса к /v1/decisions с набором вариантов или бинарным вопросом. Отдельный reward- или классификационный чекпойнт под такие задачи обучать не требуется — работает та же модель, что отвечает в чате. Готовые клиенты TypeSafe SDK (пакет typesafe-sdk, устанавливается командой pip install typesafe-sdk) подключаются к собственному серверу заменой base_url, поэтому существующие интеграции с API TypeSafe переносятся без переписывания кода. Типовые сценарии — триаж тикетов, маршрутизация запросов между моделями и простые guardrails в собственных проектах. Рекомендуемый в документации порядок внедрения: разметить выборку, зафиксировать temperature и откалибровать пороги под свои задачи.
Что пока неизвестно / ограничения
Главный методологический нюанс в том, что вероятности не откалиброваны: значения гуляют до 0,07 между холодным запросом и запросом из префиксного кэша, а софтмакс пропущен через temperature, поэтому пороги решений валидны только на своей размеченной выборке и при фиксированных настройках. Работоспособность зависит и от токенизатора конкретной модели: метка обязана умещаться в один токен в позиции ответа, откуда и следуют упомянутые выше ограничения на число вариантов и уровней шкалы. Связку пока проверяли на паре моделей семейства Qwen, а стабильного релиза ещё нет, так что для продакшена пока рано, тогда как для пилотов функцию уже можно брать. Цифра «менее 100 миллисекунд» взята из одного демонстрационного видео с Qwen3.8-27B и Pokémon FireRed: распределения задержек, данных о точности выборов и сравнения с базлайном «сгенерировать строку и распарси» не приводятся. Наконец, правка PR #41922 с приёмом изображений ещё не влита, так что мультимодальный вход пока не подтверждён кодом в main-ветке.
Источники
- SGLang Docs — раздел Decision models (/v1/decisions и /v1/systemone)
- SGLang PR #40992 — код эндпоинта /v1/decisions (создан 24.09.2026)
- [SGLang PR #41208 «[feat] add a system one compatible /v1/systemone route» (влит 25.09.2026)](https://github.com/sgl-project/sglang/pull/41208)
- SGLang (@sgl_project) на X — демо Qwen3.8-27B в Pokémon FireRed (30.09.2026)
Автор
Look at AI, редакция