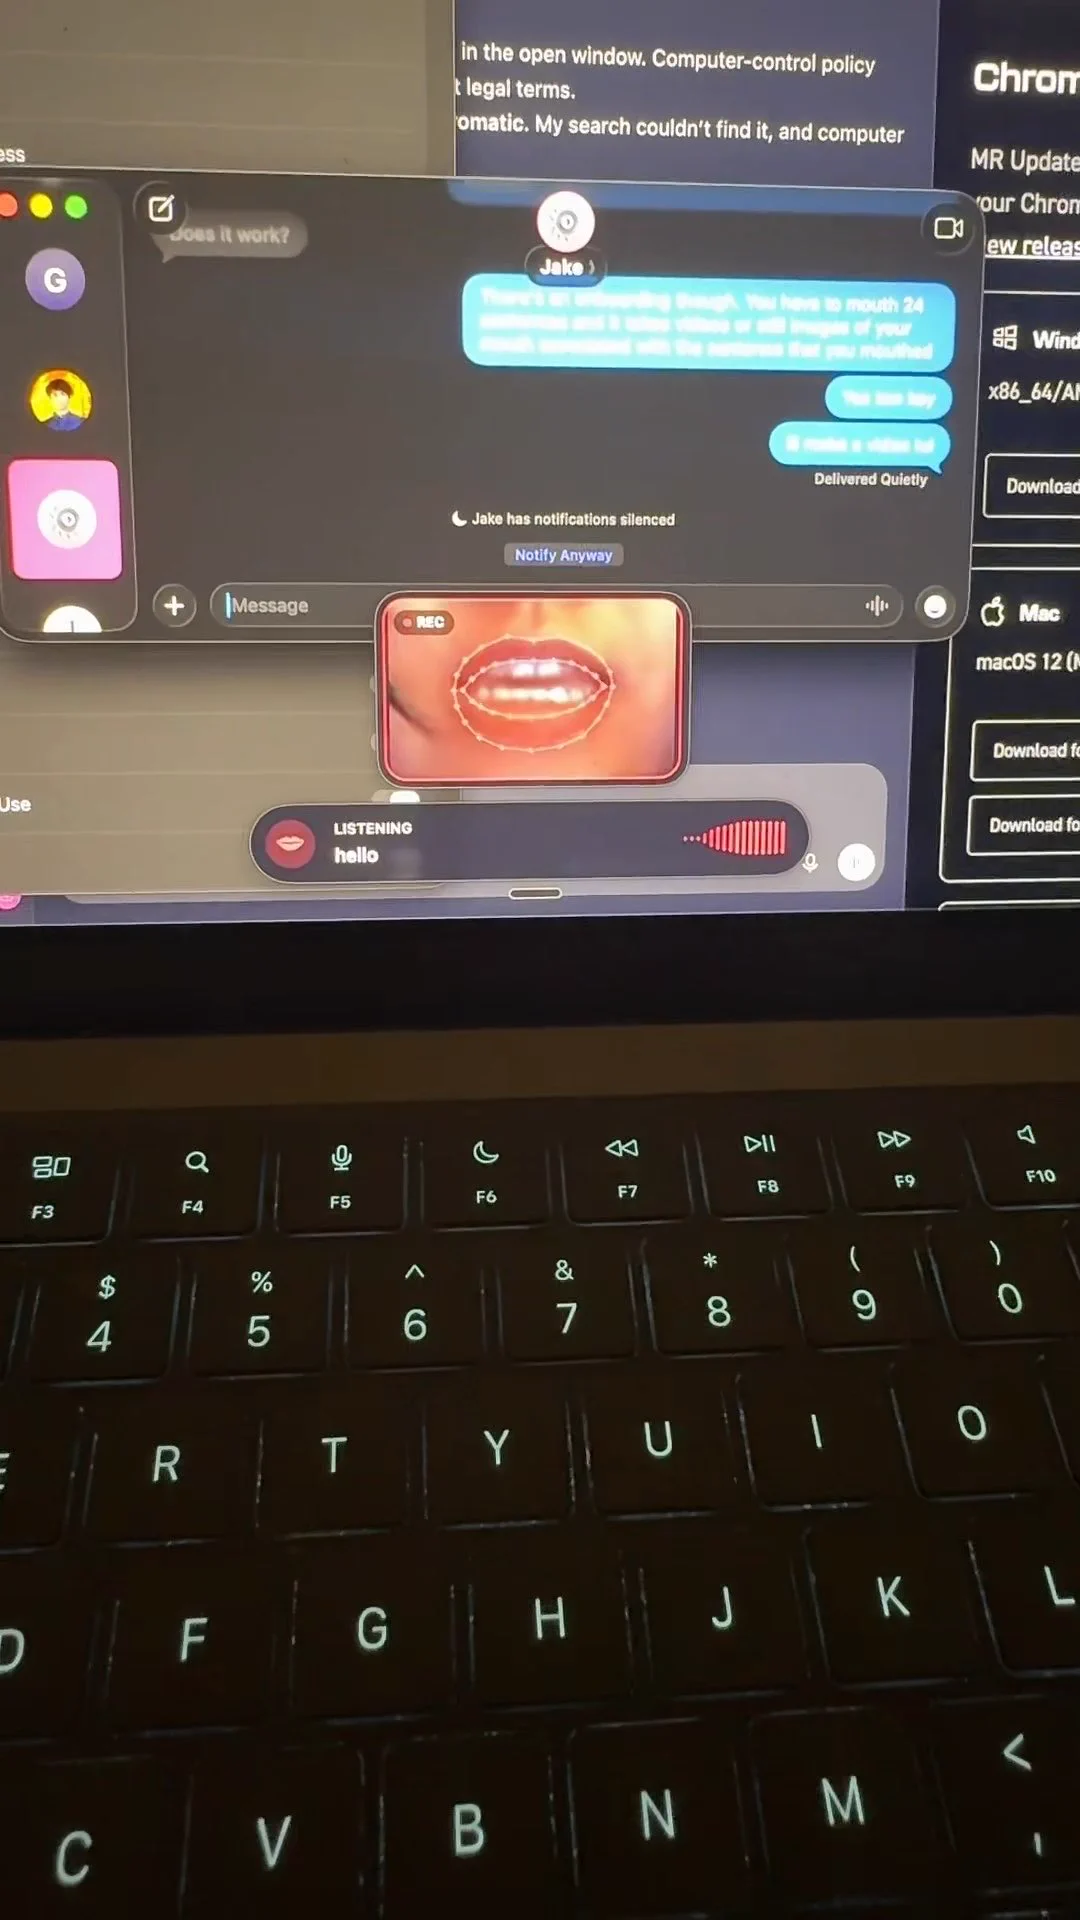
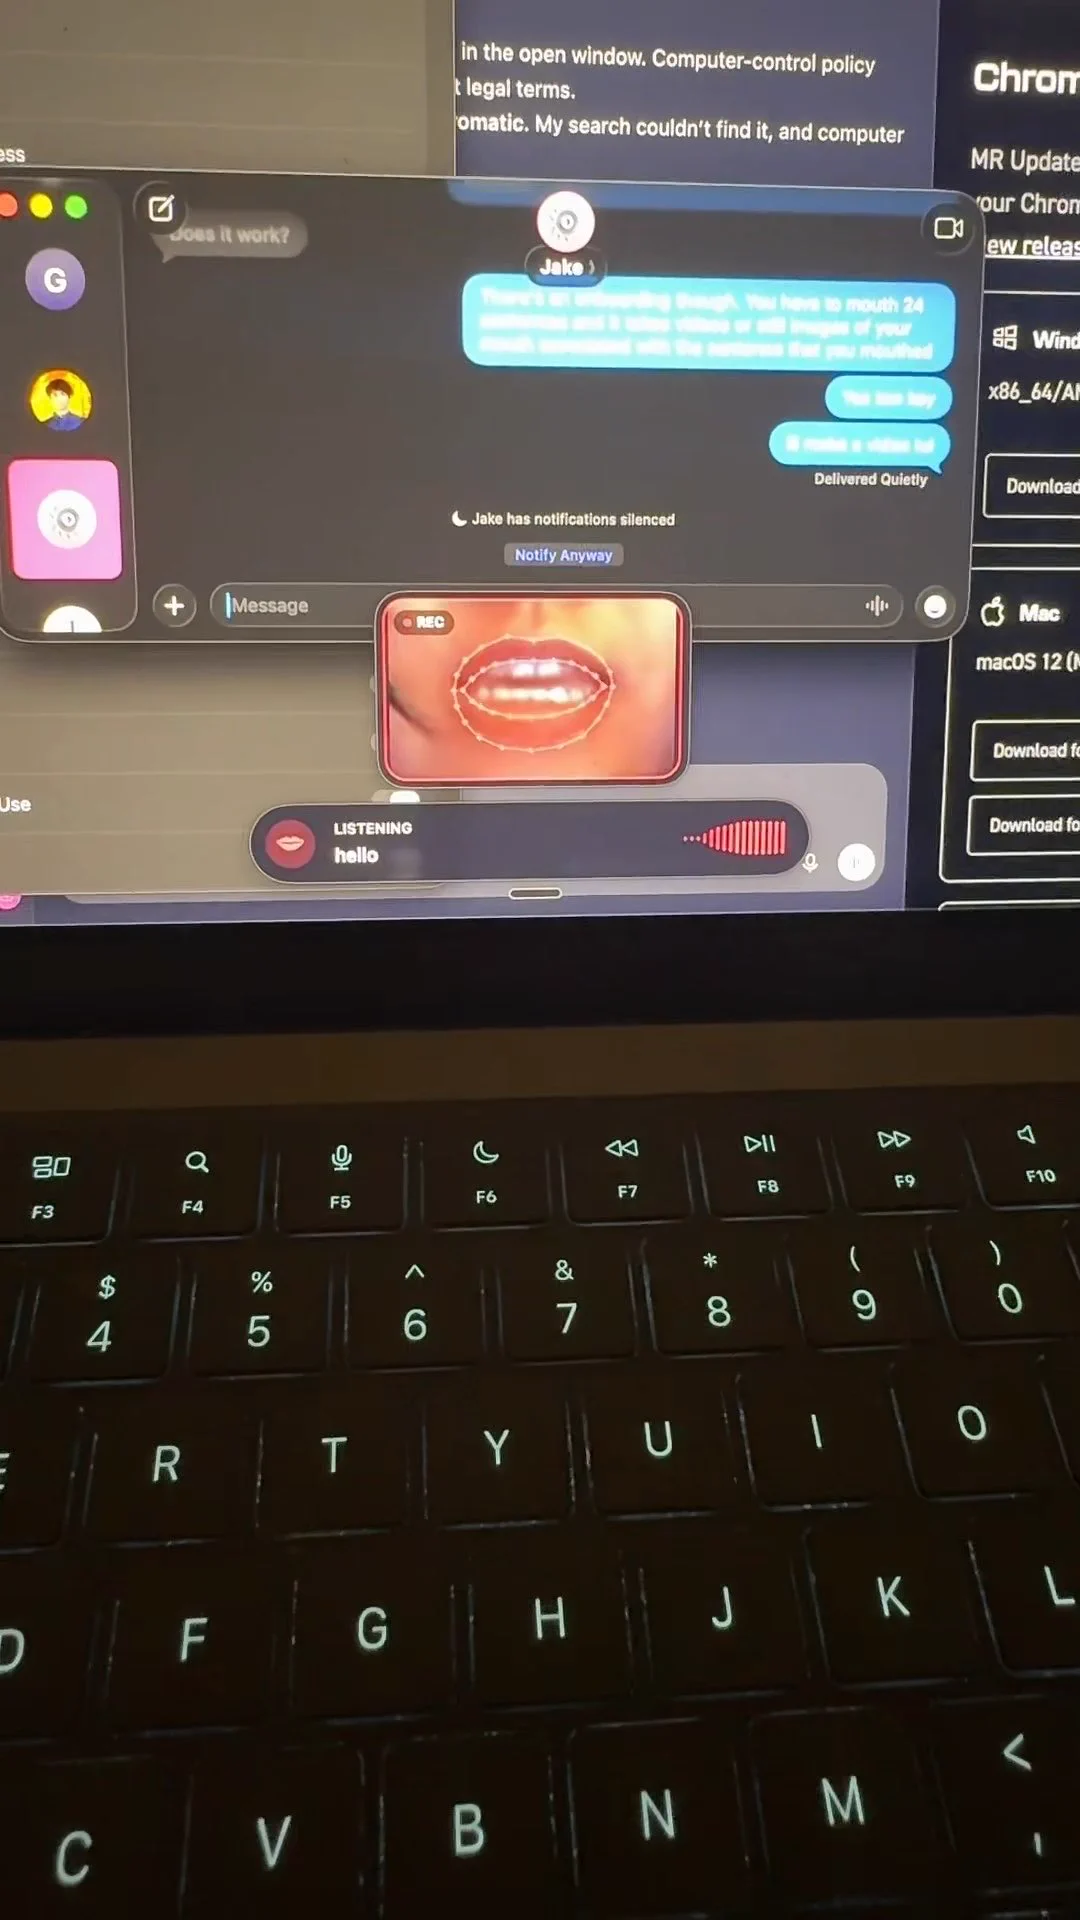
Разработчица под ником amypretzel в октябре 2026 года выложила в открытый доступ Lipflow — приложение для Mac на Apple Silicon, которое печатает текст, пока пользователь беззвучно проговаривает фразы перед веб-камерой. Вся обработка, от чтения по губам до языковой постобработки, выполняется на самом устройстве, если только для финальной правки текста не включить облачную модель. По уровню зрелости это research-работа, а не продукт: у текущей версии есть конкретные ограничения по языку и точности.
Что произошло
О проекте amypretzel рассказала постом на X (Twitter), а GitHub-репозиторий amywork777/lipflow создан 30 сентября 2026 года и распространяется под лицензией MIT. Сценарий работы такой: пользователь удерживает правый Option, беззвучно артикулирует фразу, веб-камера снимает движения губ, и распознанный текст вставляется в позицию курсора. Внутри конвейер из готовых компонентов: MediaPipe FaceLandmarker вырезает кадры рта размером 96×96 на частоте 25 fps, их обрабатывает модель визуального распознавания речи Auto-AVSR, затем локальный beam search уточняет результат. Финальную правку выполняет языковая модель: по умолчанию claude-opus-5-5, но доступны локальный Qwen3-0.6B 4-bit через MLX (около 350 МБ), модель через Ollama (qwen3:4b) либо офлайн-правила. На M4 Pro текст появляется быстрее, чем за пару секунд.
Контекст
Научной новизны в Lipflow нет: проект собран из существующих открытых компонентов, но именно как инженерная сборка он ценен, потому что показывает, что чтение по губам с персонализацией на устройстве уже работает на потребительском Mac. Auto-AVSR — известная модель аудио-визуального распознавания речи, обученная на датасете LRS3, и на тестах с озвученной речью она достигает 19,1% WER (word error rate). Ключевой нюанс в распределении ошибок: на беззвучном протараторивании точность деградирует примерно до 31,9% WER, тогда как гибридный режим Auto-AVSR «губы плюс аудио» с тихим шёпотом снижает ошибку до 6,9%. Вторая ключевая идея — локальная персонализация: при первом запуске нужно беззвучно произнести 24 предложения, после чего лип-ридер дообучается под ваше лицо, языковая модель — под вашу манеру речи, и всё это считается на GPU Mac.
Почему это важно для индустрии
Для индустрии это рабочий контрпример к тезису, будто визуальное распознавание речи и персональное дообучение моделей на устройстве остаются лабораторной историей: конвейер MediaPipe, Auto-AVSR и локального beam search собирается и работает на обычном потребительском Mac. Паттерн «короткая калибровка под пользователя плюс локальная языковая модель плюс импорт истории диктовки» — готовый рецепт персонализации для инструментов диктовки: Wispr Flow здесь используется напрямую, Lipflow подтягивает его локальную историю, чтобы лучше угадывать фразы и имена. Строить на проекте бизнес нельзя: веса модели из LRS3 разрешены только для некоммерческого использования, монетизации в Lipflow нет. Ценность для команд — в самой схеме локальной персонализации, которую теперь можно клонировать и изучать.
Почему это важно для пользователей
Если у вас Mac на Apple Silicon с macOS 13 или новее, проект проверяется бесплатно за один вечер: git clone, затем ./setup.sh, который скачивает примерно 1,2 ГБ моделей, и около восьми минут калибровки. Дальше вы удерживаете клавишу, беззвучно артикулируете фразу — и текст печатается в позиции курсора. Честные ожидания: распознаётся только английский, а чисто беззвучный режим автор сама признаёт нестабильным, оценивая точность как «50 на 50», поэтому практичнее всего гибридный режим с тихим шёпотом, где результат заметно надёжнее.
Что пока неизвестно / ограничения
Все цифры точности — авторские: независимых замеров WER и проверки на разных пользователях до и после калибровки в проекте нет, поэтому реальный выигрыш от персонализации не измерен. Отдельный риск — связка с языковой моделью: она может превращать неуверенные гипотезы лип-ридера в правдоподобный, но неверный текст, потому что снижение ошибок относительно машинной расшифровки не равно снижению ошибок относительно намерения говорящего. Наконец, показания точности получены в авторской демонстрации, и как конвейер ведёт себя в других сценариях у других пользователей, пока неизвестно.
Источники
- GitHub-репозиторий Lipflow (amywork777/lipflow)
- Пост @amypretzel на X (Twitter) о приложении Lipflow для диктовки по движению губ
Автор
Look at AI, редакция