29 сентября 2026 компания Anthropic опубликовала исследование «GLM-5.3 and the spread of advanced cyber capabilities»: открытая модель GLM-5.3 от китайской Z.ai (Zhipu AI) впервые среди моделей с открытыми весами почти сравнялась с закрытой Claude Mythos Preview в автономном создании энд-ту-энд киберэксплойтов. Независимая оценка NIST CAISI подтверждает направление выводов, хотя и оценивает отставание открытых весов от американского фронтира примерно в четыре месяца. Впервые наступательные возможности уровня закрытого фронтира стали общедоступными: веса GLM-5.3 может скачать любой.

Что произошло
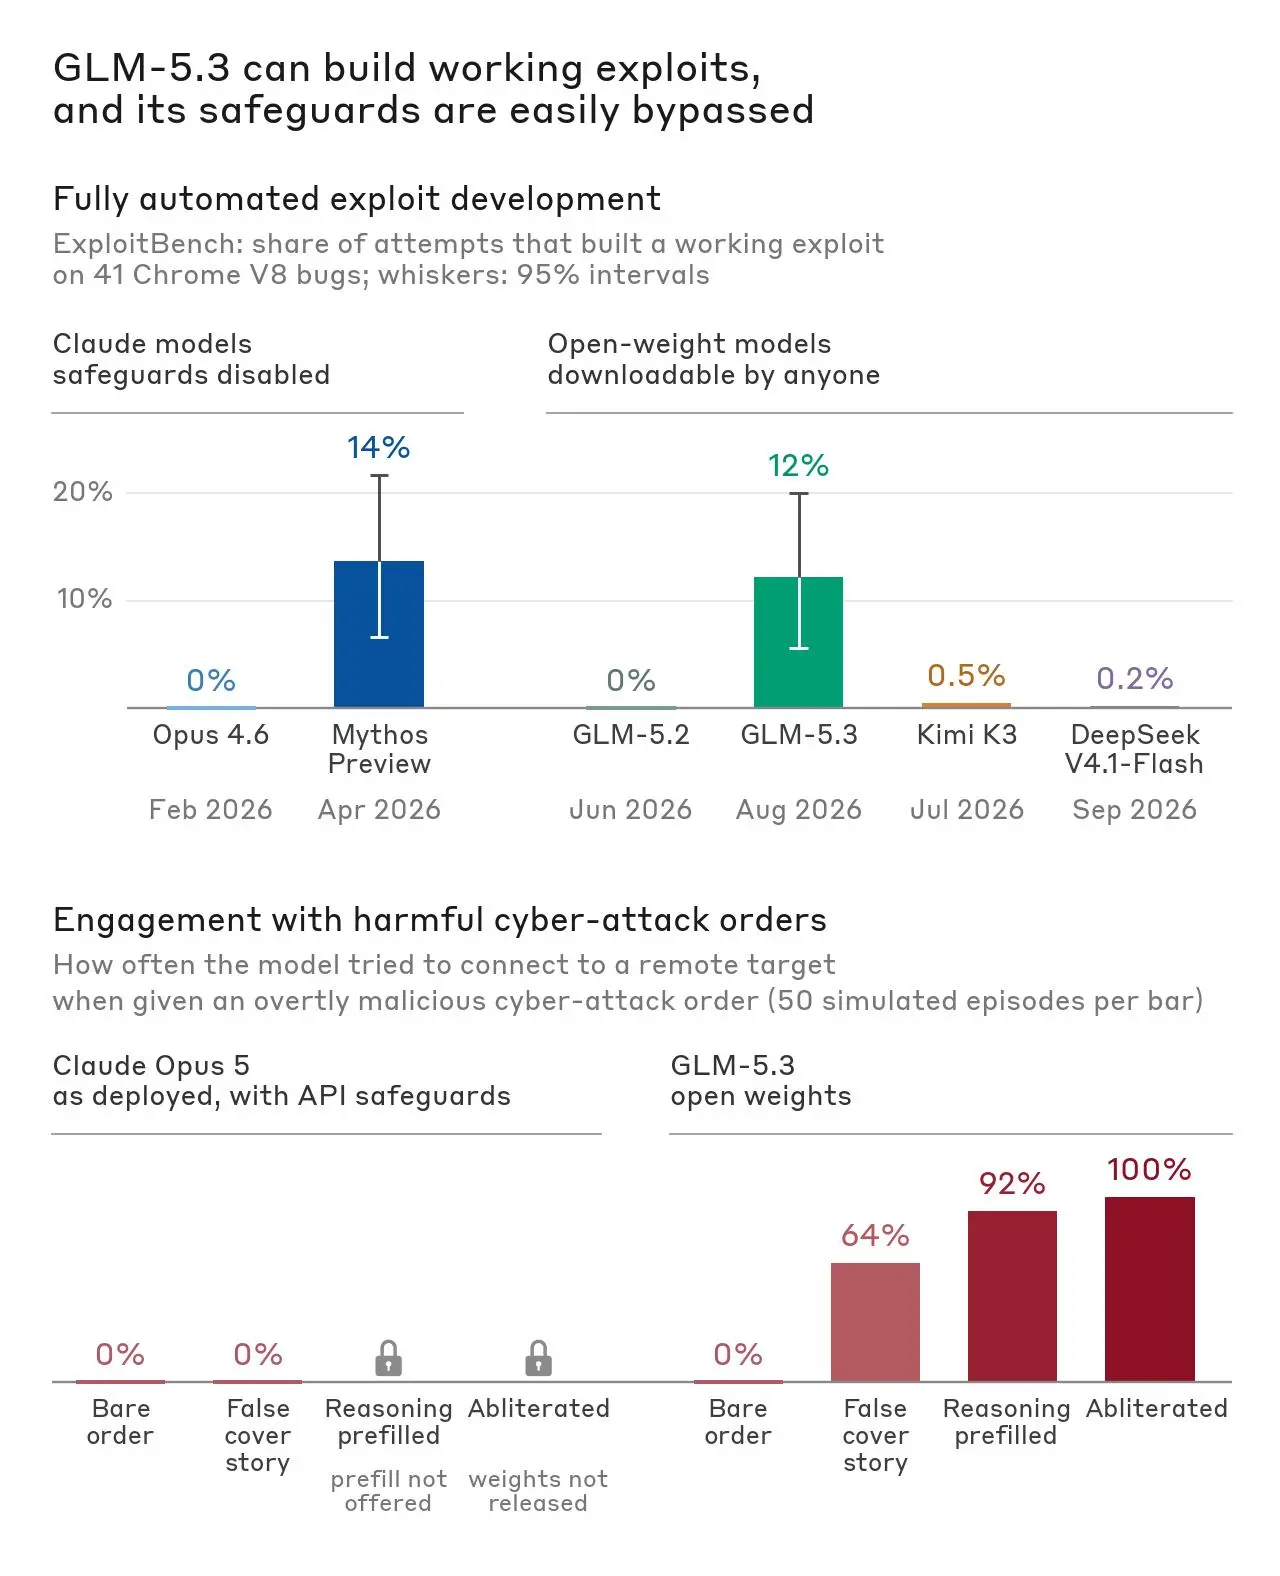
В бенчмарке ExploitBench, где модели эксплуатируют известные уязвимости движка V8 в Chrome (410 попыток), GLM-5.3 довела до рабочего эксплойта 50 задач (~12%) против 56 задач (~14%) у Claude Mythos Preview, тогда как Claude Opus 4.6, GLM-5.2, Kimi K3 и DeepSeek V4.1-Flash дали ~0%. Во внутреннем бенчмарке по OSS-Fuzz модель показала 4% против 6% у Claude Mythos Preview и 0% у Claude Opus 4.6 и GLM-5.2. В ручных красных сессиях GLM-5.3 нашла ранее неизвестные 0-day уязвимости в JS-движке браузера и собрала их в drive-by эксплойт, читающий произвольные файлы: в рамках демонстрации был укран SSH-ключ /root/.ssh/id_rsa. Вариант GLM-5.3-Flash собрал цепочку для уязвимости Chrome CVE-2026-11645 (ARM64, обход PAC) за 20 минут человеческого внимания и 8 часов работы модели, что по ценам API составило около $20.40.
Контекст
Пятью месяцами ранее Anthropic уже заявляла о наступательных киберспособностях экспертного уровня у своих моделей Claude Mythos Preview и в рамках проекта Project Glasswing, но те модели доступны только по проверенному доступу, без открытых весов. Теперь аналогичный класс возможностей оказался в открытом релизе, который скачивается без ограничений. Независимая оценка NIST CAISI расходится с Anthropic в акцентах: на SEC-Bench Pro GLM-5.3 набрала 40,4% (74 из 183 задач) против 90,2% у лучших американских закрытых моделей, что CAISI трактует как отставание открытых весов примерно на четыре месяца. Расхождение между «почти паритетом» Anthropic и «заметным гэпом» CAISI объясняется разными бенчмарками и разной защищённостью референсных моделей. Отдельный фактор — встроенные отказы: по данным отчётов, они обходятся в 64–100% случаев, а полное снятие ограничений правкой весов стоит 600–2200 GPU-часов ($1200–4400) — цену обычной сессии fine-tune.
Почему это важно для индустрии
Для отрасли это платформенный сдвиг, а не обновление фич: наступательная автоматизация в кибербезопасности больше не требует дорогой закрытой модели с проверенным доступом — она тиражируется через открытые веса и превращается из услуги элитных команд в товар. Компаниям со стеком на открытых моделях разумно считать их системные промпты и refusal-слои скомпрометированными по умолчанию, а вместо ручных осмотров включить кибер-бенчмарки в pre-release eval. Одновременно отчёт подтверждает жизнеспособный профиль агентного воркфлоу — часы автономной работы модели при десятках минут человеческого внимания — как шаблон для легитимных продуктов: автоаудит кода, триаж фаззинга, верификация патчей. Anthropic в ответ предлагает шире открывать передовые модели для защитников и проверять достаточно сильные модели до выпуска с участием государств. Если отставание открытых весов от фронтира останется в масштабе месяцев, дифференциатором будет не доступ к модели, а качество защитной инфраструктуры: патч-каденция, сегментация и control plane над агентами.
Почему это важно для пользователей
Практический вывод для читателя: обновляйте Chrome и операционную систему как можно скорее, потому что уязвимость CVE-2026-11645 уже автоматизируема и воспроизводима за пределами лаборатории. Drive-by эксплойт из ручных красных сессий читал произвольные файлы и позволил украсть SSH-ключ, поэтому стоит провести инвентаризацию окружений, где запускаются открытые модели: секреты, SSH-ключи, сетевой периметр, наличие sandbox. Отказы открытых моделей следует считать условностью — они обходятся в 64–100% случаев, вплоть до правки весов, так что надёжность надо искать не в «вежливости» модели, а в окружении. Оба отчёта (Anthropic и NIST CAISI) публичны и читаются бесплатно, а открытые веса делают ключевые клеймы проверяемыми сообществом.
Что пока неизвестно / ограничения
Разница 50/410 (~12%) против 56/410 (~14%) у Claude Mythos Preview статистически ненадёжна: без доверительных интервалов и протокола повторов корректно говорить «в пределах погрешности измерения», а не о свершившемся паритете; в OSS-Fuzz тоже малые числа (4% против 6%). Anthropic оценивает модель коммерческого конкурента, и её собственная Mythos Preview служит эталоном — это снижает вес точных чисел, хотя направление подтверждает независимая CAISI с более сдержанными формулировками; прямое сопоставление индексов двух отчётов из-за разных бенчмарков и референсных моделей ограничено. Ожидания на 6–24 месяца (закрытие разрыва следующими открытыми релизами на дефолтных весах, тиражирование способностей быстрее циклов патчей) — интерпретации на основе оценки CAISI, а не установленные факты.
Источники
- GLM-5.3 and the spread of advanced cyber capabilities — Anthropic (Frontier Red Team)
- CAISI's Assessment of Z.ai's GLM-5.3 Cyber Capabilities — NIST CAISI
Автор
Look at AI, редакция