Итальянский стартап Paradigma выпустил свою первую модель Limite 1B Violetto — плотный авторегрессионный трансформер на 1 млрд параметров, обученный с нуля менее чем на 300 млрд отобранных токенов за шесть недель. Модель создана исключительно для решения математических задач: на олимпиадных бенчмарках она показывает результат уровня систем в десятки раз крупнее, потратив на обучение заметно меньше вычислений. Веса открыты на Hugging Face под лицензией Apache 2.0 вместе с отдельной value-моделью для оценки рассуждений, но запустить модель можно пока только через vLLM-плагин Paradigma на Linux с NVIDIA GPU.
Что произошло
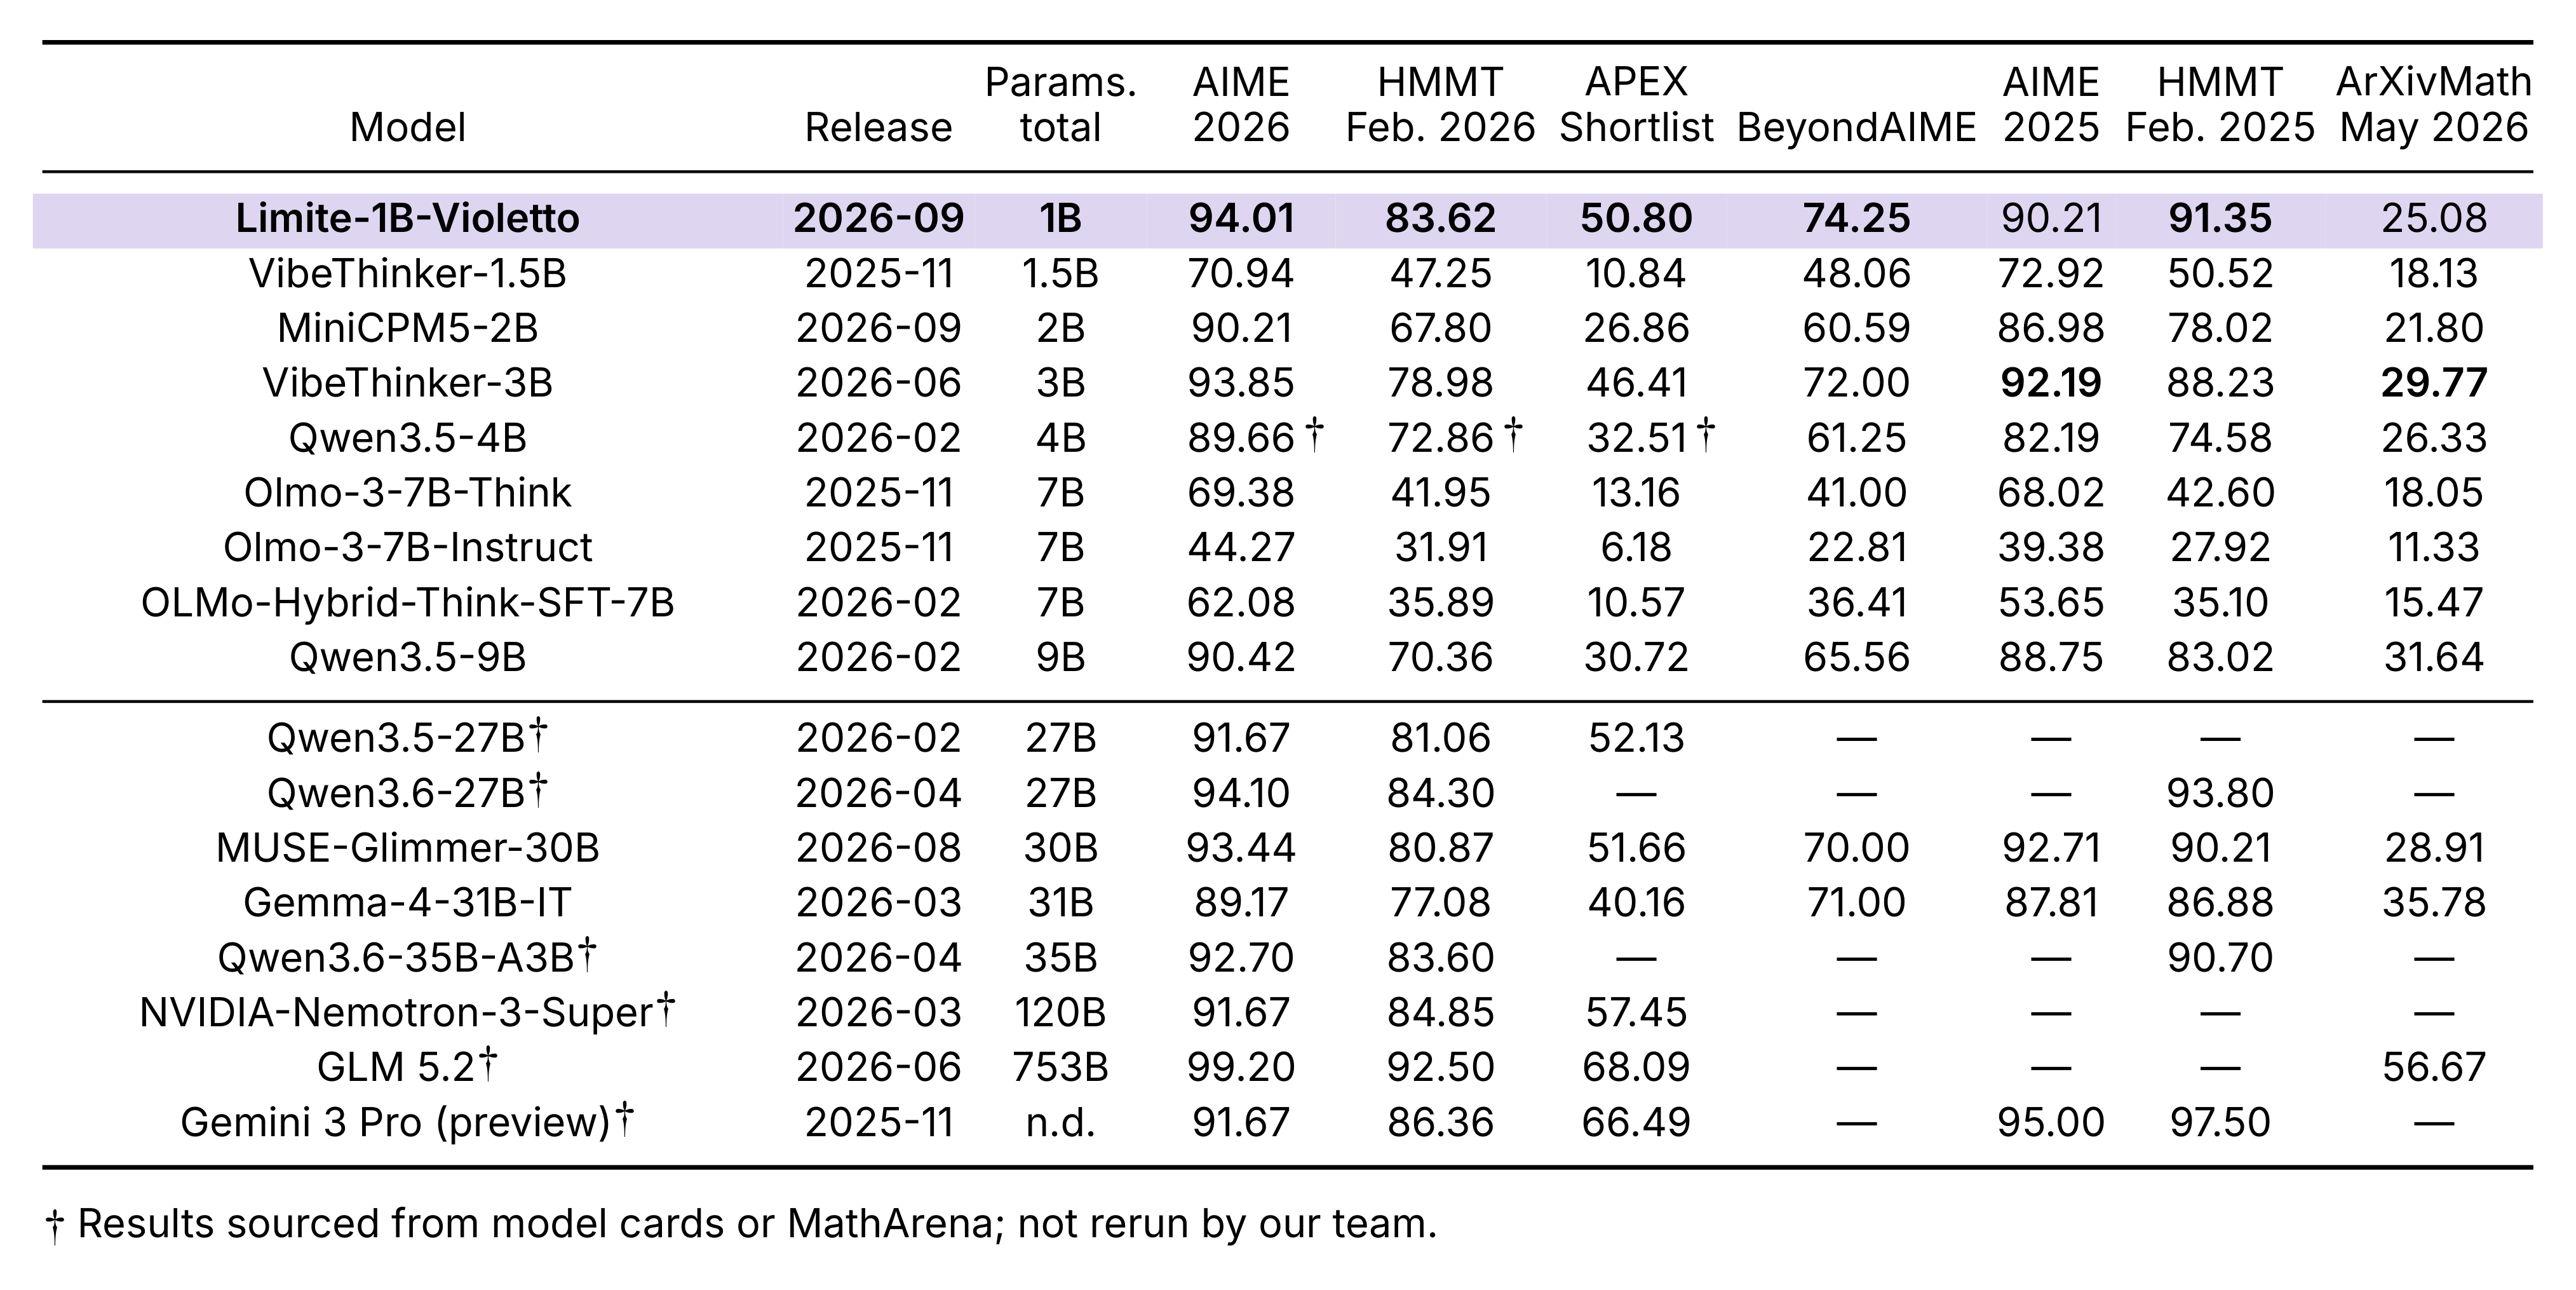
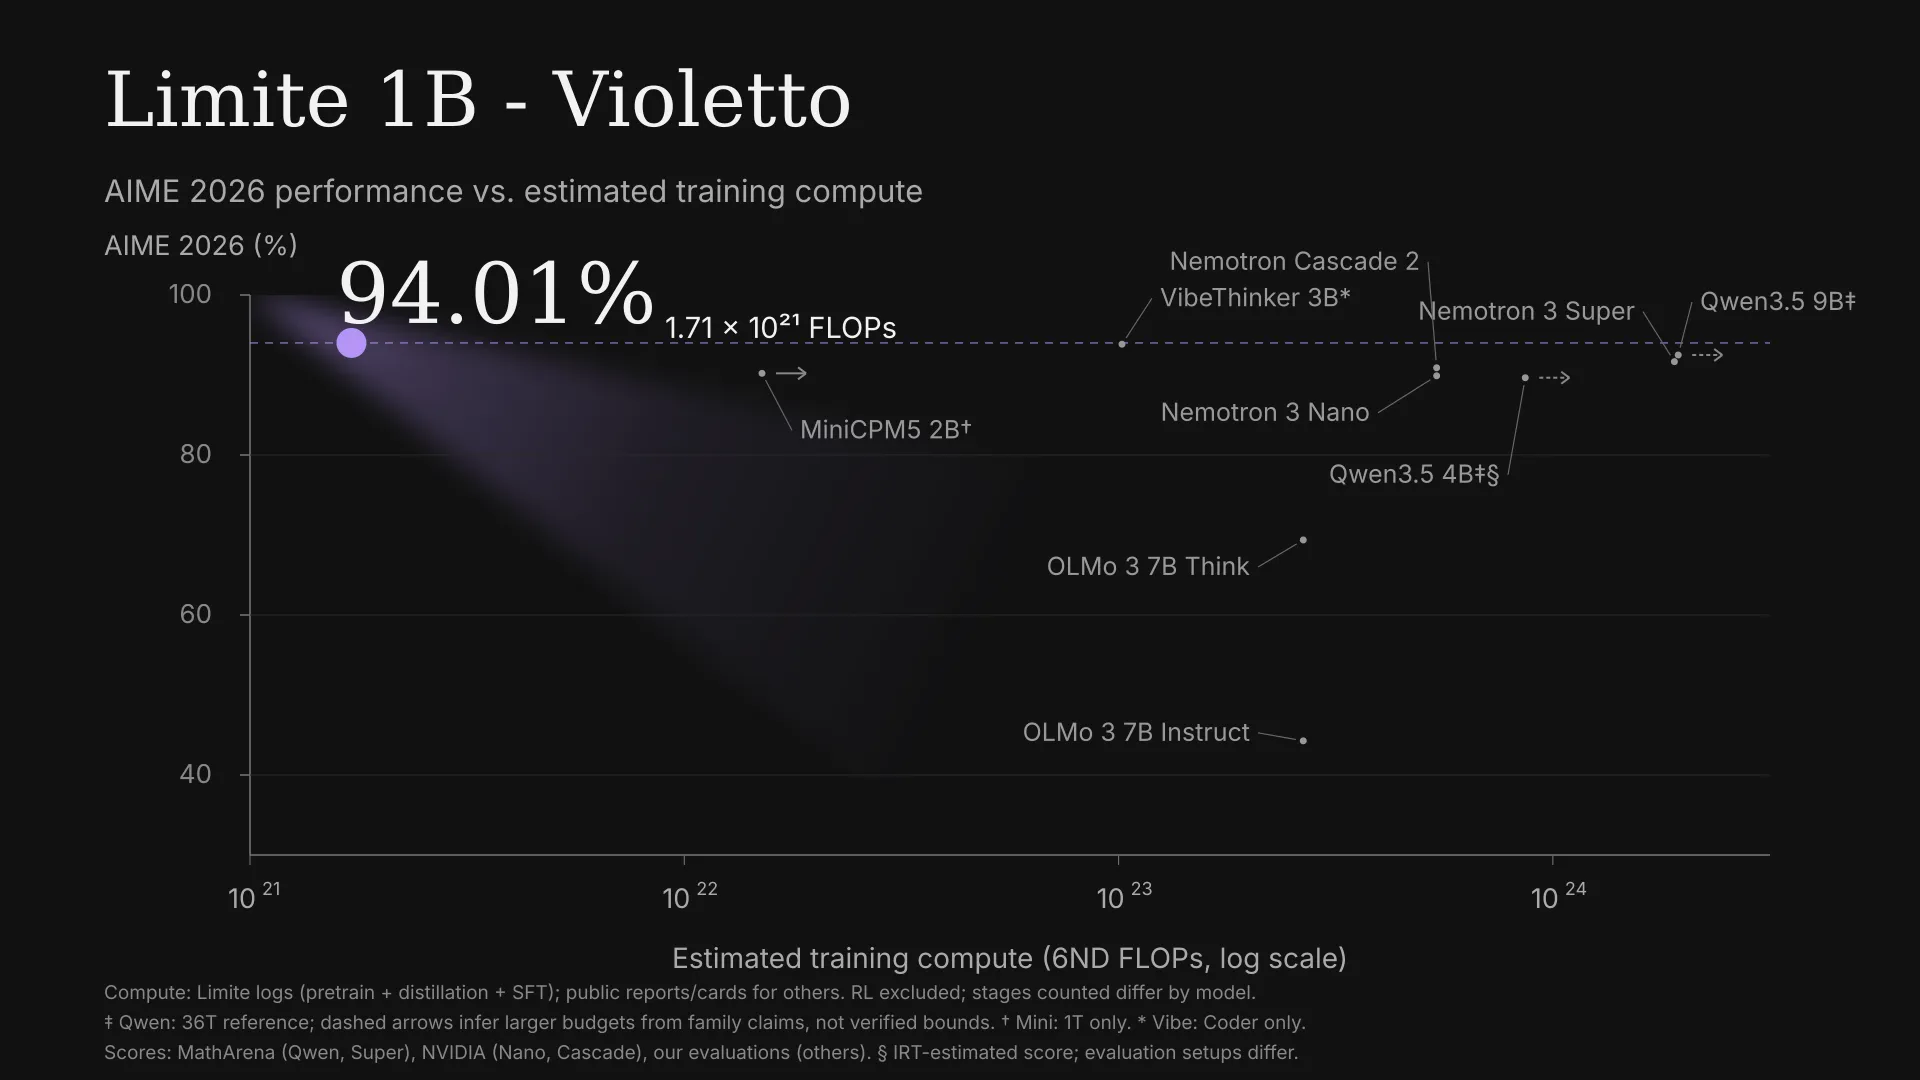
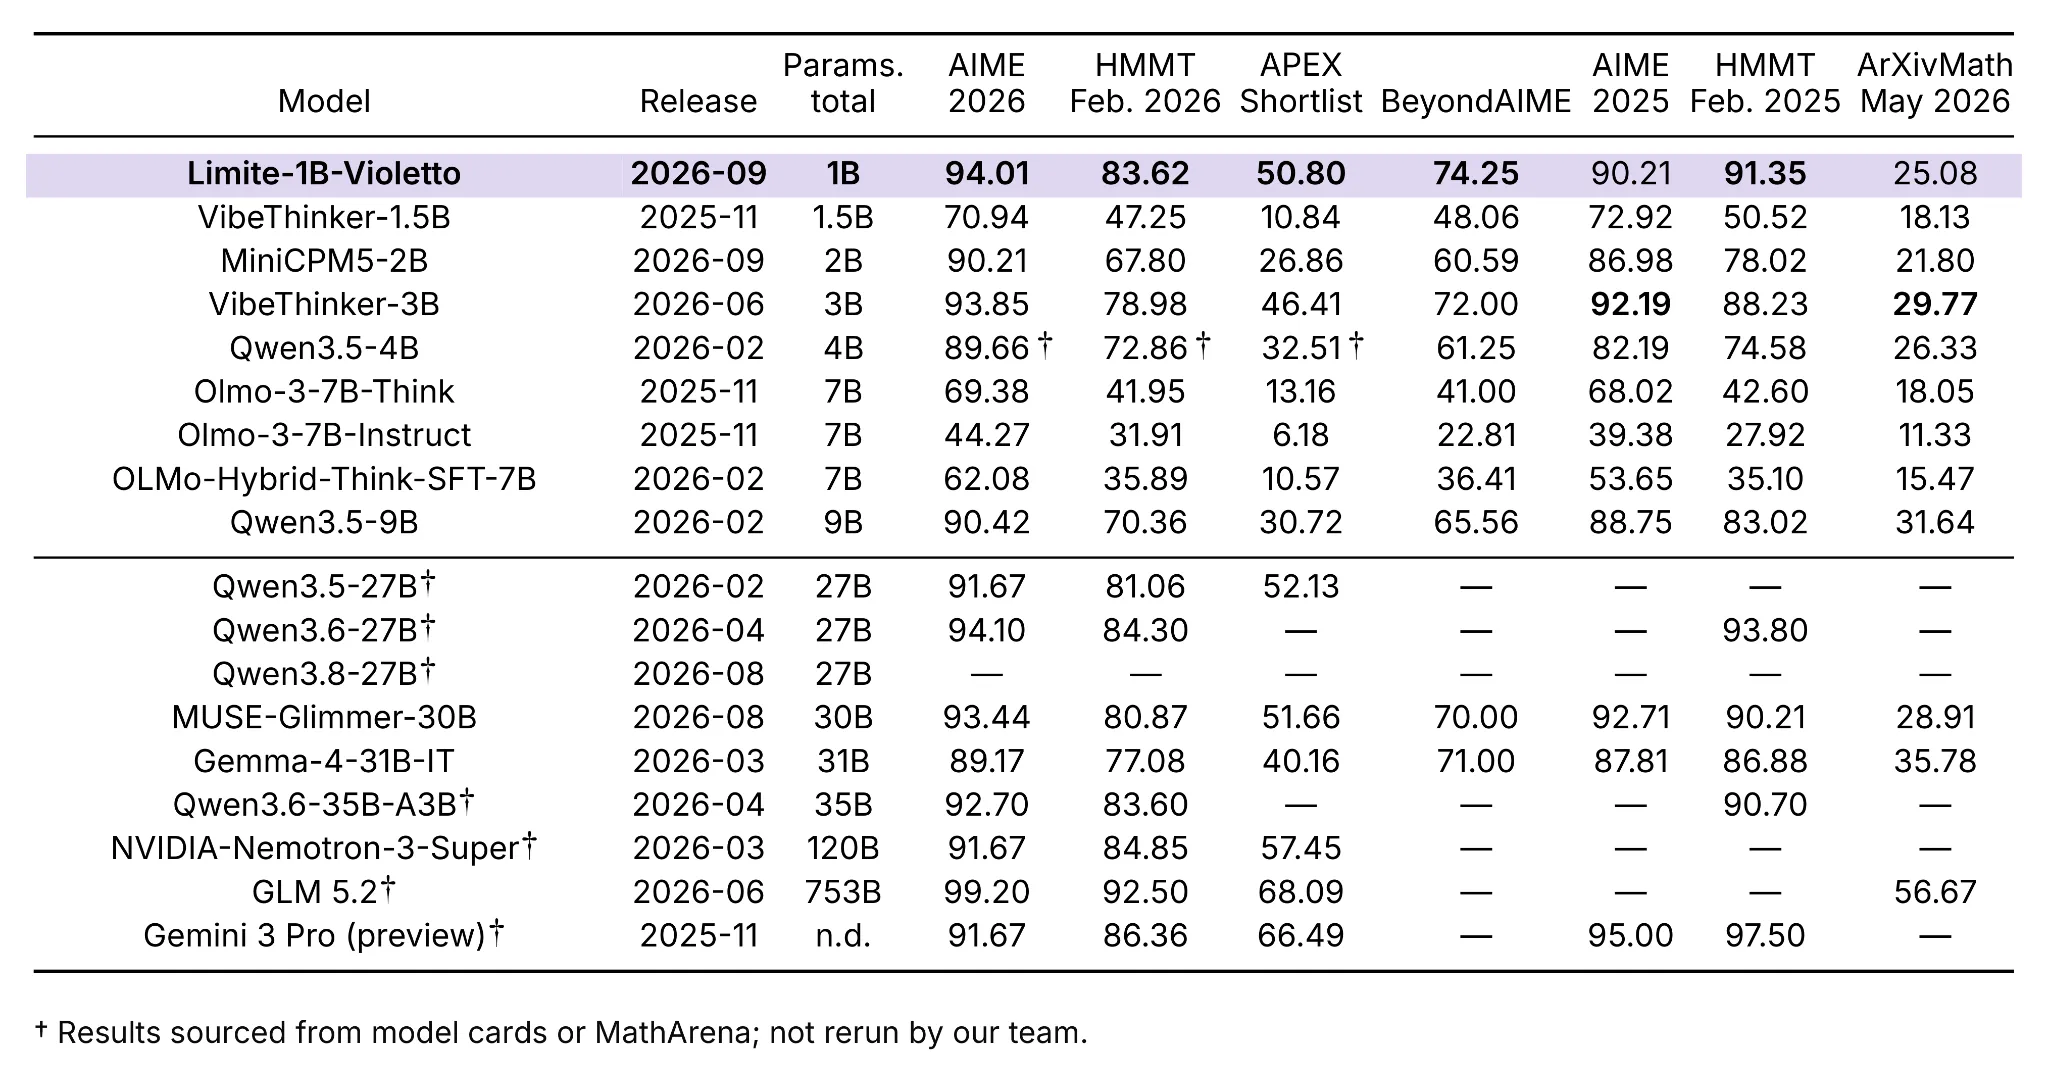
Paradigma опубликовала релизный разбор своей первой модели вместе с весами, модельной карточкой и инструкциями по запуску. Модель имеет контекст до 131 072 токенов; на бенчмарке AIME 2026 она набирает 94,01% при расчётных 1,71×10²¹ FLOPs, а на BeyondAIME — 74,25% против 70% у MUSE-Glimmer-30B. По расчётам компании, такой уровень достигнут при вычислительном бюджете на один–три порядка ниже, чем у моделей той же лиги — Nemotron 3 Super, Qwen3.5 9B, VibeThinker 3B и Nemotron Cascade 2. Вместе с решателем опубликована Limite Value Model на 1,035 млрд параметров, которая для каждого токена ответа выдаёт регрессионную оценку того, ведёт ли рассуждение к верному ответу. Конструктивная особенность релиза: модель намеренно минимально настроена на инструкции и работает в один ход — задача на входе, готовое решение на выходе.
Контекст
Релиз отвечает на давний спор о том, что определяет качество модели — масштаб параметров и вычислений или качество курируемых данных. Ставка Paradigma — «скоростные» (speedrun) подходы к предобучению: короткий цикл обучения на жёстко отобранных токенах вместо долгого прогона на больших корпусах. Минимальная настройка на инструкции здесь не маркетинговая деталь, а фальсифицируемый исследовательский тезис: современная практика исходит из того, что модели нужен ассистентский «режим» для эффективной работы, а Paradigma сознательно строит решатель, который этим режимом не обладает. Математика для такой проверки выбрана не случайно: это верифицируемая доменная область, где правильность ответа проверяется автоматически. Публикация value-модели тоже вписывается в существующий инструментарий индустрии — токен-уровневые критики давно считаются стандартным элементом пайплайнов обучения с подкреплением.
Почему это важно для индустрии
Для отрасли это заявка на эффективность курации, а не масштаба: если заявленные результаты подтвердят независимые проверки, узкая модель, обученная с нуля за шесть недель, достигает уровня крупных универсальных систем на верифицируемом домене, а значит вход в разработку специализированных моделей стоит дешевле, чем принято считать. Отдельный строительный блок для инженеров — связка «однотактовый решатель плюс Limite Value Model с потокеновой оценкой рассуждения» под Apache 2.0: она задаёт шаблон workflow, в котором система генерирует n решений, ранжирует их value-моделью и возвращает лучший. Если рецепт «speedrun-предобучение плюс жёсткая курация данных» воспроизводится в других верифицируемых доменах, рынок может смещаться к роутингу — дешёвым узкоспециализированным малым моделям под оркестрацией больших универсальных. Пока же это сигнал, а не готовый продукт: интеграционная стоимость высока из-за зависимости от плагина Paradigma.
Почему это важно для пользователей
Попробовать модель можно уже сегодня: веса лежат на Hugging Face, инструкции по запуску собраны в GitHub-репозитории Paradigma. Потребуется Linux, NVIDIA GPU с драйвером под CUDA 13.0 и vLLM 0.26.0 через плагин limite, стек зафиксирован на PyTorch 2.11.0; сами веса занимают около 2 ГБ, а на полном контексте 131k модели нужно порядка 7,5 ГБ VRAM. Главное — помнить о её характере: это не чат-бот, а решатель в один ход, поэтому промптом должна быть математическая задача. На обычные вопросы модель нередко отвечает переосмыслением в математику: на просьбу объяснить фотосинтез она рассуждала о делении клетки на две. Практическая ценность для читателя — дешёвый локальный решатель олимпиадной математики, на базе которого вместе с value-моделью уже можно собрать прототип best-of-n-ранжирования. Managed API нет, поддержки Transformers тоже нет — она обещана позже.
Что пока неизвестно / ограничения
Ключевой методологический пробел — отсутствие протокола оценки: в доступных источниках не указано, является ли 94,01% на AIME 2026 одиночным прогоном (pass@1) или результатом связки с value-моделью и отбором кандидатов, нет данных о температуре, числе прогонов и проверке на контаминацию бенчмарка. Все ключевые цифры опубликованы самим вендором, независимых репликаций в источниках нет, а данных о латентности на реальном железе не публиковалось. Limite Value Model оценивает правдоподобие пути к ответу, но не проверяет сами выкладки — на неё нельзя полагаться как на верификатор. Один успешный кейс в одной узкой доменной области не устанавливает scaling-закономерность: обобщения потребуют независимых повторений на других доменах. Наконец, стек пока узок: без поддержки Transformers и альтернативных serving-фреймворков использование в продакшене ограничено связкой vLLM 0.26.0 с плагином Paradigma на Linux и NVIDIA с CUDA 13.0.
Источники
- Limite 1B - Violetto — Paradigma's First Model (release blog)
- paradigma-inc/limite-1b-violetto — Hugging Face model card
- paradigma-inc/limite-violetto — GitHub (vLLM serving plugin)
Автор
Look at AI, редакция