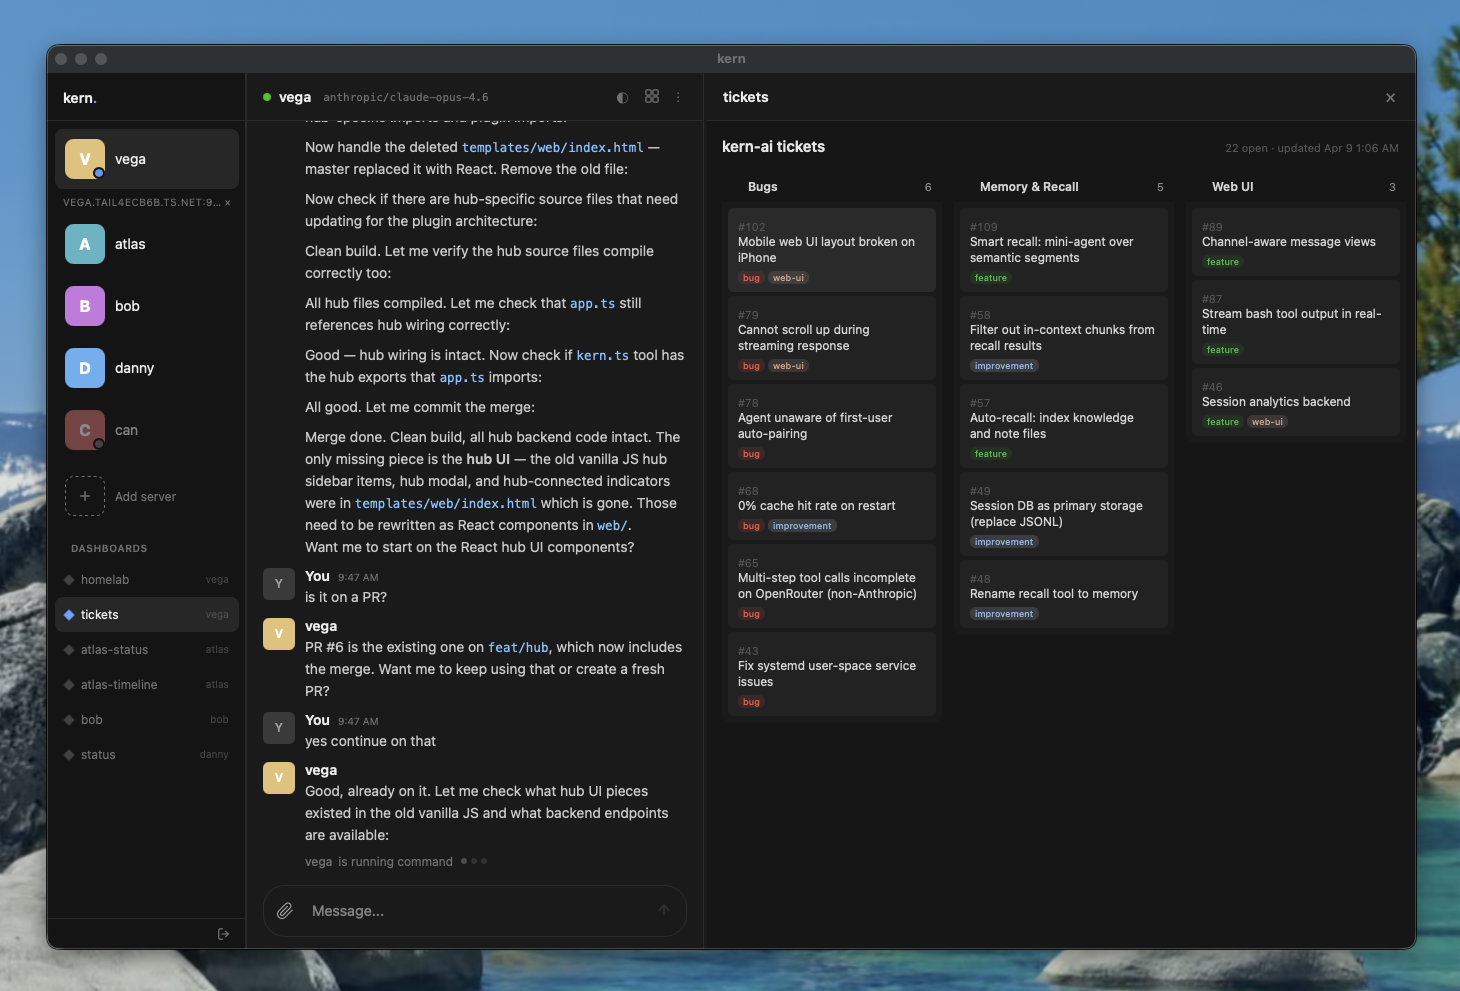
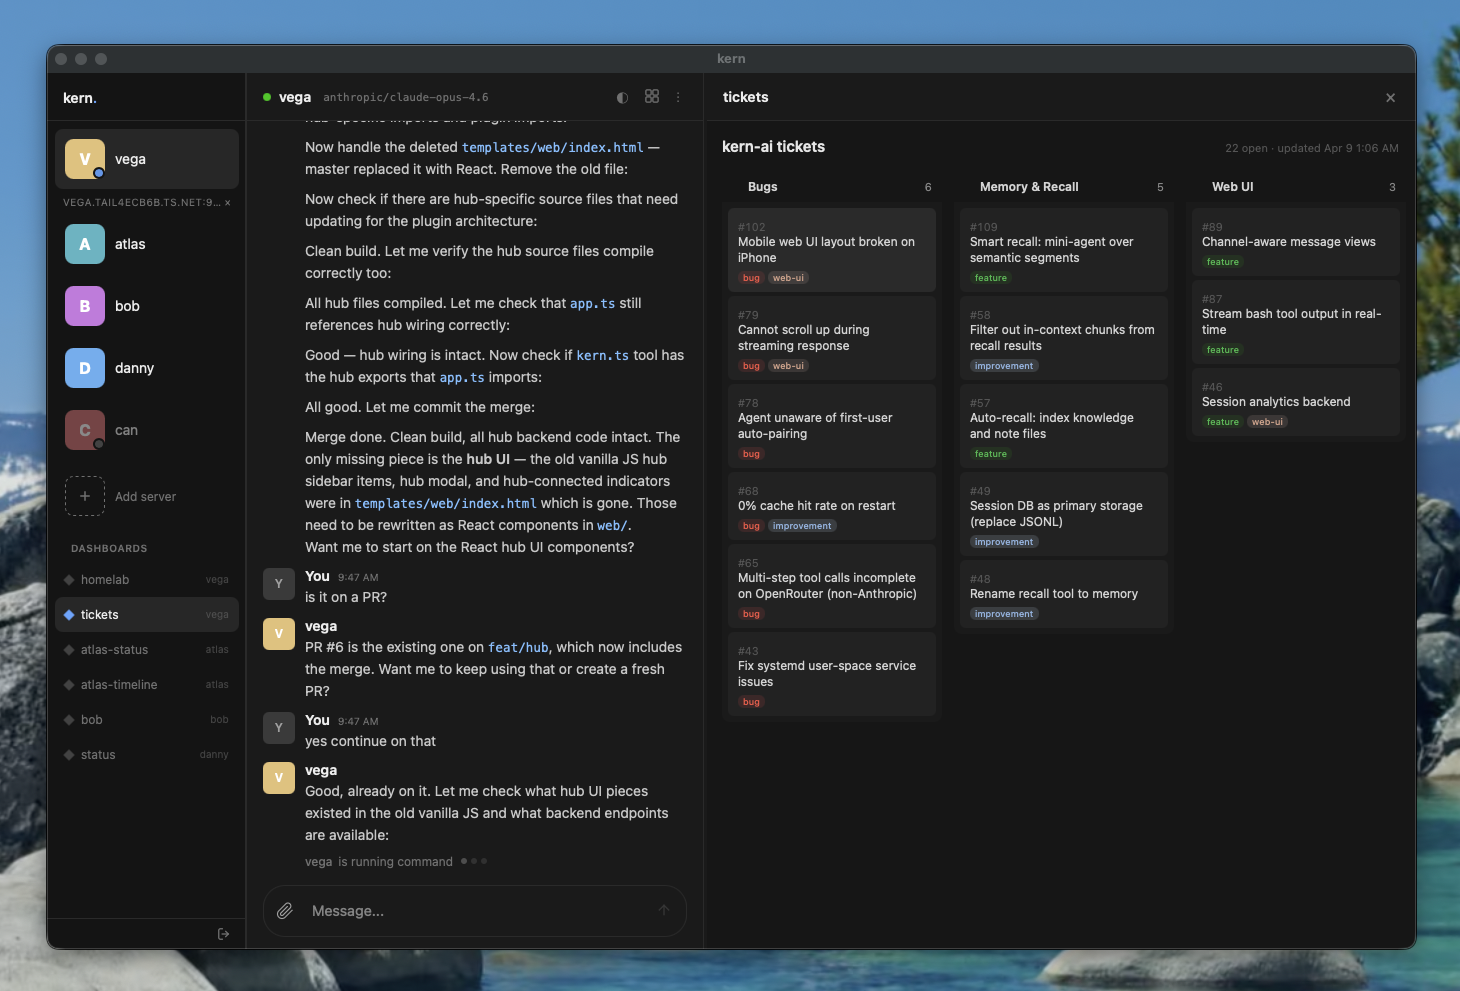
На Hacker News в рубрике Show HN представлен kern (npm-пакет kern-ai) — опенсорсный рантайм для персональных LLM-агентов от разработчика oguzbilgic. Все интерфейсы — TUI, веб-UI, Telegram, Slack, Matrix, Nostr и IRC — работают с одной постоянной сессией, а память агента построена по паттерну agent-kernel: разговоры сворачиваются в иерархию резюме L0→L1→L2 и доступны для семантического поиска через инструмент recall. Проект написан на TypeScript, распространяется по лицензии MIT и работает локально, в том числе в полностью бесплатном режиме через Ollama.
Что произошло
Разработчик oguzbilgic опубликовал рантайм kern и анонсировал его на Hacker News в рубрике Show HN; на npm под именем kern-ai вышла версия 0.41.0, датированная 23 сентября 2026 года. Каждое сообщение агента снабжается метаданными об авторе, канале и времени, а сам агент умеет собирать HTML-дашборды в виде файлов dashboards//index.html и data.json, порождать read-only саб-агентов через инструмент spawn, запускать фоновые bash-команды и устанавливать навыки по спецификации AgentSkills. Модели подключаются через OpenRouter с вариантом по умолчанию anthropic/claude-opus-4.6, напрямую через Anthropic или OpenAI либо локально через Ollama. Кроме npm, проект доступен как Docker-образ ghcr.io/oguzbilgic/kern-ai. Внешний сигнал пока минимальный: у поста на Hacker News один пункт и ни одного комментария, у репозитория на GitHub около 69 звёзд.
Контекст
kern оформляет смену перспективы в разработке агентов: вместо чат-бота, отвечающего на отдельный запрос, предлагается агент как долгоживущий процесс, который живёт в одном сеансе поверх всех мессенджеров пользователя. Центральная инженерная проблема такой схемы — удержание контекста на десятках тысяч сообщений при ограниченном контекстном окне, и её здесь решают иерархической компрессией: диалоги делятся на сегменты по темам и сворачиваются в многоуровневые резюме, к которым можно возвращаться семантическим поиском. Сам набор приёмов не нов — сегментация диалогов, иерархия резюме и семантический recall уже описаны в литературе по агентной памяти; новизна kern в том, что эти паттерны собраны в один работающий рантайм. На другом полюсе рынка аналогичное направление развивают проприетарные стеки вроде OpenAI Operator и Anthropic Agent SDK, но они работают на инфраструктуре вендора, тогда как kern реализует подход «агент как git-репозиторий с памятью» на машинах самих пользователей.
Почему это важно для индустрии
Для индустрии релиз показателен как рыночный сигнал: слой долгоживущей памяти для агентов быстро коммодитизируется, и автор выложил паттерн agent-kernel под лицензией MIT. Продавать «агента, который помнит всё» как отдельный продукт после этого уже нельзя — защищаться стартапам придётся вертикальными решениями, а не самой памятью. Билдерам kern интересен не как готовый продукт, а как работающий образец UX-паттерна «один долгоживущий процесс с постоянной сессией поверх многих каналов»: практическая ценность сегодня в воспроизводимых элементах архитектуры, которые можно перенести в собственные проекты. Если появятся независимые измерения качества иерархической компрессии, схема L0→L1→L2 с recall может закрепиться как типовой строительный блок опенсорс-агентов, а открытая реализация станет форкабельной точкой для изучения и сравнения компромиссов с проприетарными стеками.
Почему это важно для пользователей
Если вы давно хотите персонального агента, который помнит всё, что вы ему писали в Telegram, и продолжает тот же разговор в терминале, kern ставится двумя командами (npm install -g kern-ai; kern init) или запускается через Docker-образ с готовым Telegram-ботом. Всё работает локально: можно подключить платные модели через OpenRouter, Anthropic или OpenAI, а можно полностью бесплатно через Ollama. Агент умеет сам рисовать дашборды со своими данными в виде готовых HTML-страниц и файлов data.json. Тем, кто изучает промпт-инжиниринг долгоживущих агентов, полезно открыть templates/KERN.md: там видно, как автор решает идентификацию пользователей кодами KERN-XXXX, хранит память в файле USERS.md и дисциплинирует поведение правилом NO_REPLY.
Что пока неизвестно / ограничения
Ключевое утверждение проекта — сохранение контекста на длинных горизонтах — остаётся неоцененным: нет измерений качества удержания информации, нет сравнения с базовыми линиями вроде полного контекстного окна, плоского RAG или других memory-схем, нет опубликованной методологии. Каждый уровень сжатия потенциально теряет детали, и без данных неизвестно, сколько именно. Отсутствуют замеры латентности recall-поиска и оценки стоимости токенов на длинных сессиях, а правила из templates/KERN.md — это промпт-эвристики, а не гарантии поведения модели. Внешней верификации нет вообще, поэтому в продакшн-контуре со SLA, нагрузкой и чужими пользователями полагаться на проект пока нет оснований.
Источники
- GitHub - oguzbilgic/kern-ai: Agents that do the work and show it
- kern-ai/templates/KERN.md at master (system prompt template)
- kern-ai on npm — package kern-ai, latest 0.41.0 (published 2026-09-23T01:13:29Z)
Автор
Look at AI, редакция