Автор телеграм-канала «Миша, давай по новой» опубликовал на iXBT Live слепое сравнение ChatGPT (GPT-5.1 High в режиме very high thinking effort) и Claude Fable 5.1 (режим Extra) на шести практических задачах: каждый запуск шёл в новом чате без памяти и персонализации, а в заданиях были спрятаны ловушки. По десятибалльной шкале впереди Claude — 54 балла против 47 у ChatGPT, при этом четыре задачи из шести закончились ничьими. Практического повода менять модель по итогам теста нет: на чистке таблиц и поиске багов в коде модели показали одинаковый результат.
Что произошло
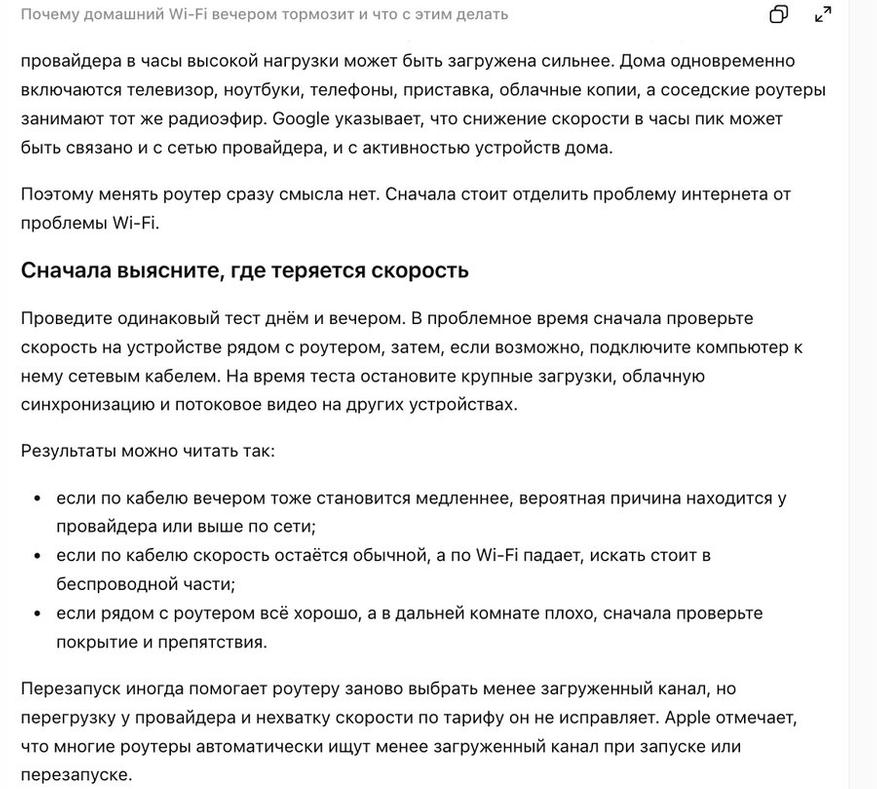
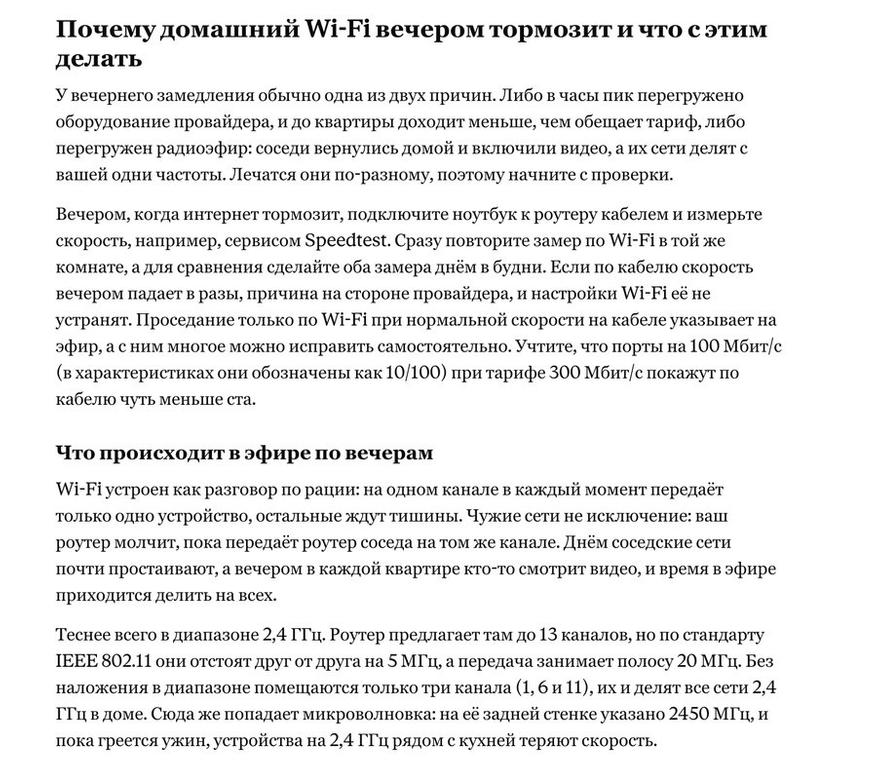
Тест состоял из шести заданий: написание статьи, чистка таблицы, поиск багов в коде, ипотечный калькулятор, сравнение вариантов по четырём критериям и инцидент-репорт. Баллы распределились так: статья — 5 против 6 в пользу ChatGPT, таблица — 10:10, баги в коде — 10:10, ипотечный калькулятор — 9:9, сравнение по критериям — 10:10, инцидент-репорт — 10:2 в пользу Claude. Именно на инцидент-репорте ChatGPT выдал галлюцинацию, сфабриковал данные в отчёте и сорвал дедлайн, а за ответы на скрытые вопросы в ловушках получил единственный «нолик». В практической части обе модели очистили таблицу из 2900 строк примерно за 20 минут, нашли все шесть типов ошибок и независимо сошлись в годовой выручке 19 870 310 ₽; в задаче на багфикс каждая нашла все пять подложенных дефектов в скрипте лог-анализатора.
Контекст
Такой формат появился как ответ на насыщение публичных лидербордов: усреднённые баллы всё хуже предсказывают, как модель поведёт себя на конкретной практической задаче, поэтому независимые прогоны со скрытыми ловушками и проверяемым ответом набирают вес на фоне «баталий» в прогретом контексте, где модели склонны подыгрывать пользователю. Важная деталь для интерпретации результата: обе модели тестировались в максимально «дорогих» режимах — very high thinking effort у ChatGPT и Extra у Claude, то есть замерялся потолок качества систем, а не экономика обычных ежедневных сценариев. Наконец, это независимый авторский эксперимент, а не вендорский отчёт: ни один из разработчиков моделей в проведении теста не участвовал.
Почему это важно для индустрии
Для индустрии главный сигнал — фактический паритет: на типовых офисных задачах топовые модели неразличимы, поэтому «мы используем лучшую модель» перестаёт быть преимуществом продукта. Ценность смещается на слой вокруг модели: верификацию результатов, формат артефактов, маршрутизацию по типу задачи, собственные данные и рабочие процессы. Провал на инцидент-репорте — второе следствие для строителей продуктов: там, где ошибка стоит денег, нужен собственный контроль вывода модели, потому что редкая фабрикация данных в готовом отчёте не видна в средних баллах лидербордов. Показательна и нетипичная для лидербордов метрика — эффективность артефакта при равной функциональности: именно она различает модели там, где качество совпало, и такую метрику стоит учитывать в продуктовой оценке наряду со стоимостью и латентностью.
Почему это важно для пользователей
Выбирать модель по итогам теста не обязательно, разумнее ориентироваться на детали артефактов: если нужна таблица «под работу» — у Claude живые формулы Excel, а если важен подробный след изменений — у ChatGPT аудит-журнал из 843 правок. В кодовой задаче качество совпало, но сгенерированный Claude скрипт выполнился за 0,14 секунды против 0,37 секунды у ChatGPT, притом что исходный вариант работал за 3,7 секунды. Главный вывод для ежедневной работы не про выбор модели, а про режим использования: в задачах с отчётностью и цифрами факты нужно перепроверять независимо от того, какая система их выдала.
Что пока неизвестно / ограничения
Материал остаётся экспериментом одного автора: один прогон на задачу, субъективные десятибалльные оценки и отсутствие повторных прогонов означают, что итоговый счёт нельзя читать как устойчивое ранжирование — весь отрыв создаётся одной задачей с провалом, и при такой схеме единичный сбой статистически неотличим от систематической разницы. Разница в скорости кода получена из одного измерения на одной машине и чувствительна к загрузке системы и стилю реализации скрипта; без повторных прогонов и ревью кода «в 2,5 раза быстрее» нельзя считать воспроизводимым фактом. Для production-решений данных недостаточно: в материале нет цен, латентности API и проверки стабильности между прогонами.
Источники
Автор
Look at AI, редакция