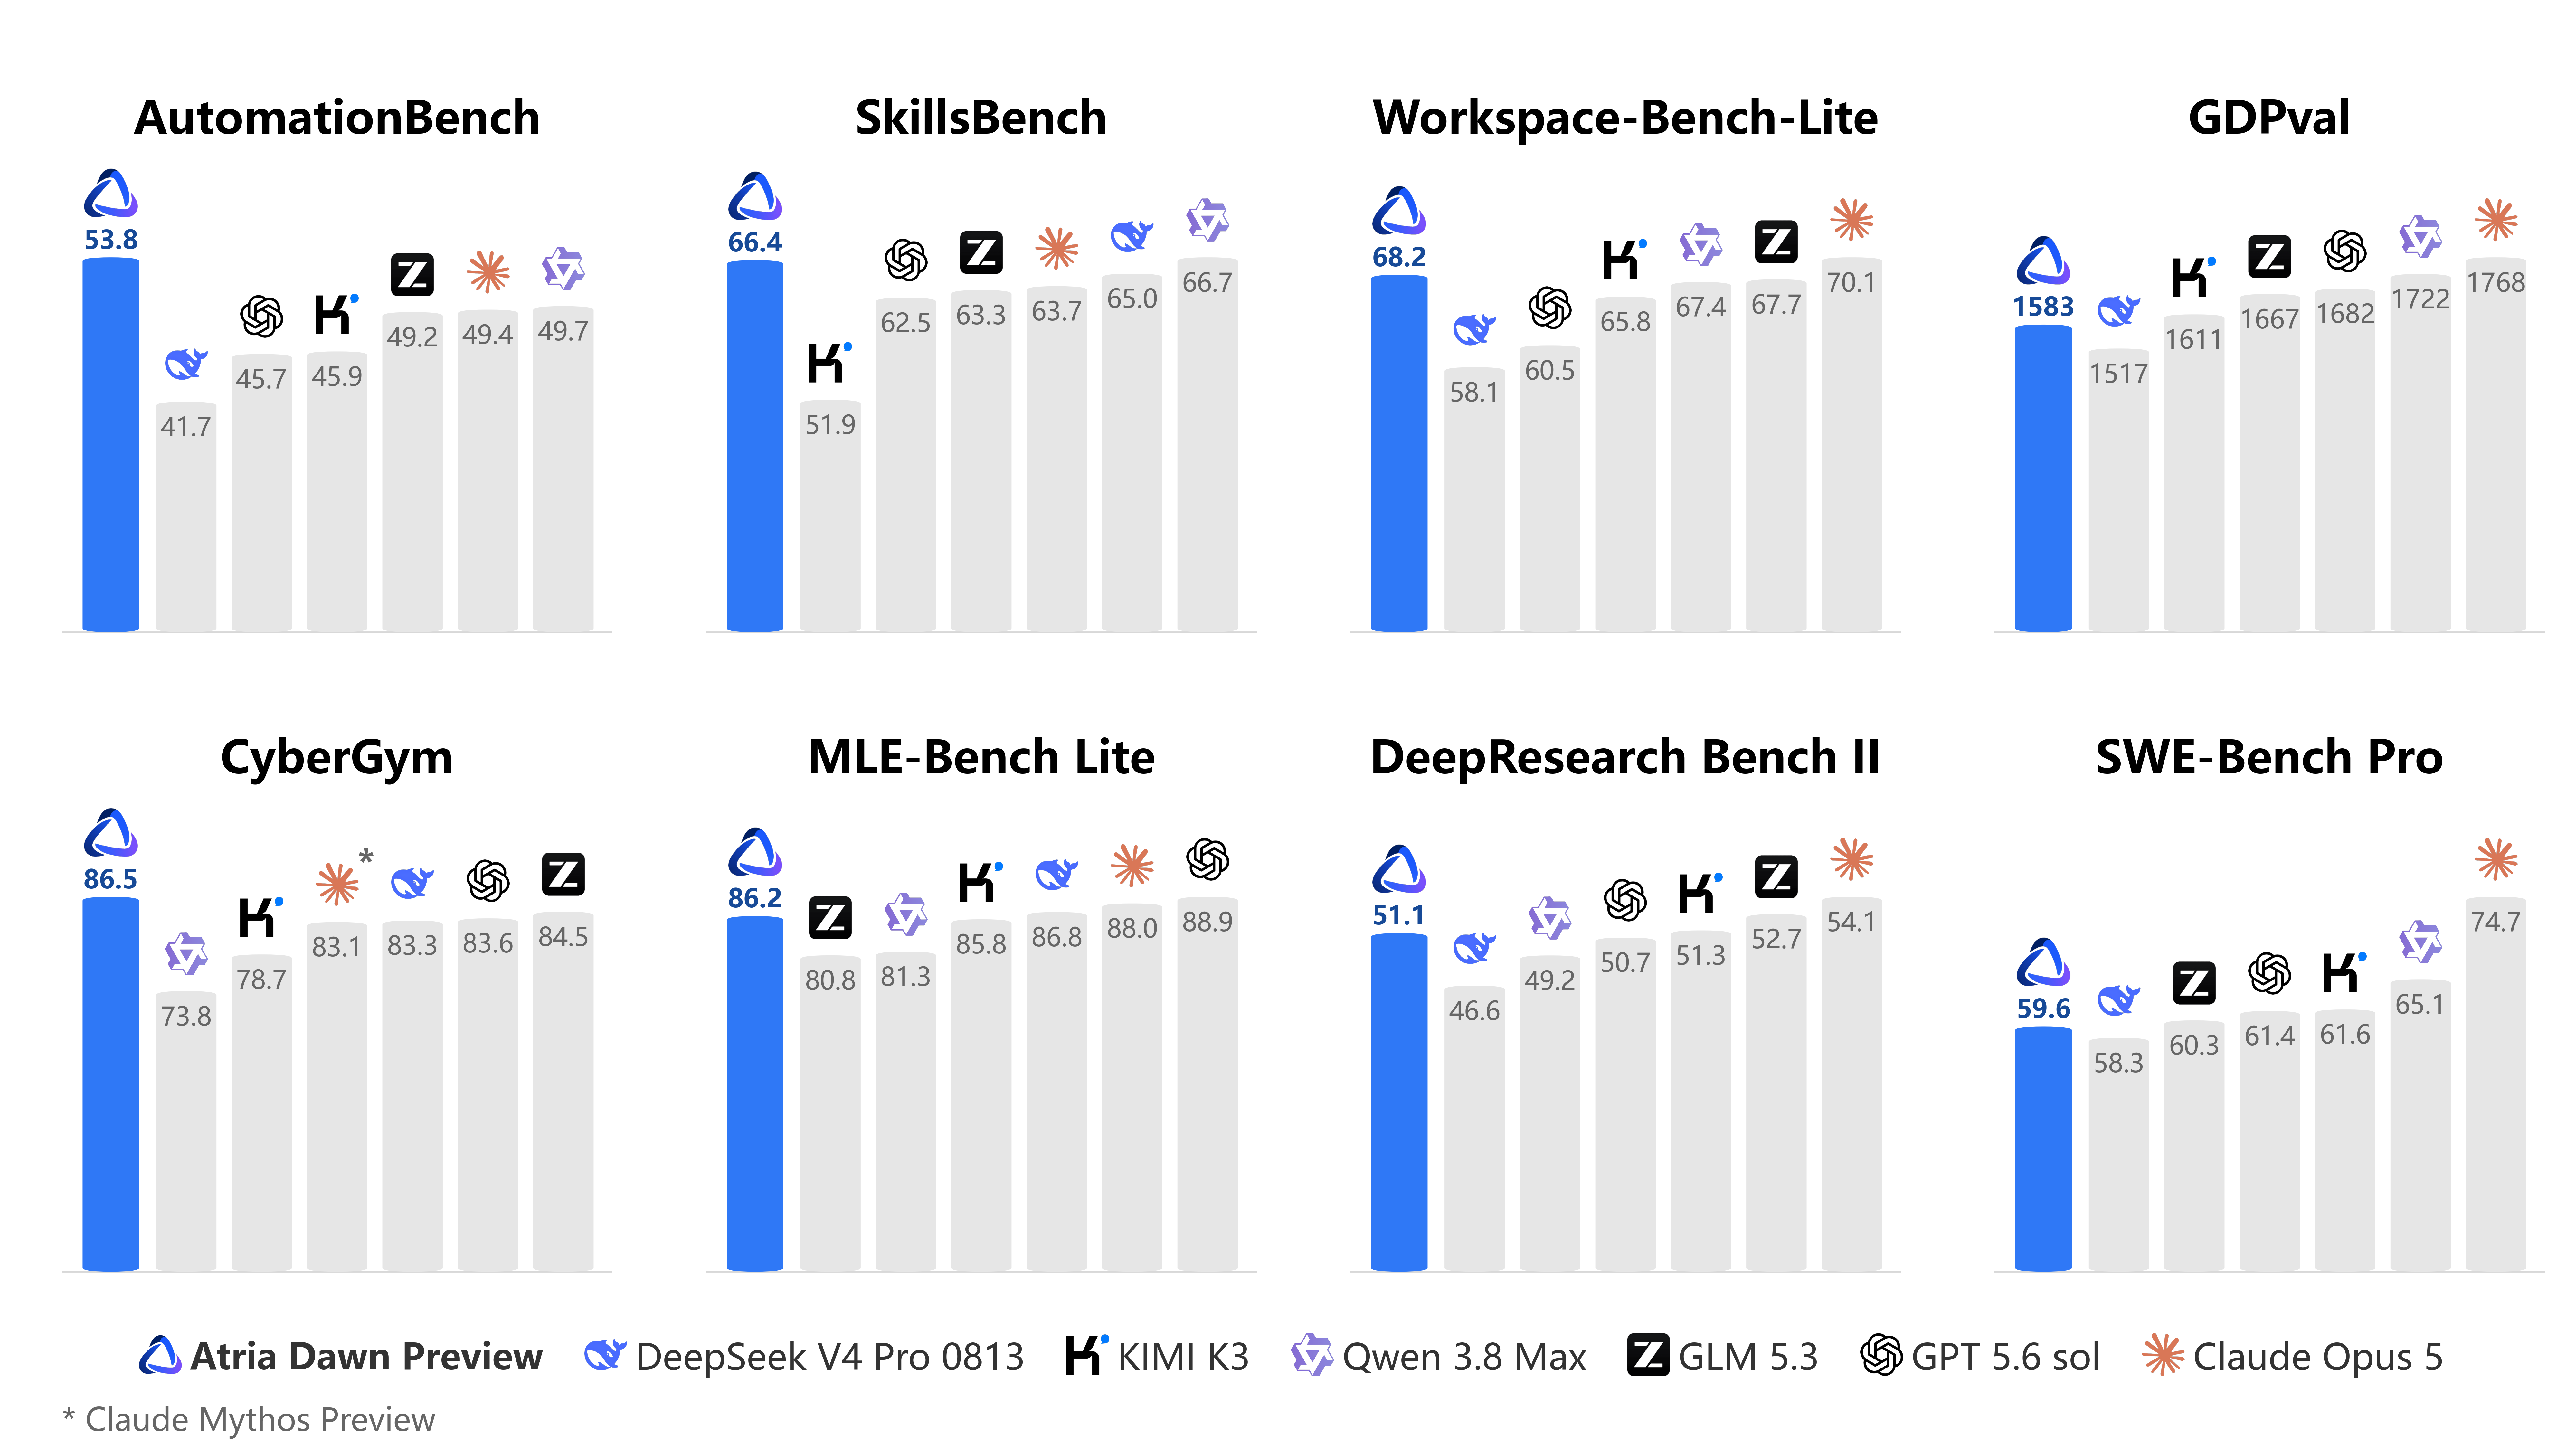
Shanghai AI Laboratory (Shanghai Artificial Intelligence Laboratory) выпустила превью агентной модели Atria Dawn Preview: открытые под лицензией MIT веса, API в двух регионах и готовые конфиги для Codex, Claude Code и Kimi Code. Ключевое отличие от привычных агентных стеков в том, что агентные навыки вроде многошагового планирования, работы с инструментами и восстановления после сбоев закреплены прямо в весах модели, а не во внешнем каркасе; по официальным цифрам разработчика модель лидирует в бенчмарках поиска, тул-юза и кибербезопасности.


Что произошло
Модель построена на GLM-5.2: 744B параметров, архитектура MoE с 8 экспертами на токен, контекст 256K токенов. Открытую задачу Atria Dawn Preview ведёт по полному циклу «анализ → план → код → эксперимент → разбор ошибок → повтор», корректность результата на каждом шаге проверяется внешними сигналами — тестами, метриками, состоянием файлов и источниками, а опыт из таких прогонов закрепляется в весах через Verifiable Experience Pipeline. По официальной таблице бенчмарков в README модель лидирует в BFCL v4 (77.0 против 71.4 у DeepSeek V4 Pro 0813 и 69.1 у KIMI K3), AutomationBench (53.8), CyberGym (86.5), DeepSearchQA (96.0) и BrowseComp (92.5), тогда как на SWE-bench Pro (59.6) и Terminal-Bench 2.1 (78.3) впереди Claude Opus 5 с 74.7 и 90.2. Вход только текстовый: картинки и PDF API отклоняет с ошибкой 400 «is not a multimodal model». Техническое описание подхода опубликовано в статье «Atria Dawn: The Dawn of Agentic Superintelligence» (arXiv 2609.15818).
Контекст
До сих пор агентное поведение чаще всего собиралось во внешнем каркасе: оркестратор, скилл-библиотеки и рантайм вокруг модели отвечали за планирование, вызовы инструментов и восстановление после ошибок. Ставка Atria Dawn противоположная — навыки формируются обучением на верифицируемых задачах и переносятся в сами веса, а не живут в обвязке. Профиль бенчмарков указывает именно на такой доменный подход: рост сосредоточен в агентных сценариях (BFCL v4, CyberGym, BrowseComp, DeepSearchQA), а на универсальном кодинге модель уступает Claude Opus 5, то есть перед нами агентный файнтюн, а не универсальный скачок. Вторая часть контекста — позиционирование: Shanghai AI Lab предлагает модель не как закрытый продукт, а как заменяемый движок под уже привычные CLI-инструменты, с готовыми конфигами для Codex, Claude Code и Kimi Code и API сразу в международном и китайском регионах.
Почему это важно для индустрии
Открытая под MIT агентная модель на 744B MoE — это commoditization агентной прослойки: сборка агентных сценариев дешевеет, а защищённость стартапов смещается от «оркестрации» к данным, дистрибуции и вертикальной интеграции. Открытость здесь подлинная, а не косметическая: веса выложены публично, запуск поддержан в стандартных рантаймах SGLang и vLLM, поэтому независимое воспроизведение оценки технически возможно — редкий случай, когда громкое заявление можно проверить без контакта с разработчиком. Если сторонние лаборатории подтвердят хотя бы часть цифр (BFCL v4, CyberGym, BrowseComp), давление на закрытые агентные модели вроде Claude Opus 5, GPT 5.6 и GLM 5.3 вырастет, а перенос навыков в веса станет мейнстримной методикой обучения в open-source. Паттерн «заменяемый агентный движок плюс коннекторы к чужим CLI» превращает выбор модели в продуктовую фичу с A/B-переключением движков под тип задачи.
Почему это важно для пользователей
Потрогать модель можно уже сегодня. Быстрый путь — API-консоль api.atria-asi.ai с эндпоинтом /v1 и отдельным регионом для Китая: подключение к Codex (CLI ≥ 0.154.0), Claude Code или Kimi Code (≥ 0.43.1) по готовым примерам из README, при этом для Codex в каталоге моделей придётся объявить «input_modalities»: ["text"], иначе image-вложения не пройдут. Локальный запуск — через SGLang (v0.5.13.post1+) или vLLM (v0.23.0+); BF16 и FP8-версии лежат на Hugging Face (internlm/Atria-Dawn-Preview) и ModelScope. FP8 снижает требования к памяти, но 744B MoE всё равно требует узла из 8 ускорителей высокого класса плюс запас под KV-кэш, так что self-hosting — вариант для команд с GPU-парком. Реалистичный первый продукт — text-first агентный сценарий: ресёрч с проверяемыми источниками, отчёты из документов, автоматизация с проверкой результата тестами и метриками; сценарии со скриншотами, UI-автоматизацией и обработкой PDF в исходном виде не подойдут.
Что пока неизвестно / ограничения
Все цифры бенчмарков — данные самого разработчика из официального отчёта, независимые прогоны пока отсутствуют, поэтому лидерство в BFCL v4 и CyberGym стоит перепроверять на своих задачах. В доступных источниках (arXiv 2609.15818, README, карточка модели) нет абляций, сравнивающих Atria Dawn Preview с базовой GLM-5.2, поэтому вклад Verifiable Experience Pipeline в результат количественно не установлен. Для продакшена пока нет публичных цен API, SLA и данных по латентности; статус превью означает, что до стабильного релиза с подтверждёнными сторонними эвалами ещё далеко.
Источники
- Atria Dawn: The Dawn of Agentic Superintelligence (arXiv 2609.15818)
- GitHub-репозиторий atria-asi/Atria-Dawn-Preview (README, таблица эвалов, гайды по развёртыванию)
- Карточка модели internlm/Atria-Dawn-Preview на Hugging Face (лицензия MIT, FP8-версия)
- Официальный сайт проекта Atria
Автор
Look at AI, редакция