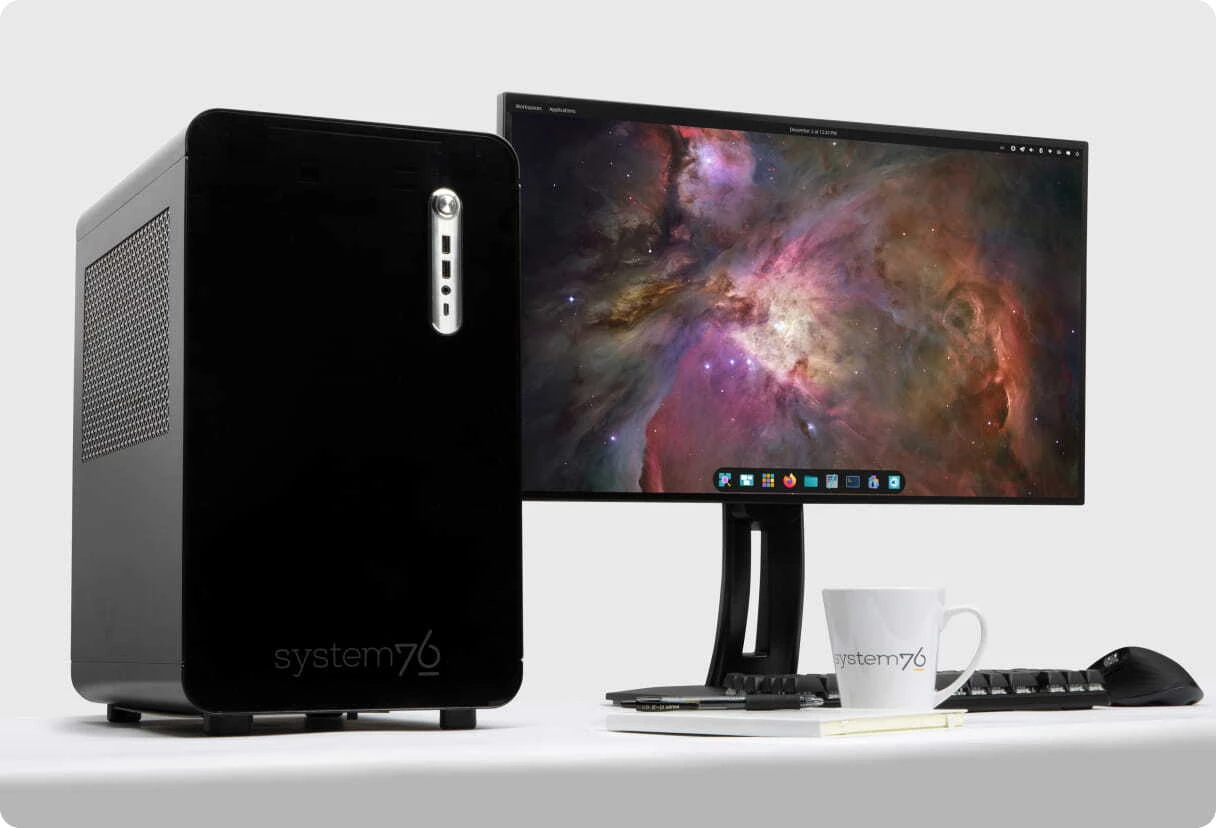
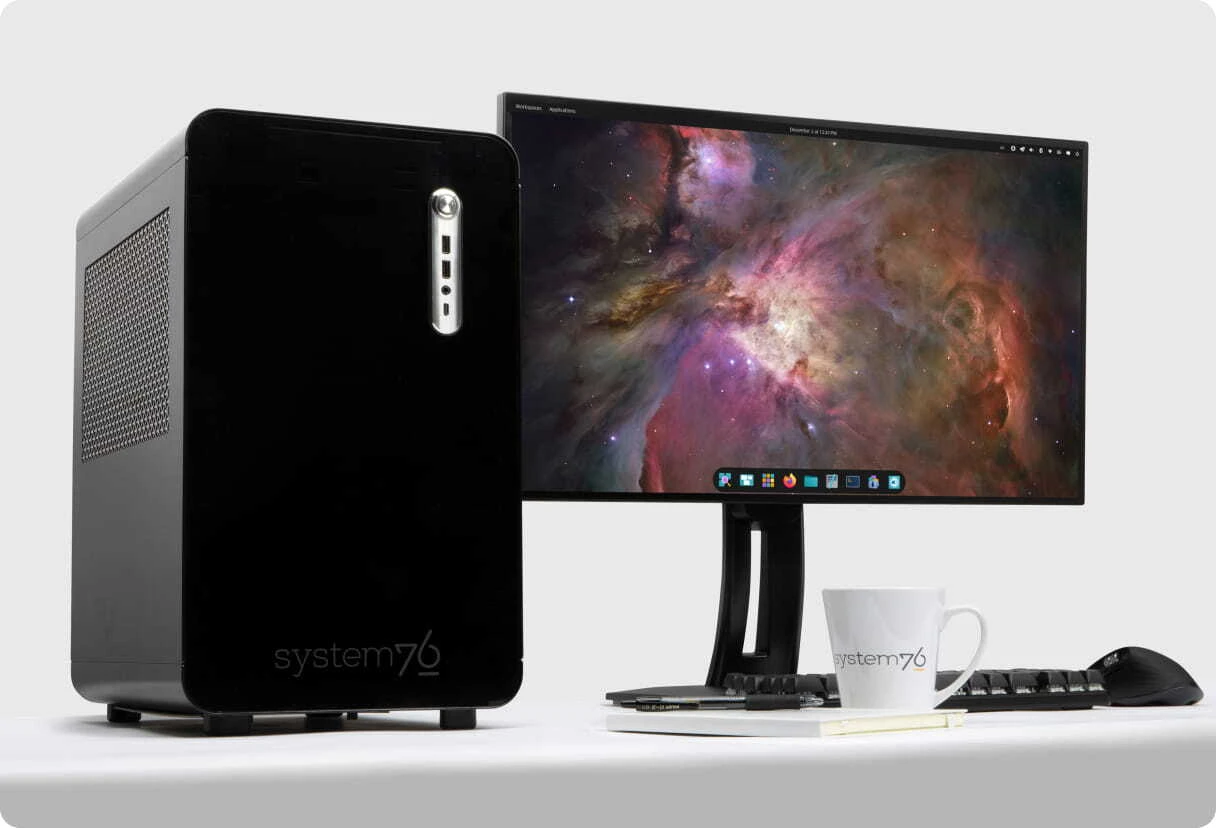
System76 представила Thelio Mira AI — настольную Linux-рабочую станцию на CPU AMD Ryzen 9000 (сокет AM5) с возможностью установки двух GPU NVIDIA RTX PRO 6000 Blackwell по 96 ГБ ECC GDDR7 каждый, итого до 192 ГБ видеопамяти. Такой объём позволяет удерживать Llama 3.3 70B в FP8 или Qwen 2.5 32B в FP16 целиком в видеопамяти, без выгрузки весов на диск. Стартовая цена — $3 299, запуск анонсирован на 9 сентября 2026 года.

Что произошло
System76 раскрыла конфигурационную линейку вместе с анонсом запуска. Базовая версия за $3 299 включает процессор Ryzen 7 9700X, видеокарту NVIDIA A400, 64 ГБ DDR5 и 1 ТБ M.2-накопитель; установка двух RTX PRO 6000 Blackwell вместо неё обходится примерно в $37 239 сверху, а полная конфигурация выходит более чем на $40 000. Заявленная вместимость памяти подтверждается арифметикой: веса модели класса 70B в FP8 занимают около 70 ГБ, а 32B-модели в FP16 — около 64 ГБ, поэтому при таком объёме ECC GDDR7 модель удерживается в памяти одной машины целиком, с запасом под KV-кэш и активации.
Контекст
Инженерное решение System76 строится на отказе от дорогой HEDT-платформы Threadripper PRO, процессоры которой стоят от $1 649 за 16-ядерный 9955WX до $11 699 за 96-ядерный 9995WX. Вместо неё используется доступный потребительский сокет AM5, а сэкономленные порядка $5–12 тыс. перенаправлены из платы и CPU в GPU. Научной новизны в анонсе нет — ни новой модели, ни нового метода обучения, ни нового бенчмарка; новизна чисто продуктовая: два профессиональных ускорителя по 96 ГБ упакованы в корпус обычного настольного ПК на потребительском процессоре. В результате конфигурация класса «локальная 70B» впервые покупается как готовая преднастроенная Linux-машина, а не как самосборка, и категория преднастроенных ML-рабочих станций расширяется от HEDT-платформ к потребительским CPU.
Почему это важно для индустрии
Главное архитектурное ограничение для билдеров — отсутствие NVLink: связь между двумя картами идёт по PCIe 5.0 x8 с пропускной способностью до 32 ГБ/с в одну сторону, что соответствует уровню PCIe 4.0 x16 и существенно уступает 900 ГБ/с у NVLink H100. Для tensor-parallel-инференса, где обмен между ускорителями происходит на каждый токен, это серьёзный латентный узел, поэтому реальные tokens/sec почти наверняка будут заметно ниже, чем у систем с NVLink. Отсюда точное позиционирование платформы: model-parallel-инференс и дообучение моделей порядка 70B — да, распределённое data-parallel-обучение — нет. Для компаний машина служит референс-дизайном под on-prem RAG, локальных агентов и внутреннее дообучение 70B-класса, при этом для действующих production-контуров ничего не меняется: существующие cloud-инференс-конфигурации и single-GPU/H100-станции продолжают работать как раньше. Если дефицит GDDR7 спадёт и цена RTX PRO 6000 вернётся к уровню $8–9 тыс., схема «AM5 + 2×96 ГБ» с высокой вероятностью будет скопирована другими вендорами Linux-рабочих станций.
Почему это важно для пользователей
Thelio Mira AI — это готовый Linux-компьютер с предустановленной Pop!_OS 24.04 LTS COSMIC или Ubuntu 24.04/26.04, в котором заранее настроены драйверы NVIDIA и ML-библиотеки: крупные открытые модели запускаются локально, без облака и без отправки данных наружу, что критично для работы с чувствительными или персональными данными. Экономику покупки просчитал TechTimes: при аренде GPU в облаке по средней цене около $2.20 за GPU-час (выборка более чем из 36 провайдеров, данные на 8 сентября 2026) собственная двухкарточная станция окупается при круглосуточной загрузке примерно через 13 месяцев, а при работе около 8 часов в день — за 3–4 года. Практический вывод такой: приобретение оправдано при постоянной высокой нагрузке на модель, а при эпизодических задачах аренда облачных GPU остаётся дешевле.
Что пока неизвестно / ограничения
В материалах анонса нет ни одного бенчмарка, а независимых замеров скорости (throughput, TTFT при батчах) пока не появлялось, поэтому вопрос о реальной производительности и production-готовности остаётся открытым: заявленная вместимость проверяема по спецификациям, но скорость ничем не подтверждена. Заявление о нулевом времени «от коробки до первого инференса» в источниках не верифицировано, а состав преднастроенных ML-библиотек — версии фреймворков, версии CUDA, движок инференса — не раскрыт, так что пока это маркетинговое утверждение, а не подтверждённый факт. Кроме того, на фоне дефицита GDDR7 цены на RTX PRO 6000 (порядка $16 000) и доступность двухкарточных конфигураций могут измениться, что сделает расчёт окупаемости менее предсказуемым.
Источники
- Thelio Mira AI Linux Workstation (System76)
- System76 Thelio Mira AI Fits 192 GB ECC GPU Memory Into Consumer Desktop Chassis — TechTimes
- System76 Introduces Thelio Mira AI Workstation — TechPowerUp
Автор
Look at AI, редакция