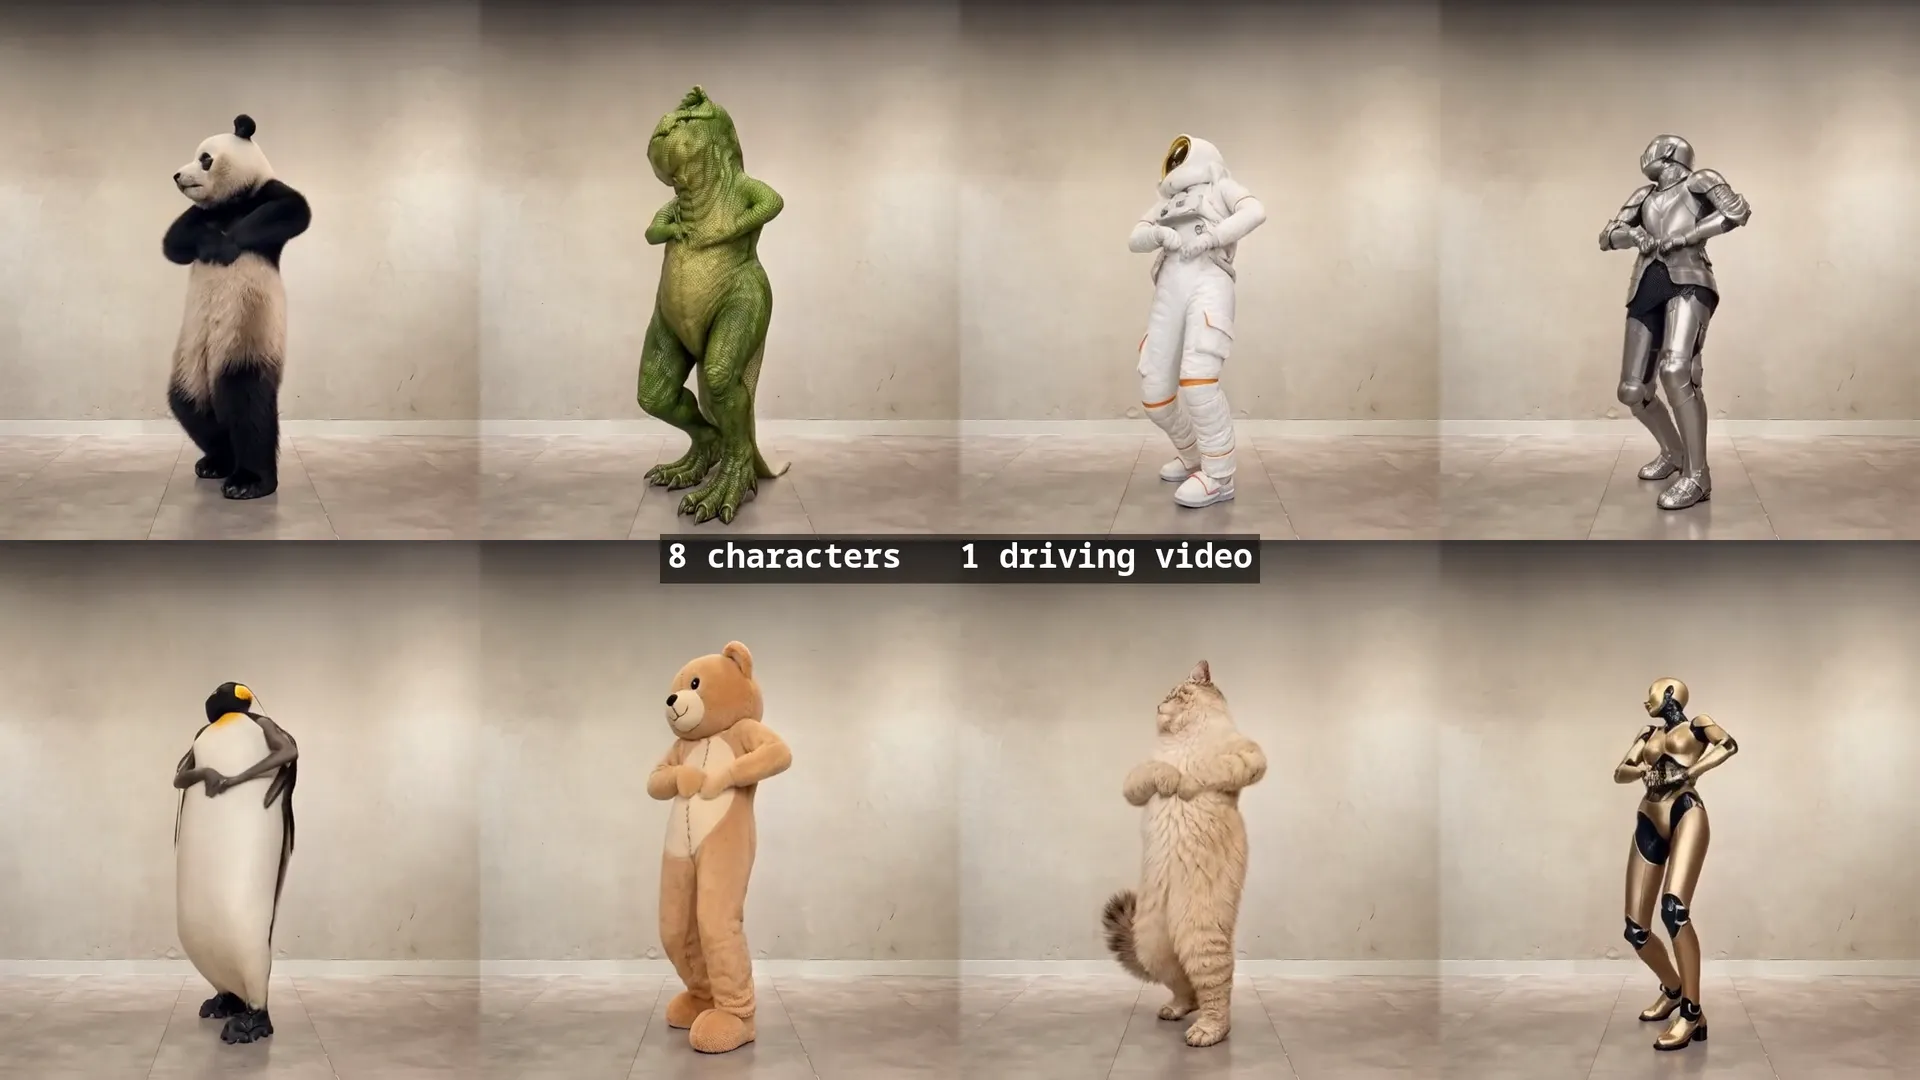
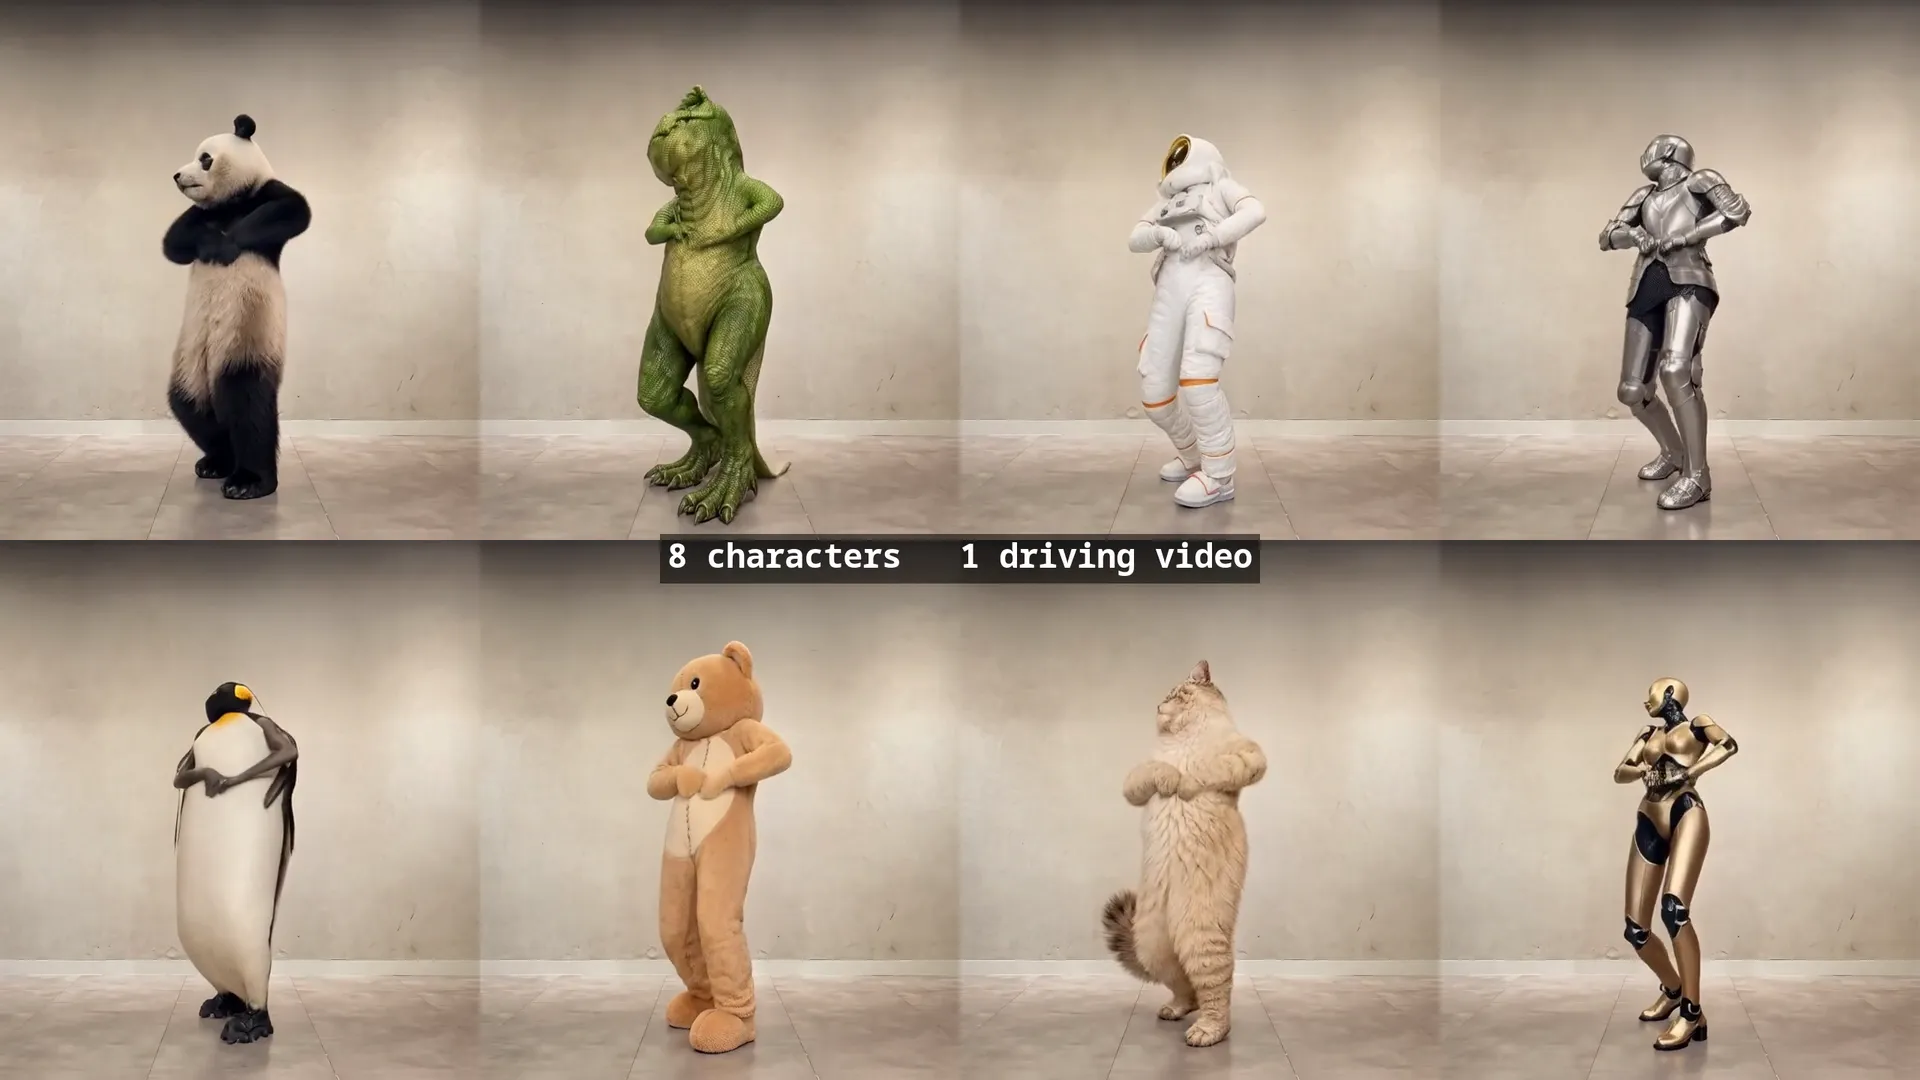
Viggle выпустила Viggle-Animate — открытую модель для замены персонажа в готовом видео: достаточно исходного ролика и одного его же кадра, перерисованного с новым героем. Модель представляет собой полный fine-tune 33,1-миллиардного видеотрансформера MiniMax H3, дистиллированный через DMD до трёх проходов сэмплинга, а в тесте компании 124 кадра рендерятся за 26 секунд на одном NVIDIA B200.
Что произошло
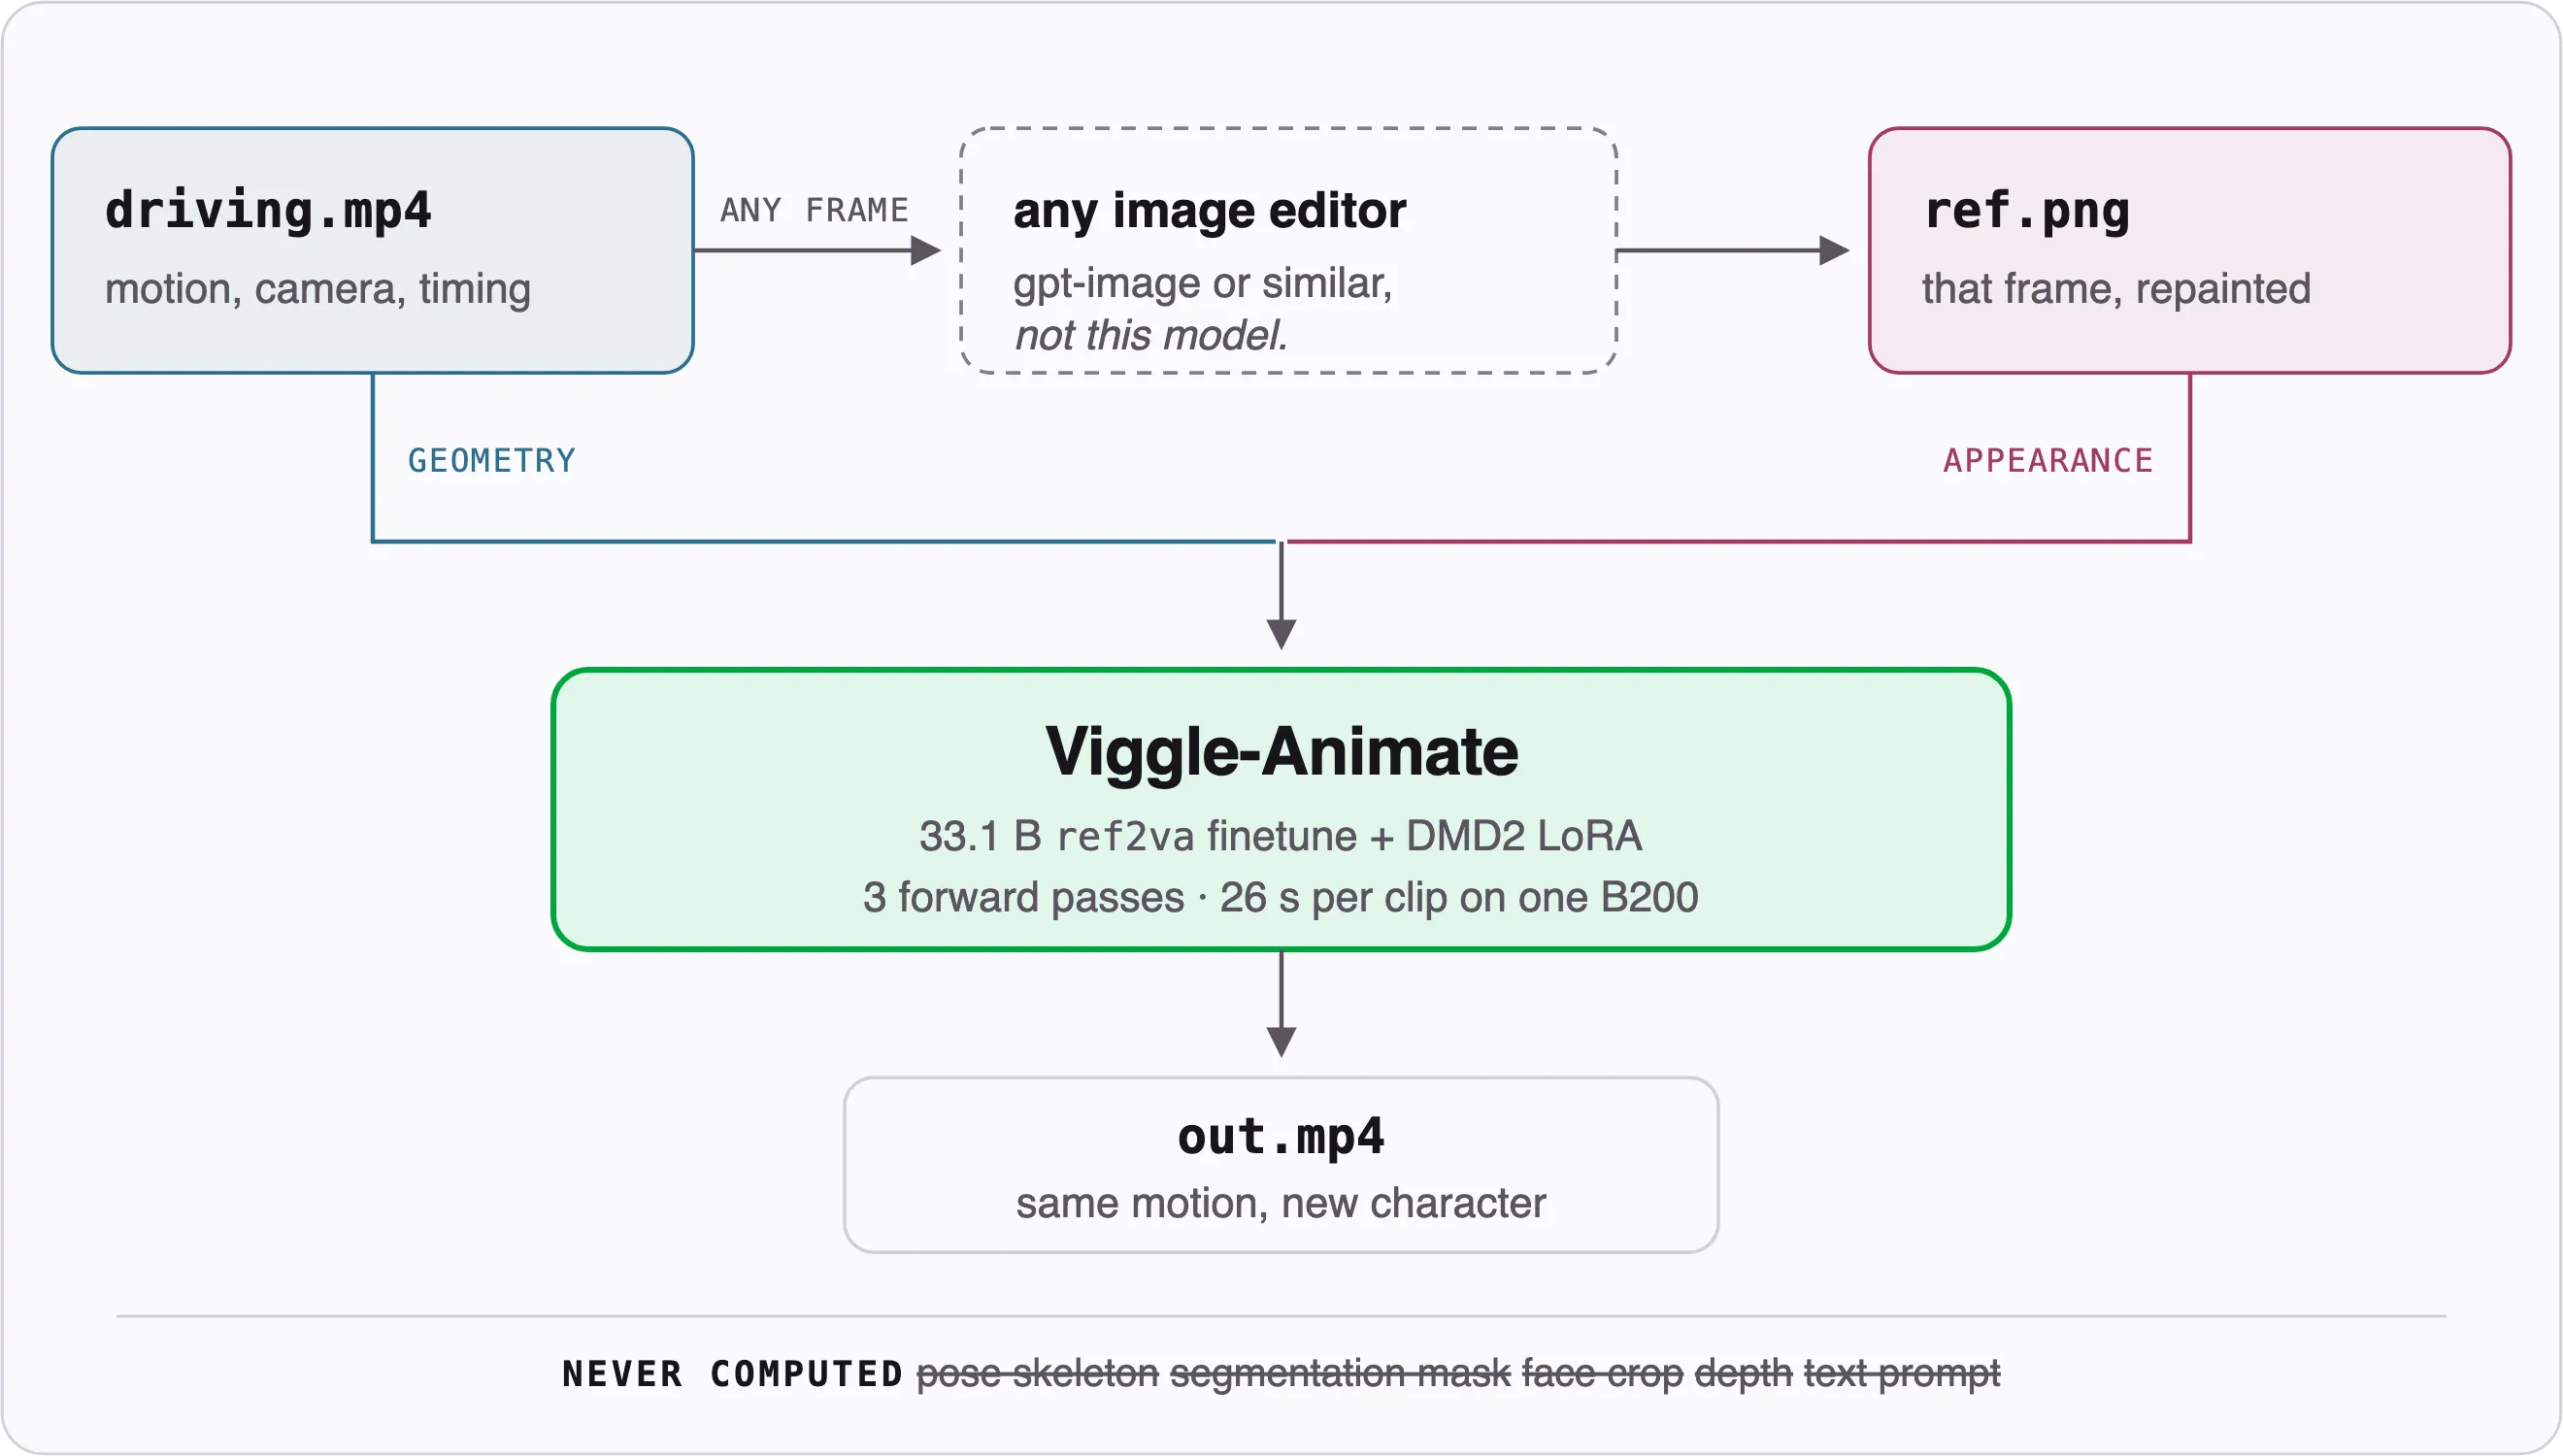
Веса опубликованы на Hugging Face в репозитории Viggle/Viggle-Animate, параллельно запущена браузерная демо-страница. Входных данных ровно два: исходный ролик и один его же кадр, где персонажа заменили; маски, скелеты позы, трекинг лица и текстовые промпты не нужны. По замерам самой компании, ролик в 124 кадра (24 fps, разрешение 480x832) рендерится за 26 секунд на одном NVIDIA B200, что в 6,1 раза быстрее Wan2.2-Animate-14B, показавшей 160 секунд на том же оборудовании. В официальном описании перечислены слабые места: хромает липсинк в крупных планах, качество деградирует в сценах с несколькими персонажами и на монтажных склейках, исходная аудиодорожка в результате не сохраняется.
Контекст
Character replacement в видео исторически строился из цепочки отдельных моделей: позный эстимейтор, сегментация персонажа, трекинг лица и текстовый энкодер, плюс длинные сэмплинговые проходы, обычно порядка 30. Viggle-Animate сводит этот пайплайн к одному fine-tune'у базового видеотрансформера MiniMax H3 (референс ref2va) на 33,1 миллиарда параметров: геометрию движения модель берёт из исходного ролика, а внешний вид персонажа — из единственного перерисованного кадра. Дистилляция через DMD сокращает сэмплинг с типичных примерно 30 до трёх проходов, что и даёт заявленную скорость. По сути это инженерное упрощение пайплайна, а не новый класс архитектуры.
Почему это важно для индустрии
Для видео-платформ модель убирает из конвейера всю цепочку вспомогательных моделей и оркестрацию: замену персонажа можно прогонять одним инференс-вызовом на одном GPU, что заметно снижает стоимость кадра. Публикация весов 33,1B-модели, обученной на MiniMax H3, показывает, что крупные видео-диффузионные модели доводятся до узких прикладных задач открытым fine-tune'ом, а не только через закрытые API. Командам с B200/H200 и нишевым сценарием — один персонаж, контролируемые сцены, короткие клипы — Viggle-Animate можно пилотировать прямо сейчас, а исследователи получают открытую базу для дообучения под собственные решения.
Почему это важно для пользователей
Замену актёра в готовом ролике на стилизованного персонажа теперь можно сделать локально: через браузерное демо или собственные веса достаточно подать два входа — видео и один перерисованный кадр — без масок и трекинга. Цена вопроса: полный bf16-режим требует GPU примерно с 96 ГБ видеопамяти, offload до ~12 ГБ позволяет запускать модель на более доступных картах, но медленнее. При коммерческом использовании действуют условия MiniMax H3 Community License, а для замены реального человека в кадре нужно его согласие.
Что пока неизвестно / ограничения
Все цифры скорости даны самой компанией на NVIDIA B200 и не воспроизведены независимо. Научной статьи, метрик качества (FVD, FID, CLIP-сходство, human eval) и сравнения с Wan2.2-Animate-14B по качеству, а не только по скорости, пока нет; точные цифры для offload-режима не раскрыты, так что попадание модели на 80-гигабайтные карты вроде A100/H100 ещё не подтверждено. Независимые оценки качества на типовом контенте за пределами демонстрационных сценариев отсутствуют.
Источники
Автор
Look at AI, редакция