Вокруг открытой видеомодели MiniMax H3, которая генерирует ролики до 2K и 15 секунд с нативным стереозвуком, вышла серия сторонних инструментов. Дистиллят VDN-Minimax-H3 создаёт 14,4-секундный клип в 768p за 11,23 секунды на восьми ускорителях NVIDIA B200 в FP8 — быстрее, чем длится само видео. TensorRT-версия VAE ускоряет декодирование в ComfyUI до 1,7 раза, а патч для ostris ai-toolkit превращает контрольное видео в покадрово выровненный V2V-гид и сжимает кэш текстовых эмбеддингов почти в 90 раз. При этом лицензия модели не действует в США, Евросоюзе, Великобритании и Южной Корее.


Что произошло
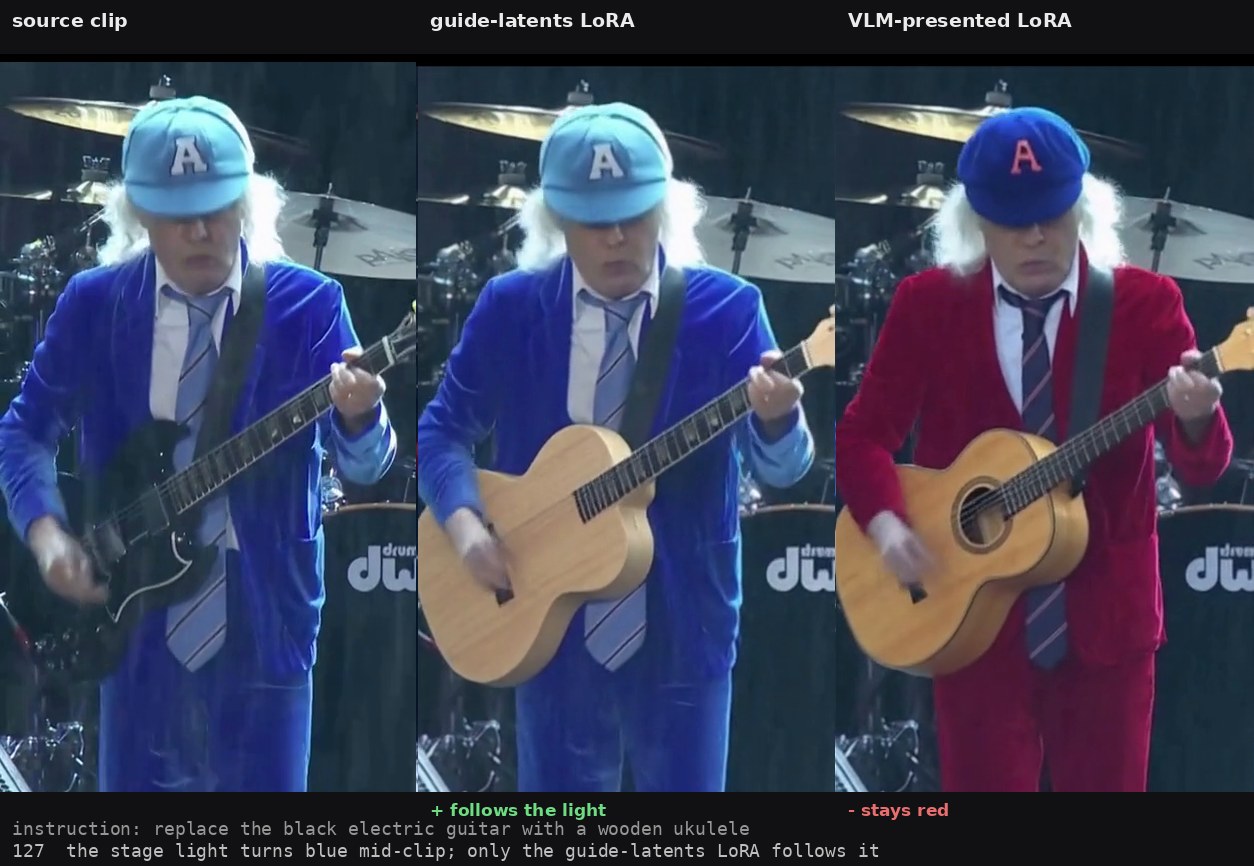
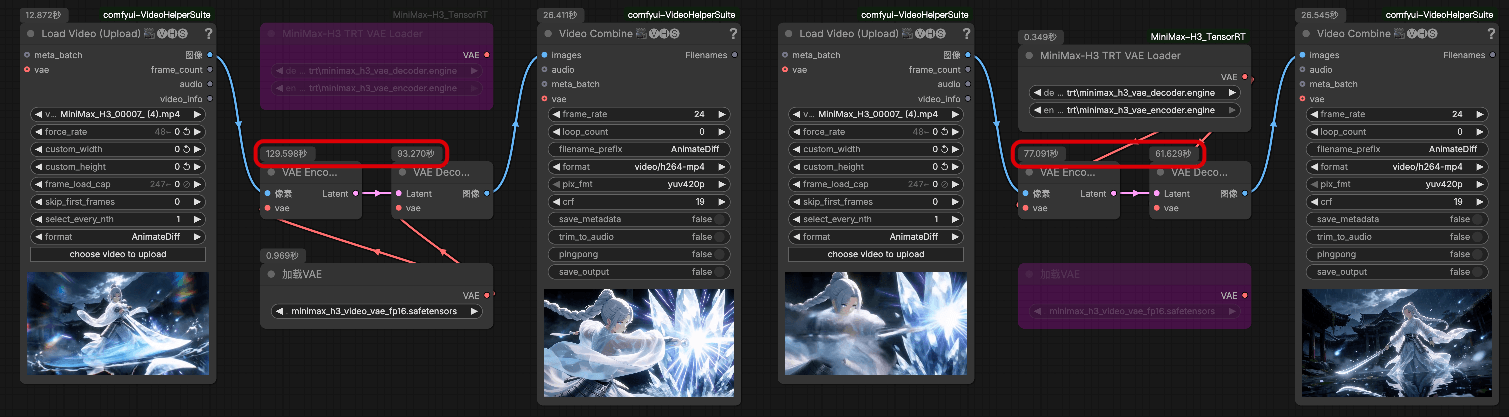
Канал GreenNeuralRobots опубликовал четырнадцатую подборку материалов по хештегу #minimaxH3 со ссылками на сторонние инструменты, все ссылки проверены и рабочие. Главный релиз подборки — VDN-Minimax-H3 от OpenVDN: гибридная архитектура linear + softmax attention, где к нетронутым весам бэкбона добавляются ветка linear attention и два LoRA-адаптера. По данным model card, модель за 8 шагов генерирует 14,4-секундный 768p-клип за 11,23 секунды на конфигурации 8×B200 в FP8, что примерно в 3 раза быстрее плотной H3 на одном GPU; веса объёмом около 82 ГБ выложены в открытый доступ. Для ComfyUI вышел ComfyUI-H3VAE_TRT от lihaoyun6 — TensorRT/ONNX-версия VAE H3 с ускорением декодирования до 1,7 раза; проект собрал 162 звезды, а весовые ONNX-файлы лежат в репозитории lihaoyun6/MiniMax-H3-VAE-ONNX. Кроме того, alisson-anjos опубликовал патч для ostris ai-toolkit с флагами align_video_refs и control_latent_only: контрольное видео становится выровненным V2V-гидом, где кадр i гида управляет кадром i выхода, а режим control_latent_only сокращает кэш текстовых эмбеддингов с 84 МБ примерно до 0,9 МБ на сэмпл. По данным model card, на базе H3 уже опубликовано 114 LoRA.
Контекст
MiniMax H3 — открытая видеомодель, выдающая ролики до 2K и 15 секунд с нативным стереозвуком. Вокруг неё воспроизводится классический цикл открытых моделей: сначала выходит дистиллят, сокращающий число шагов диффузионного сэмплирования, затем ускоренные реализации декодера VAE, переводящего латенты в кадры, и, наконец, поток LoRA-финетюнов — лёгких адаптеров под конкретные стили и задачи. Патч для ai-toolkit следует подходу в стиле IC-LoRA: LoRA обучается на гайд-латентах через общий rotary-clock, поэтому гид покадрово отслеживает смену освещения и сохраняет вшитый текст, что видно на примерах в гисте; при инференсе обученной модели контрольное видео ресемплируется в 24 fps нодой ostris. Отдельный юридический контекст: у VDN-Minimax-H3 территориально ограниченная Community License — она действует везде, кроме США, Евросоюза, Великобритании и Южной Кореи.
Почему это важно для индустрии
Для отрасли показательно, что экосистема за считанные дни после открытия H3 воспроизвела весь цикл открытой модели: дистилляцию до 8 шагов, ускорение декодера через TensorRT и поток финетюнов из 114 LoRA. Генерация 768p-видео быстрее собственного воспроизведения переводит видеодиффузию из категории «долго ждать рендер» в интерактивные и real-time сценарии — это направление демонстрирует игра-фильм interdimensional-game, где каждый кадр создаётся на ходу. Режим control_latent_only удешевляет подготовку V2V-датасетов примерно до 1 ГБ вместо 105 ГБ, снижая порог входа в обучение видео-LoRA. Если цифры дистиллята независимо подтвердятся, вероятны повторение паттерна «linear-ветка плюс LoRA-адаптеры с замороженным бэкбоном» для других открытых видеобэкбонов и превращение связки «8 шагов плюс TRT-VAE» в стандартный инференс H3-совместимых пайплайнов. При этом территориальное ограничение Community License напрямую влияет на то, кто может легально использовать веса и производные продукты.
Почему это важно для пользователей
Всё из подборки можно попробовать сегодня. ComfyUI-H3VAE_TRT ставится кастом-нодой и даёт до 1,7 раза к декодированию, а для видеокарт с меньше чем 12 ГБ VRAM предусмотрен w4a16_awq-декодер. LoRA на VHS-эстетику и фотореалистичные крупные планы Facial-Realism-CloseUp скачиваются с Hugging Face, воркфлоу H3-LongVideos распространяется ZIP-архивом по прямой ссылке. Тем, кто тренирует LoRA на видеомонтаж, полезнее всего патч ai-toolkit: align_video_refs даёт покадровую синхронность V2V-гида, при которой гайд-латенты следят за сменой света и сохраняют вшитый текст, а control_latent_only резко ужимает кэш эмбеддинков. Патч включается двумя флагами, а при инференсе обученной модели гид ресемплируется в 24 fps нодой ostris. Стоимость эксперимента падает почти до нуля — за день можно проверить продуктовую гипотезу на V2V-контроле или нишевом стиле.
Что пока неизвестно / ограничения
Флагманская цифра VDN-Minimax-H3 — единственный самосообщённый замер одной конфигурации: 8 шагов, 768p, клип 14,4 секунды, 8×B200, FP8. Независимых бенчмарков на одном GPU и на потребительских картах пока нет, как и замеров качества дистиллята против плотной модели, поэтому из одного замера не следует общая способность модели к такой скорости. Игра-фильм interdimensional-game — демонстрация, а не измерение: железо, fps, разрешение и версия модели не раскрыты, поэтому заявление о real-time корректно считать демонстрацией направления. Снижение качества у TRT-VAE заявлено автором, но не квантифицировано метриками. Наконец, условия Community License стоит проверять по тексту лицензии применительно к конкретной юрисдикции и сценарию использования, включая производные модели.
Источники
- OpenVDN/vdn-minimax-h3 — Model Card (Hugging Face)
- alisson-anjos — MiniMax-H3 ref2va: aligned video guides (IC-LoRA style v2v) for ai-toolkit (GitHub Gist)
- lihaoyun6/ComfyUI-H3VAE_TRT — TensorRT VAE для MiniMax-H3 в ComfyUI (GitHub)
Автор
Look at AI, редакция