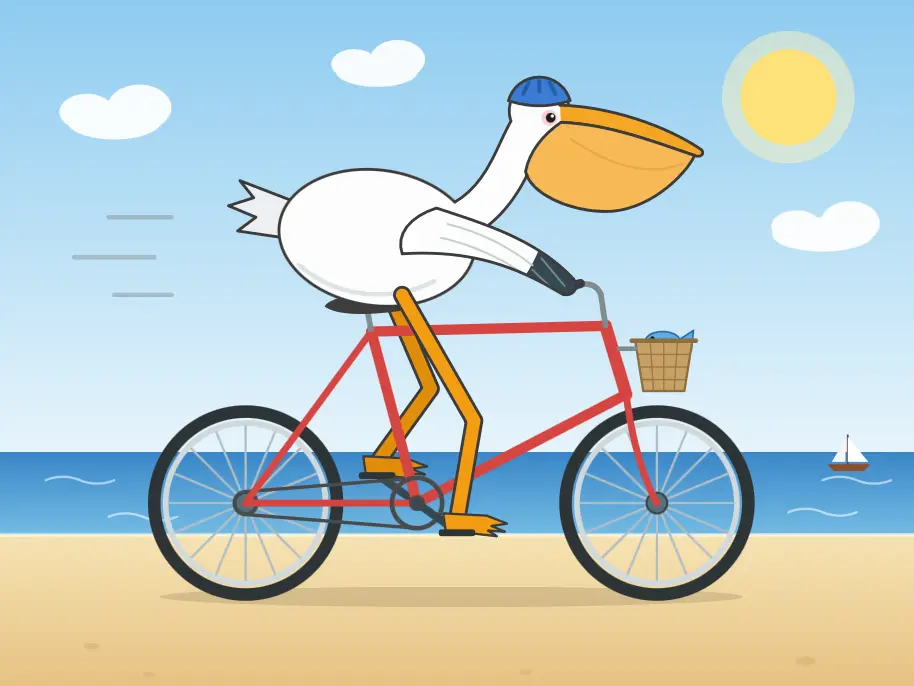
Саймон Уиллисон проверил новую модель Anthropic Claude Fable 5.1 на своём фирменном тесте «пеликан на велосипеде» и прогнал её на всех пяти уровнях усилия рассуждений: low, medium, high, xhigh и max. Полностью отключить рассуждения у модели нельзя, а повышение уровня делает генерацию непропорционально дороже и медленнее: от центов и секунд на нижних ступенях до долларов и десятков минут на максимальной. Лучший результат среди всех моделей Anthropic автор получил на уровне max и по просьбе комментатора Hacker News анимировал его той же моделью. Одновременно Anthropic называет Fable 5.1 новой планкой для кодинга: на свежем бенчмарке Terminal-Bench-Science 0.1 модель более чем удвоила результат предыдущей версии семейства.
Что произошло
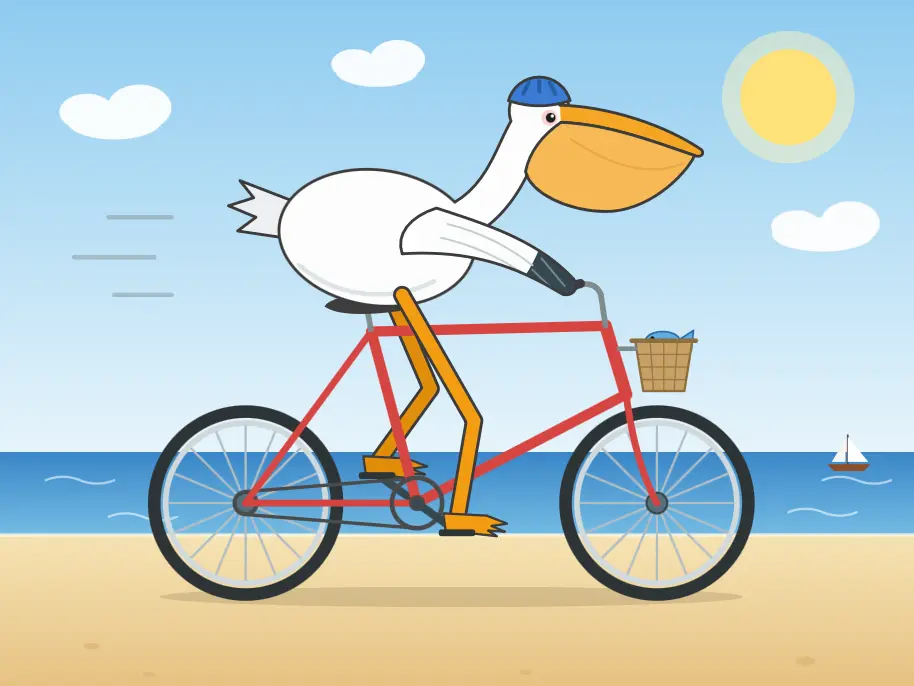
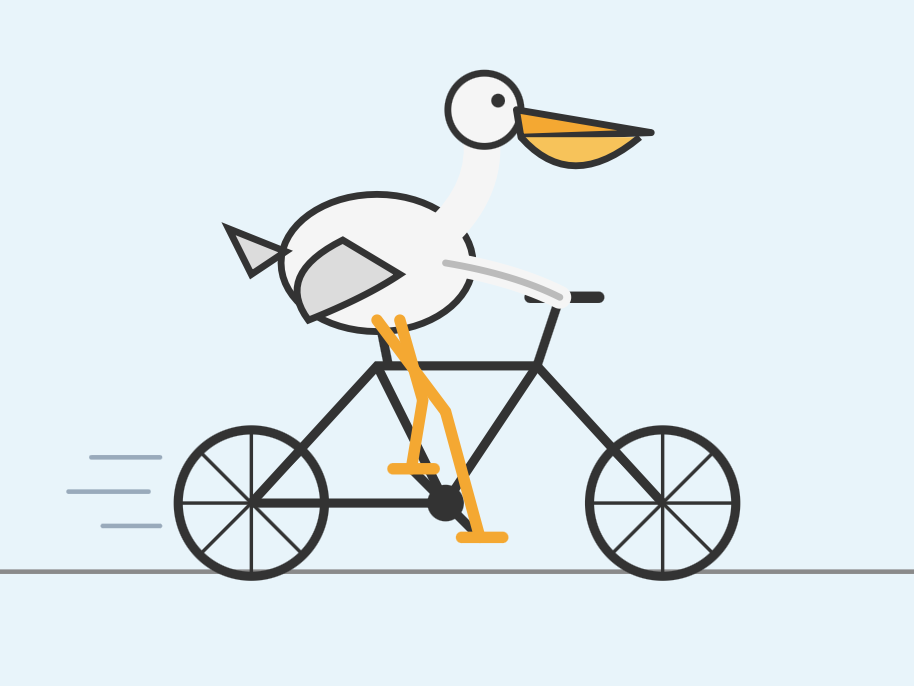
Уиллисон отправил модели один и тот же промпт «Generate an SVG of a pelican riding a bicycle» на уровнях low, medium, high, xhigh и max и опубликовал все пять результатов вместе с транскриптами. Рост уровня нелинеен: ступень xhigh обошлась в $1,83 и 7 минут 51 секунду за 36 767 токенов, а max потребовал уже 65 927 токенов. Автор отмечает загадку: на low и medium в транскриптах вообще не видно следов рассуждений. Пеликан уровня max он признал лучшим среди всех моделей Anthropic, а по просьбе комментатора swalsh с Hacker News анимировал его той же моделью за $1,37 — 6121 входной и 26 201 выходной токен; в конвертированном в MP4 ролике колёса крутятся «не в ту сторону» из-за конвертации.
Контекст
Тест «пеликан на велосипеде» Уиллисон использует как быстрый ad-hoc эвал: по одной SVG-картинке видно, насколько аккуратно модель следует инструкции и работает с векторной графикой. Вторая часть контекста — позиционирование самой модели: Anthropic продвигает Fable 5.1 как новую планку для кодинга, и на бенчмарке Terminal-Bench-Science 0.1, анонсированном 27 августа 2026 года, она набирает 52,6% против 24,7% у предыдущей версии семейства. Для ориентира, GPT-5.6 Sol на том же бенчмарке даёт 22,4%, а Opus 5 — 29,0%. Шкала усилия рассуждений при этом превращается в ключевую характеристику модели: именно она, а не только «сырая» версия модели, определяет итоговое качество и поведение.
Почему это важно для индустрии
Уровень усилия рассуждений стал главным регулятором стоимости, задержки и качества у Claude: одна и та же задача обходится от ~10 центов на low до $3,30 на max, а разрыв между high и xhigh/max достигает примерно 14–50 раз по объёму токенов. Режима без рассуждений больше нет, поэтому конфигурации «дёшево и без раздумий» у модели просто не существует. Для компаний это одновременно рычаг и риск: маржинальность выжимается роутингом effort — low и medium для интерактивных и массовых сценариев, xhigh и max только для фоновых тяжёлых задач, — а селектор усилия уже можно выносить в интерфейс как слайдер «быстро и дёшево ↔ медленно и дорого», при том что бюджет зависит от ценовой политики вендора. Скачок на Terminal-Bench-Science 0.1 внутри одного семейства — редкий случай, когда громкий бенчмарк сопровождается наглядной демонстрацией, и если независимые повторения подтвердят цифры, внутрифирменные скачки такого масштаба сдвинут базовые линии в кодинг-агентах. Ещё один отраслевой урок — быстрое старение ad-hoc эвалов: визуальный тест, работавший в 2025 году, к июлю 2026-го перестал коррелировать с общей силой модели, поэтому сравнения всё чаще имеет смысл вести внутри одного семейства и между уровнями усилия.
Почему это важно для пользователей
Материал полностью воспроизводим: все версии пеликанов с полными транскриптами рассуждений собраны в gist автора, а повторить опыт можно одной командой llm -m claude-fable-5.1 через его утилиту llm. MP4-версия анимации приложена прямо к посту, так что уровень анимации, созданной одним промптом, можно оценить глазами. Читателям, планирующим работу с моделью, стоит прикидывать бюджет заранее: интерактивные сценарии на low и medium укладываются в центы, а тяжёлые фоновые задачи на xhigh и max требуют долларов за прогон и заметного ожидания. Наконец, сравнение картинок по уровням в том же gist — наглядный ориентир для тех, кто решает, оправдана ли переплата за старшие ступени.
Что пока неизвестно / ограничения
Пеликан — это одна субъективная оценка одного автора на одном промпте, и сам Уиллисон признаёт, что тест больше не коррелирует с общей силой модели, так что «лучший пеликан» не доказывает превосходства Fable 5.1 за пределами её семейства. Цифры Terminal-Bench-Science 0.1 пока не подтверждены независимо: бенчмарк анонсирован 27 августа 2026 года, за несколько дней до публикации, методология в источнике не раскрыта, а кросс-семейные сравнения уязвимы к подбору выгодных условий. Прозрачность нижних уровней тоже под вопросом: на low и medium в транскриптах нет следов рассуждений, поэтому проверить, что именно делает модель, невозможно. Наконец, замеры цены и времени сделаны третьей стороной на одной задаче — генерации SVG, — и на других типах нагрузок экономика может отличаться.
Источники
- Claude Fable 5.1 made me a really nice animated pelican — Simon Willison's Weblog
- Hacker News discussion: Claude Fable 5.1 made me a nice animated pelican
- Gist: full set of Fable 5.1 pelicans with reasoning transcripts (simonw)
Автор
Look at AI, редакция