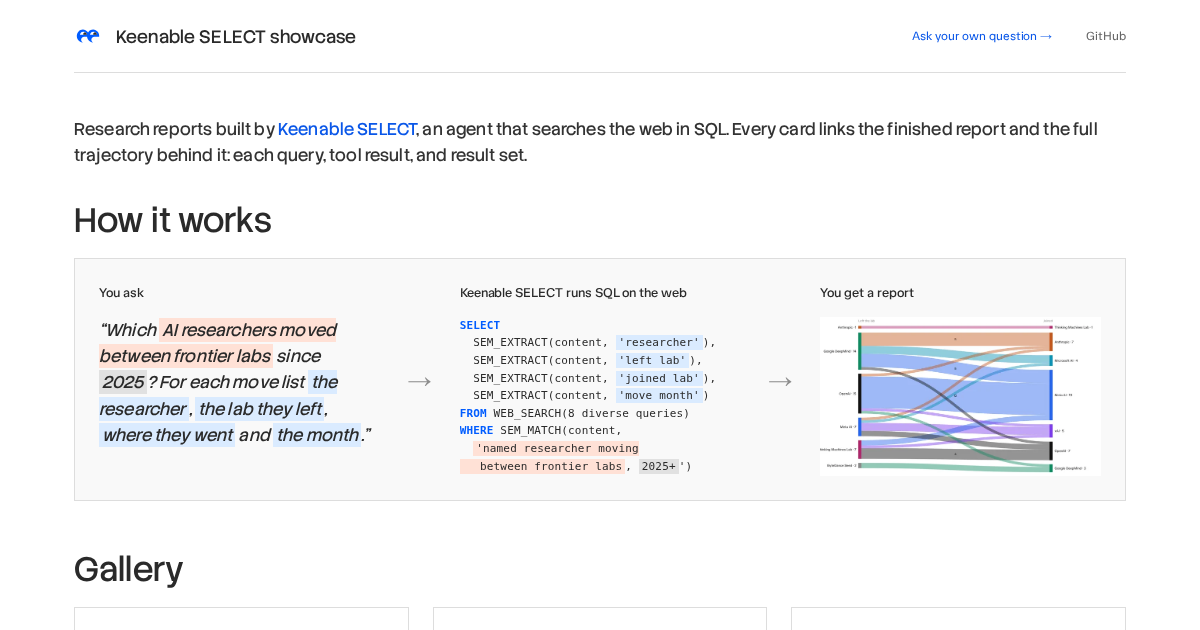
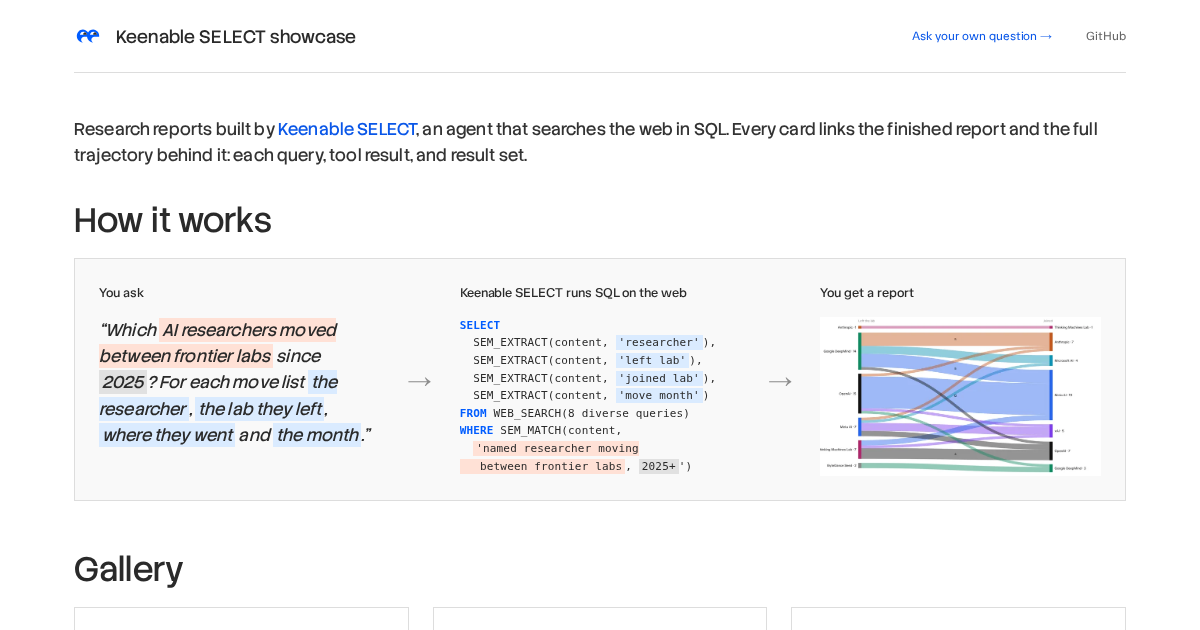
Стартап Keenable переименовал свой инструмент Web Query Language (WebQL) в Keenable SELECT и открыл к нему публичный доступ. Продукт позволяет выполнять read-only SQL-запросы к живому вебу поверх DuckDB, совмещая точную фильтрацию с семантическими операторами, и возвращает таблицы полей со ссылками на источники вместо обычной стены ссылок. До конца сентября доступ бесплатный — с лимитом в две одновременные сессии.
Что произошло
Продукт, ранее известный как Web Query Language (WebQL), оформлен как MCP-сервер с двумя методами: select выполняет одно read-only SQL-предложение к живому вебу поверх DuckDB, а generate_html_report публикует готовый HTML-отчёт с таблицами и источниками. В SQL-диалект встроены операторы WEB_SEARCH и WEB_FETCH, а также семантические SEM_EXTRACT, SEM_MATCH, SEM_SCORE и SEM_NORM; точные фильтры срабатывают раньше LLM-операторов, поэтому, по заявлению разработчика, один запрос способен обойти более 1000 страниц, а построчная семантическая обработка оплачивается только для выживших строк. Результат каждого запроса сохраняется как именованный result set, на который опираются последующие запросы и агент отчётов; сам ресёрч ведёт агент-исследователь на большой модели Sol, а отчёты генерирует серверная модель Fable. Инструмент доступен в каталоге коннекторов Claude и подключается к Claude Code, Codex и Cursor; в галерее showcase уже опубликованы 24 примера с полными траекториями запросов.
Контекст
Паттерн «веб как таблица» возник как ответ на экономику агентного ресёрча: в классическом цикле поиск отдавал агенту около десяти ссылок, и большая модель тратила дорогой контекст на чтение каждой по очереди. SELECT переносит это чтение внутрь SQL-движка, воспроизводя на веб-корпусе классическую selectivity-first оптимизацию из баз данных: сначала выполняются дешёвые точные операции, и только выжившие строки достаются дорогим семантическим вычислениям — один вызов маленькой проприетарной модели на строку. Слой построен поверх открытого протокола MCP, поэтому работать с ним могут любые совместимые агентные клиенты, а не один закрытый продукт. Показательно и то, что каждый прогон оставляет проверяемый след: именованные result set'ы и полные траектории запросов в галерее примеров — редкий для продуктов уровень прозрачности.
Почему это важно для индустрии
Для индустрии главный сдвиг в том, что чтение поисковой выдачи уходит из дорогостоящего контекста агента внутрь самого запроса: при высокой селективности фильтров падают и расход контекста, и стоимость глубокого веб-обхода, потому что большая модель больше не читает каждую ссылку по очереди. Это практическая стандартизация паттерна «веб как таблица» поверх открытого протокола MCP — шаг к превращению этапа «агент читает ссылки» в дешёвый табличный примитив агентных архитектур. Для билдеров SELECT — готовый бэкенд «поиск плюс извлечение полей»: не нужно собирать собственную обвязку вокруг поисковых API и экстракторов, а именованные result set'ы позволяют строить многошаговые пайплайны и дашборды. Поскольку MCP делает копирование дешёвым, приживись паттерн — аналогичные семантические SQL-слои к вебу и дата-озёрам вероятны и в других стеках, а точкой отсчёта для сравнения могут стать операторы SEM_EXTRACT и SEM_MATCH.
Почему это важно для пользователей
Окно бесплатных экспериментов открыто до конца сентября при лимите в две одновременные сессии. Задать вопрос в натуральном языке можно на странице https://app.keenable.ai/select/start, а MCP-сервер https://select.keenable.ai/mcp подключается одной командой claude mcp add в Claude Code, Codex или Cursor — результатом будут таблицы полей с источниками вместо стены ссылок. Лимита достаточно для прототипов и пет-проектов. Типовые задачи — таймлайны релизов LLM, атласы, орг-схемы — уже разобраны в галерее showcase, где для каждого прогона указано число сообщений и SQL-запросов; по этим траекториям можно калибровать ожидания и за вечер проверить на собственных задачах, сколько на самом деле стоит глубокий веб-обход.
Что пока неизвестно / ограничения
Ключевые заявления пока остаются вендорскими декларациями без методологии: цифра «более 1000 страниц» не подкреплена раскрытым распределением селективности фильтров, критериями остановки обхода и определением того, что считается пройденной страницей. Публичных бенчмарков качества web-as-table извлечения нет; экстрактор — маленькая проприетарная модель без раскрытых размеров и происхождения, а у моделей Sol и Fable не опубликованы ни архитектуры, ни измерения качества. Галерея showcase составлена самим разработчиком без раскрытых критериев отбора задач, поэтому по ней нельзя судить о средней сложности прогона. Неизвестны прайсинг после окончания бесплатного периода и поведение продукта под продакшн-нагрузкой; открытыми остаются вопросы надёжности SEM-операторов на нестационарном вебе и устойчивости цепочки к prompt injection из скачанных страниц.
Источники
- Keenable SELECT — продуктовая страница: демо, MCP-интеграции, бесплатный доступ до конца сентября
- Keenable SELECT: an agent that searches the web in SQL — галерея showcase из 24 отчётов с полными траекториями
- Keenable SELECT — публичный MCP-сервер
Автор
Look at AI, редакция