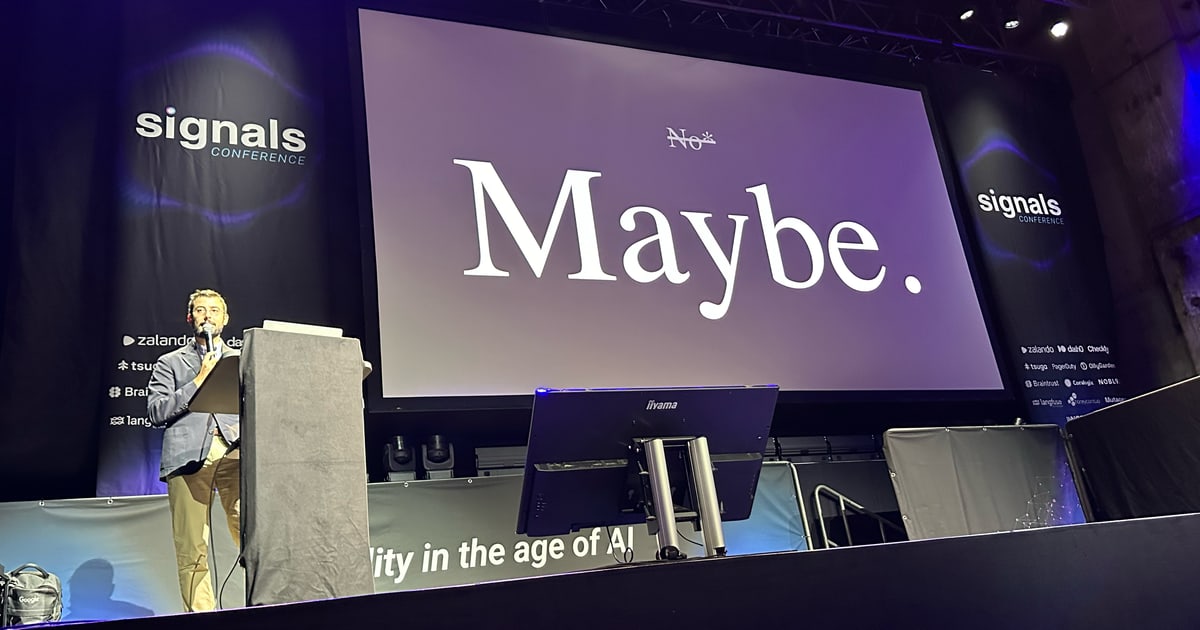
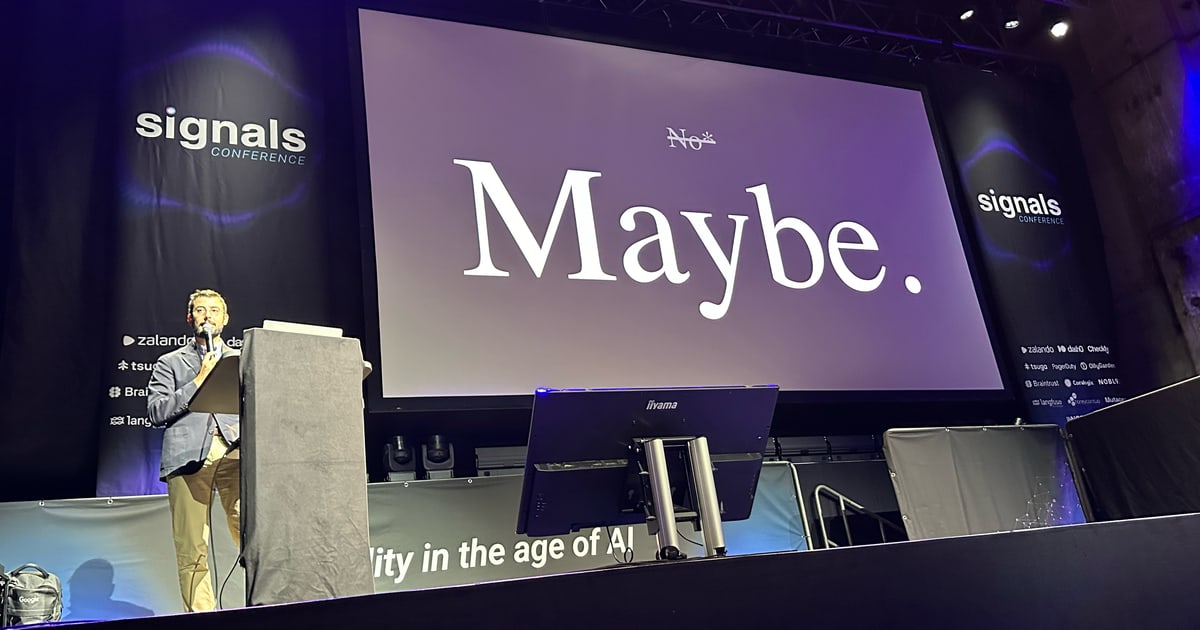
Алекс Палкуие, инженер надёжности Anthropic, который отвечает за доступность самой Claude, на конференции Signals Berlin впервые сменил ответ на вопрос «может ли Claude чинить саму себя» с «нет» на «возможно». Основанием стали три продакшн-инцидента: модель нашла причину массовых HTTP 500 у Claude Opus, вскрыла кампанию злоупотребления аккаунтами и локализовала отказ инференс-роутера по физически невозможным метрикам. При этом в одном из кейсов Claude увела инженеров по ложному следу, а все действия в продакшне по-прежнему требуют одобрения человека.
Что произошло
В марте на QCon London Палкуие отвечал на этот вопрос «нет», на Signals Berlin он впервые сказал «возможно» и разобрал три реальных инцидента. В новогоднюю ночь Claude Code нашла причину HTTP 500 у Claude Opus: баг в предобработке изображений, при этом во всех сбойных запросах было ровно 22 картинки. Модель не остановилась на баге и связала 200 аккаунтов, отправлявших такие запросы, с партией из 4000 аккаунтов, созданных тремя днями ранее по одному шаблону email; команда safeguards подтвердила злоупотребление. Во втором инциденте Claude заметила, что инференс-роутер выводит из ротации здоровый кластер, потому что метрики показывали физически невозможное число токенов в секунду: после решардинга коллекционеров два шарда в течение пяти минут скрейпили одни и те же серверы, и мониторинг давал искажённые данные. В третьем случае, при всплеске ошибок до 41%, модель указала на падение local cache hit rate, хотя запросы брали данные из shared cache: реальной причиной были перегруженные серверы, и responders ушли по ложному следу.
Контекст
Оценка весомее, чем кажется: Палкуие — staff-инженер с восемью годами в Google, его работа в Anthropic состоит в том, чтобы Claude оставалась доступной, и у него есть доступ к лучшим моделям компании и «почти неограниченным» токенам. Поэтому его вердикт задаёт реалистичный потолок для всего направления AI SRE. Кейсы укладываются в цикл OODA: модель уже надёжно работает в фазах observe и decide — читает логи со скоростью ввода-вывода, параллельно проверяет несколько гипотез и цепляется за жёсткие инварианты вроде точного совпадения параметров сбойных запросов или физически невозможных значений метрик. Слабое звено — фаза orient: там, где жёстких инвариантов нет, модель опирается на корреляции и может ошибаться. Главный барьер для автономии при этом не модель, а контекст: инструментация кода и инфраструктуры под агентный доступ, security-ограничения на доступ, знания, живущие только в головах инженеров, и стоимость логов — инженеры жаловались, что отправка логов приложений в Datadog превышала бюджеты.
Почему это важно для индустрии
Для индустрии это рыночный сигнал: AI SRE выходит из фазы первых демонстраций, наблюдение и диагностика уже автоматизируются в реальном продакшне, а узкое место сместилось из модели в контекст и в границу одобрения человеком. Конкуренция смещается с «какая модель» на «какой контекст»: инструментация для агентского доступа к коду и инфраструктуре, машиночитаемые инварианты в метриках, управление стоимостью логов. Путь к большей автономии Палкуие видит через production action classifier — классификатор, который автоматически одобряет рутинные операции и эскалирует рискованные человеку. Практичный продукт сегодня — «triage-assist» без права на действия: агент читает логи и формирует несколько гипотез с доказательствами, человек подтверждает вывод. Если появятся систематические evals для инцидент-агентов, особенно для фазы orient на исторических инцидентах, они станут главным фильтром между маркетингом и реальной способностью моделей.
Почему это важно для пользователей
Читателям, пробующим агентов в разборе инцидентов, кейсы дают рабочее правило: наблюдению агента доверять можно, финальному выводу — нет. Claude читает логи со скоростью ввода-вывода и параллельно проверяет несколько гипотез, что ускоряет triage, но её вывод должен подтверждать человек: в третьем кейсе убедительная корреляция уведёт responders от перегруженных серверов, если не проверить её против инвариантов. Работает и правило бывшего менеджера Палкуие в Google Стива Макги: «график без явной причины — это не проблема». При этом суперспособность агента сканировать больше графиков статистически повышает шанс найти ложный паттерн, поэтому каждый подозрительный сигнал стоит проверять на физическую корректность метрик. Автономное «самолечение» продакшна разворачивать пока нельзя: все прод-действия в разобранных кейсах требовали одобрения человека.
Что пока неизвестно / ограничения
Это три отобранных кейса, рассказанных сотрудником Anthropic о моделях Anthropic, то есть self-report с отбором в сторону успехов. Нет знаменателя: неизвестно, сколько всего инцидентов было за тот же период и в скольких модель не помогла или ошиблась. Систематических evals для инцидент-агентов пока не существует, поэтому «возможно» остаётся экспертной оценкой практикующего инженера, а не измеренной характеристикой. Третий кейс показывает, что фаза orient может давать сбой на правдоподобных корреляциях, а граница автономии в этих данных не сдвинулась: любые действия в продакшне по-прежнему требуют человека.
Источники
- Can Claude fix itself? From no to maybe — блог Sylvain Kalache
- Fixing Claude with Claude: Anthropic reports on AI SRE (The Register, о мартовском докладе Палкуие на QCon London)
- Обсуждение Can Claude fix itself? на Hacker News
Автор
Look at AI, редакция